
Aller au contenu
Retour au blog

Outils de récupération de contenu : optez pour la fidélité du texte

Robert MunceanuDernière mise à jour le 16 min read
Outils de récupération de contenu : optez pour la fidélité du texte
En bref : optez pour un extracteur de contenu principal destiné aux articles provenant de sites web variés, et pour une bibliothèque de sélecteurs lorsque vous maîtrisez les règles d’extraction pour des modèles connus. Évaluez séparément les paragraphes manquants, les passages standard indésirables, l’exactitude des métadonnées et la structure préservée avant d’adopter un outil.

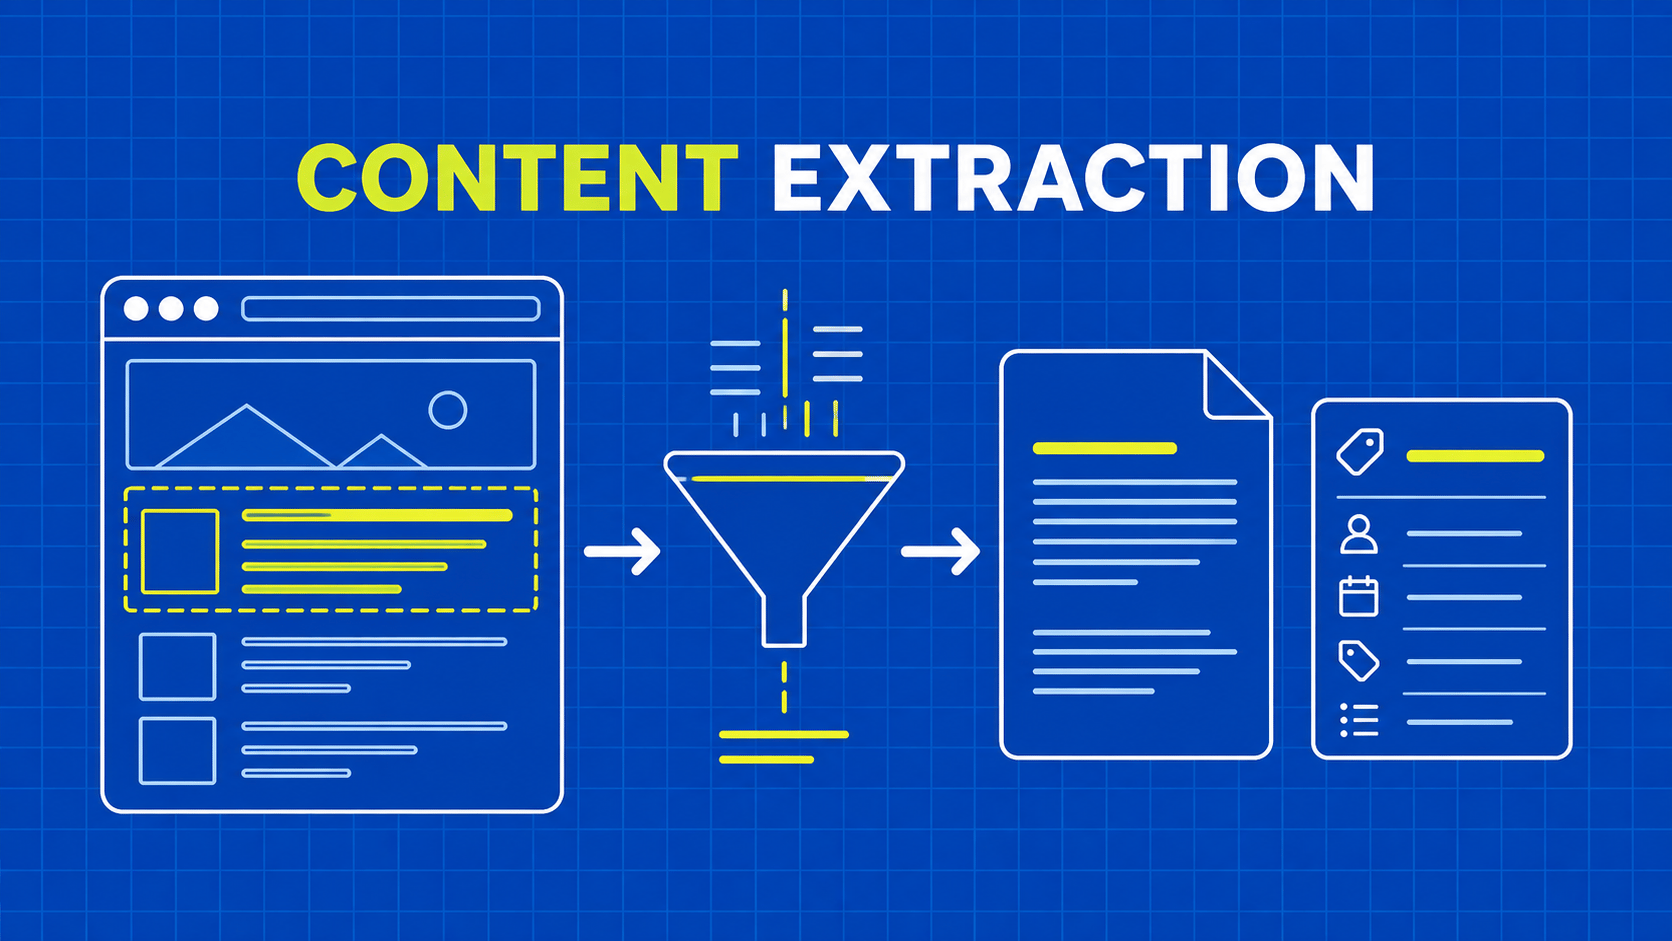
Un article extrait qui perd sa qualification finale peut être plus trompeur qu’un résultat vide. Les outils d’extraction de contenu aident à transformer le balisage d’une page web en texte utile, mais la qualité de cette transformation dépend de ce que votre projet doit préserver. Un index de recherche, une interface de lecture et des archives de recherche ne nécessitent pas forcément le même résultat.

Commencez par le document que vous devez produire. Si vous souhaitez extraire l’article principal de nombreux éditeurs, l’extraction automatique du contenu principal constitue un point de départ utile. Si vous recherchez une description exacte, un tableau de spécifications ou la signature d’un auteur à partir d’un modèle connu, les sélecteurs explicites vous offrent davantage de contrôle. Aucune de ces deux approches ne permet de corriger une réponse en amont contenant un écran de consentement à la place de la page demandée.

Ce guide compare quatre bibliothèques reconnues en fonction de leurs capacités réelles. Il développe ensuite un processus d’évaluation reproductible que vous pouvez utiliser avec vos propres pages. L’objectif est de parvenir à un choix justifiable pour votre corpus, avec une gestion claire des échecs, plutôt qu’un classement universel ou une affirmation non étayée selon laquelle un extracteur comprendrait tous les sites web.

Comparez les outils de scraping de contenu en fonction du travail qu’ils effectuent

L'extraction du contenu principal vise à identifier le contenu central d'un document tout en excluant les éléments d'interface environnants. Une bibliothèque d'analyse HTML expose l'arborescence du document afin que vous puissiez mettre en œuvre vos propres règles de sélection. Les deux peuvent produire du texte, mais elles répondent à des questions différentes : où se trouve probablement l'article, par opposition aux éléments qui correspondent aux règles que vous avez fournies.

Outil

Approche principale

Point de départ utile

Responsabilité qui vous incombe

Trafilatura

Extraction automatique de texte et de métadonnées

Un pipeline Python collectant des articles présentant différentes mises en page

Valider le texte conservé, configurer les éléments facultatifs et gérer les échecs de récupération

Mozilla Readability

Extraction d’articles orientée lecteur à partir d’un document DOM

Une application JavaScript générant un contenu d'article lisible

Fournir un document, valider le résultat et nettoyer le code HTML avant de l'afficher

Beautiful Soup

Interface Python pour la recherche et la navigation dans du code balisé analysé

Modèles connus nécessitant des règles personnalisées précises

Définir les limites du contenu et la politique de sélection des métadonnées

Cheerio

Analyse de balisage JavaScript avec parcours basé sur des sélecteurs

Pipelines Node.js extrayant des éléments spécifiés

Définir des règles d’extraction et obtenir tout contenu rendu requis

Il s’agit d’une comparaison des responsabilités, et non d’un test de performance. Le choix approprié peut varier au sein d’un même projet. Un extracteur automatique peut traiter un corpus d’actualités généraliste, tandis qu’un petit ensemble de règles personnalisées permet de traiter des pages de documentation comportant des encadrés récurrents et des exemples de code importants.

Pour les outils de scraping de contenu, le premier critère de sélection le plus utile est le coût lié à la gestion des exceptions. Un flux au champ d’application restreint peut justifier l’utilisation de sélecteurs détaillés, car l’ensemble des modèles est réduit. Un crawl de grande envergure peut nécessiter une extraction automatique accompagnée d’une file d’attente de révision, car chaque nouvel éditeur introduit un balisage inconnu. La préférence linguistique a son importance, mais la capacité de l’équipe à diagnostiquer un résultat erroné est encore plus déterminante.

Considérez la récupération séparément lorsque vous évaluez ces choix. Notre guide sur les clients HTTP Python vous aide pour la couche de requête ; les bibliothèques comparées ici doivent être jugées sur ce qu’elles font avec le document qu’elles reçoivent.

Utilisez l’extraction automatique lorsque les mises en page varient

Trafilatura fournit un package Python et une interface en ligne de commande pour extraire le texte principal et les métadonnées. Sa documentation décrit la possibilité de conserver, en option, des éléments tels que les liens, les images et les tableaux, ainsi que des formats de sortie incluant le texte brut, Markdown, JSON et XML. Ces options en font un candidat utile lorsqu’un corpus doit prendre en charge plusieurs représentations en aval. Documentation de Trafilatura.

Un essai judicieux commence par la sortie la plus simple que votre application puisse utiliser. Pour un index de mots-clés, le texte brut peut suffire. Pour un système de réponses nécessitant le contexte d’une section, conservez les titres et les délimitations de paragraphes. Pour une archive, conservez une représentation plus riche en plus du texte plutôt que de partir du principe que le format le plus compact est toujours le meilleur.

Mozilla Readability est la bibliothèque d’extraction autonome utilisée pour le mode « Reader View » de Firefox. Elle accepte un document DOM et peut renvoyer du code HTML traité, du texte, le titre, la signature et d’autres propriétés de l’article. Sa documentation explique également que l’analyse modifie le document fourni ; il faut donc lui transmettre un clone lorsque vous avez besoin de l’arborescence d’origine pour d’autres traitements. Documentation de Readability.

Ces éléments suggèrent un cas d’utilisation pratique en JavaScript : une interface de lecture peut conserver un document intact pour l’inspection des métadonnées tout en transmettant une copie à l’extracteur d’articles. Votre validation doit néanmoins vérifier si les légendes, les listes et les courts paragraphes de conclusion ont été conservés. Un résultat visuellement plausible ne prouve pas que tous les passages significatifs ont été conservés.

Les outils de scraping automatique de contenu doivent disposer d’une politique de repli explicite. Si l’extraction ne renvoie rien, ne remplacez pas silencieusement tout le texte visible de la page. Cela pourrait transformer la navigation, les invites de connexion ou les messages d’erreur en contenu d’article apparent. Conservez l’état d’échec, inspectez la réponse source, puis déterminez si la page nécessite une récupération différente, une règle spécifique au modèle ou une exclusion du corpus.

Utilisez des sélecteurs lorsque les limites du contenu sont connues

Beautiful Soup propose des méthodes Python pour rechercher et parcourir des arborescences HTML ou XML. Sa documentation explique comment le choix de l’analyseur syntaxique peut affecter l’arborescence générée à partir d’un balisage mal formé. Ce détail est important lorsqu’une règle fonctionne dans un environnement mais sélectionne des éléments différents après déploiement. Documentation de Beautiful Soup.

Utilisez cette catégorie d’outils lorsque le contenu requis possède une limite identifiable : un conteneur d’article désigné, une description de produit particulière ou une section de documentation. Notez pourquoi cette limite est fiable. Un conteneur sémantique qui renferme systématiquement le contenu requis constitue un point de départ plus solide qu’un nom de classe généré observé sur une seule page.

Cheerio fournit une API JavaScript permettant de parcourir et de sélectionner le balisage analysé. Il ne rend pas le CSS, ne charge pas les ressources externes de la page comme le fait un navigateur, ni n’exécute le JavaScript de la page. Si le contenu n’apparaît qu’après une exécution côté client, le code HTML requis doit provenir d’une étape de récupération ou de rendu appropriée avant que les règles de sélection puissent le détecter. Présentation de Cheerio.

Les outils de scraping de contenu basés sur des sélecteurs vous offrent un chemin d’inspection clair : trouvez le conteneur sélectionné, inspectez ses éléments enfants et comparez le résultat avec les exigences. Ce contrôle est précieux pour les tableaux et autres contenus structurés. Il engendre également un travail de maintenance chaque fois que les éditeurs modifient la relation entre l’élément sélectionné et le contenu significatif.

Évitez de définir la réussite comme une sélection non vide. Un site peut réutiliser une ancienne classe pour un widget de recommandation, ce qui rend votre règle techniquement réussie mais sémantiquement erronée. Validez le texte représentatif, les titres obligatoires et la relation entre le titre et le corps du texte. Conservez un état explicite de « modèle inconnu » lorsque ces vérifications échouent. L’ajout d’un deuxième sélecteur large doit constituer une exception soumise à révision, et non une réponse automatique à chaque champ manquant.

Préservez le sens avant de réduire le document

Prenons l’exemple d’un article fictif sur une police d’assurance comportant un titre, une date d’entrée en vigueur, trois conditions et une phrase finale limitant ces conditions à une région spécifique. Une extraction en texte brut qui conserve les conditions mais perd la phrase finale en modifie le sens pratique. Vos critères d’acceptation doivent donc aller au-delà du simple décompte de mots.

Élément

Ce qui peut mal tourner

Contrôle d’acceptation utile

Paragraphes

Une précision courte mais importante disparaît

Marquer les passages requis et vérifier que chacun d’entre eux est bien présent

Titres

Les limites des sections se confondent en un seul bloc de texte

Vérifiez l'ordre des titres et le groupe de paragraphes situé sous chaque titre

Listes

Les alternatives distinctes forment une séquence apparente

Conservez les délimitations des listes et distinguez les éléments ordonnés de ceux qui ne le sont pas

Tableaux

Les valeurs perdent leurs libellés de colonne ou de ligne

Vérifier les associations étiquette-valeur dans la représentation exportée

Liens

Les destinations relatives ne sont plus résolues correctement

Enregistrez ou résolvez les destinations par rapport à l’URL de la page source

Légendes

Une légende est dissociée de son image

Conservez une association explicite lorsque les images sont importantes pour le cas d’utilisation

Considérez ce tableau comme une proposition de conception de test, et non comme une affirmation selon laquelle une bibliothèque nommée échouerait à ces cas. Certains projets excluent délibérément les images ou les tableaux. Cela est acceptable lorsque cette omission fait partie du contrat de sortie documenté et ne nuit pas à l’usage prévu.

Le format Markdown permet de préserver une structure lisible, mais ne garantit pas la fidélité. Vérifiez comment les listes imbriquées, les cellules multilignes et l’indentation du code résistent à la conversion. Le texte brut peut convenir à la classification tout en restant inadapté à une interface de lecture. Enregistrez le nom de la représentation et la version de conversion avec le résultat afin que les utilisateurs sachent ce qu’ils ont reçu.

Les outils d’extraction de contenu doivent également distinguer un document vide d’un document non pris en charge. Une brève annonce peut constituer un contenu valide même si elle comporte moins de mots qu’un article d’actualité classique. Une page de référence composée uniquement de tableaux peut nécessiter un parcours d’extraction différent. Définissez ces catégories avant de choisir un filtre universel basé sur une longueur minimale.

Lorsque vous développerez ultérieurement un robot d’indexation axé sur l’extraction, veillez à séparer ces règles relatives aux documents de la planification et de la découverte de liens. Le guide du workflow Scrapy traite de cette couche de collecte plus générale.

Considérez les métadonnées comme des preuves accompagnées d’une source

Un titre extrait d’une page est une valeur potentielle, et non un fait incontestable. Le titre d’un navigateur peut contenir un suffixe de site, un en-tête visible peut être abrégé, et un titre issu de données structurées peut décrire un objet associé. Établissez une politique de priorité basée sur le corpus et consignez quelle source a fourni la valeur sélectionnée.

Pour les auteurs, préservez la distinction entre une personne, une rédaction et un éditeur. Le nom d’une organisation figurant dans un pied de page ne doit pas devenir l’auteur simplement parce que la véritable signature est absente. Conservez une valeur manquante lorsque vous ne pouvez pas établir la relation. Un ensemble de données d’apparence propre mais rempli de valeurs par défaut inventées est difficile à corriger par la suite.

Les dates méritent des champs distincts pour la publication, la modification et la récupération. L'heure de récupération relève de votre processus de collecte et ne doit en aucun cas remplacer une date de publication manquante. Conservez la chaîne de date d’origine parallèlement à une valeur normalisée lorsque l’ambiguïté est importante. Une date écrite avec le mois et le jour sous forme numérique peut nécessiter un contexte dont un analyseur syntaxique générique ne dispose pas.

Enregistrez l’URL source, l’URL de réponse finale, l’horodatage d’extraction et la version de l’extracteur pour chaque document. Ajoutez toute URL canonique disponible en tant que candidate distincte plutôt que de remplacer immédiatement l’identité de l’observation. Cela vous permet d’étudier les redirections et les pages en double sans perdre de vue l’endroit où le contenu a réellement été récupéré.

La question pertinente pour les outils de scraping de contenu n’est pas simplement de savoir s’ils renvoient des métadonnées. Il s’agit de déterminer si votre pipeline est capable d’expliquer chaque champ important. L’ensemble d’évaluation doit inclure des exemples d’enregistrements comportant des auteurs manquants, des dates multiples, des titres traduits et des balises canoniques incohérentes. Examinez ces cas indépendamment de la qualité du corps du texte afin qu’un extracteur d’articles performant ne masque pas des décisions erronées en matière de métadonnées.

Constituez un petit ensemble d’évaluation qui met en évidence les erreurs

Utilisez du code HTML enregistré provenant de pages que vous êtes autorisé à traiter, avec un contexte de récupération consigné. Incluez les pages courantes que votre système rencontrera le plus souvent, puis ajoutez délibérément des exemples complexes : annonces courtes, longs articles, listes imbriquées, tableaux, articles comportant de nombreuses légendes et pages comportant plusieurs blocs de type article. Conservez un ensemble distinct des échecs de récupération.

Pour chaque document, annotez les passages qui doivent être conservés et les zones qui doivent être supprimées. Vous n’avez pas besoin d’une plateforme de notation sophistiquée pour commencer. Une feuille de calcul indiquant l’URL source, la famille de modèles, les passages requis, le contenu indésirable et les notes de révision permet de rendre la comparaison reproductible.

Testez chaque candidat par rapport à la même entrée enregistrée. Cela permet d’isoler la qualité de l’extraction des variations liées au réseau. Si un candidat reçoit du code HTML rendu et qu’un autre reçoit une réponse minimale, le résultat permet de comparer les stratégies d’acquisition ainsi que les extracteurs. Cela peut s’avérer utile par la suite, mais cela ne permet pas de déterminer quelle bibliothèque traite le mieux un document donné.

Mesurez séparément les omissions et les éléments indésirables. Oublier une qualification et conserver une invitation à s’abonner sont des erreurs différentes ayant des conséquences différentes. Ajoutez des vérifications de structure pour les documents dont le sens dépend des titres, des listes ou des tableaux. Évaluez les champs de métadonnées individuellement plutôt que de valider globalement un enregistrement simplement parce que son titre semble correct.

Prévoyez un examen manuel des échecs et un échantillon aléatoire de succès apparents. Une vérification de la longueur minimale du texte peut rejeter les sorties vides tout en approuvant un long menu de navigation. C’est en échantillonnant les enregistrements réussis que l’on découvre les erreurs que les règles automatisées n’avaient pas anticipées.

Enfin, excluez certaines pages de l’ensemble de réglage. Ajuster chaque règle jusqu’à ce qu’un minuscule échantillon soit validé peut aboutir à une configuration fragile. Un ensemble mis de côté vous donne une indication plus utile quant à la généralisation des choix effectués. Indiquez la composition de votre corpus de test avec les résultats ; ne présentez pas une évaluation locale comme un classement universel des outils d’extraction de contenu.

Effectuez l’extraction en rendant les états d’échec visibles

Séparez l’acquisition, l’extraction, la validation et la livraison dans vos enregistrements d’exécution. Une requête ayant échoué ne doit pas être signalée comme un défaut de l’extracteur, et une requête réussie ne doit pas être signalée comme du contenu utilisable avant la fin de la validation. Cette séparation réduit le temps passé à déboguer le mauvais composant.

Ne conservez les données brutes que lorsque votre politique de conservation l’autorise, et conservez une référence ou un hachage vous permettant d’associer une sortie à sa source. Lorsqu’une dépendance change, retraitez un échantillon contrôlé et comparez les différences significatives avant d’étendre le déploiement. Prêtez attention aux paragraphes supprimés et aux métadonnées modifiées, et pas seulement à la taille des fichiers.

Ne partez jamais du principe que le code HTML extrait peut être affiché en toute sécurité. Readability exclut explicitement la sanitisation de son objectif et recommande l’utilisation d’un outil de sanitisation pour les contenus non fiables. Ses recommandations concernant Node.js préconisent également de désactiver l’exécution des scripts source. Ces aspects sont distincts de la sélection de l’article principal. Recommandations de sécurité de Readability.

Pour une interface de lecture publique, faites de la désinfection et de la gestion des liens des étapes explicites. Pour un pipeline de traitement de texte interne, limitez la taille des entrées acceptées et enregistrez les échecs de traitement afin qu’un document exceptionnellement volumineux ne bloque pas silencieusement la file d’attente. Adaptez ces contrôles à votre déploiement réel au lieu de supposer qu’une extraction locale réussie est prête pour une utilisation sans surveillance.

Définissez des déclencheurs de révision en fonction des changements observés. Une augmentation soudaine du nombre de corps de texte vides, de paragraphes dupliqués, de dates manquantes ou d’erreurs spécifiques aux modèles mérite d’être examinée. Les outils de scraping de contenu deviennent fiables grâce à la combinaison de règles d’extraction, de tests représentatifs et de retours d’expérience opérationnels. La bibliothèque ne constitue à elle seule qu’une partie de ce système.

Points clés à retenir

  • Optez pour l’extraction automatique d’articles en cas de mises en page variées et pour des sélecteurs explicites lorsque les limites du contenu sont connues.
  • Évaluez le manque de sens, les formules toutes faites indésirables, les métadonnées et la structure comme des dimensions distinctes.
  • Comparez les candidats sur des données d’entrée identiques enregistrées avant de tester leurs pipelines de récupération plus larges.
  • Conservez la provenance et les états d’échec afin de pouvoir retracer et corriger les résultats incorrects.
  • Retestez les exemples difficiles lorsque les modèles, les dépendances ou les politiques d’extraction changent.

FAQ

Les articles extraits peuvent-ils être dédupliqués entre différentes URL ?

Oui, mais choisissez la règle d’identité adaptée à votre cas d’utilisation. Les correspondances exactes de texte normalisé permettent d’identifier les corps de texte identiques, tandis que les articles révisés nécessitent un traitement tenant compte des versions. Conservez les URL sources associées à un enregistrement de contenu partagé plutôt que de supprimer la provenance. Les contenus syndiqués, les éditions traduites et les articles mis à jour peuvent nécessiter des enregistrements distincts, même lorsque la majeure partie de leur texte se recoupe.

Dois-je traduire le texte avant ou après l’extraction ?

En règle générale, extrayez d’abord le contenu dans la langue source, puis traduisez le contenu sélectionné. Conservez l’original à côté de la traduction et enregistrez l’étape de traduction séparément. Cela permet de vérifier si une erreur provient de l’extraction ou de la traduction. Pour les corpus multilingues, testez les limites de paragraphes et l’ordre de lecture sur des langues représentatives plutôt que de vous fier uniquement à des échantillons en anglais.

Un modèle d’IA peut-il reconstituer des passages manquants ?

Un modèle ne peut pas reconstituer de manière fiable un passage que votre pipeline n’a jamais collecté. Revenez à la source ou marquez le document comme incomplet. Si vous utilisez un modèle pour classer ou résumer du texte extrait, conservez le contenu source et distinguez le résultat généré du contenu observé. Ne laissez pas des phrases générées plausibles se faire passer pour des éléments de preuve issus de la source.

Choisissez un extracteur que vous pouvez expliquer

Commencez par définir un contrat de sortie concret et un ensemble représentatif de documents. Un pipeline de corpus Python peut trouver utile un extracteur automatique ; une interface de lecture JavaScript peut préférer une sortie orientée lecteur ; un ensemble restreint de modèles peut être mieux servi par des sélecteurs explicites. Considérez ces éléments comme des hypothèses de départ et laissez l’évaluation trancher.

Le meilleur choix est celui dont votre équipe peut reconnaître, expliquer et corriger les erreurs. Examinez les passages qui disparaissent, le texte de l’interface qui subsiste et les métadonnées dont la signification est incertaine. Ces observations vous en diront plus qu’un simple décompte de fonctionnalités ou une démonstration sur une page bien présentée.

Veillez à ce que la récupération et l’extraction restent remplaçables indépendamment à mesure que le projet évolue. Si l’obtention d’un code HTML exploitable est la partie qui mobilise le plus votre temps d’ingénierie, évaluez l’API Scraper de WebScrapingAPI comme couche de récupération, puis exécutez l’extracteur de votre choix et les contrôles de validation sur le document renvoyé. Prenez votre décision en vous appuyant sur vos propres pages représentatives et vos critères d’acceptation, et conservez les éléments qui expliquent pourquoi le pipeline y répond.

À propos de l'auteur

Robert Munceanu, Développeur full-stack @ WebScrapingAPI

Robert Munceanu

Développeur full-stack

Robert Munceanu est développeur Full Stack chez WebScrapingAPI ; il participe à l'ensemble du produit et contribue à la création d'outils et de fonctionnalités fiables qui soutiennent la plateforme.

Web scraping avec AWS Lambda : guide pour Python et Java 2026
Guides

Web scraping avec AWS Lambda : guide pour Python et Java 2026

TL;DR: En bref : le web scraping avec AWS Lambda fonctionne mieux lorsque chaque invocation est courte, bien délimitée et peut faire l'objet d'une nouvelle tentative de manière indépendante. Commencez par utiliser les requêtes HTTP directes, AWS SAM et S3, puis ajoutez SQS, des conteneurs, le rendu dans un navigateur, des proxys ou une couche de récupération gérée uniquement lorsque la charge de travail démontre qu'elle en a besoin.

Suciu Dan33 min read
Lire l'article
Comment utiliser GoSpider : exploration, nettoyage des URL et extraction de données
Guides

Comment utiliser GoSpider : exploration, nettoyage des URL et extraction de données

TL;DR: En bref : GoSpider est un robot d'exploration en ligne de commande destiné à découvrir des URL, et non un outil complet de collecte de données structurées. Ce guide d'utilisation de GoSpider présente comment effectuer une exploration limitée, gérer correctement les résultats, transférer les données de Colly vers un fichier CSV, ainsi qu'une procédure de diagnostic pour les réponses 403 ou les pages nécessitant un rendu JavaScript.

Suciu Dan24 min read
Lire l'article
Comment récupérer les données de Redfin : Guide Python des données immobilières
Guides

Comment récupérer les données de Redfin : Guide Python des données immobilières

TL;DR: Redfin expose des points d'extrémité d'API cachés qui renvoient du JSON structuré pour les listes de propriétés, ce qui permet d'ignorer complètement l'analyse HTML fragile. Ce guide vous accompagne dans la construction d'un scraper Python qui extrait les données de location et de vente, effectue des recherches par emplacement, surveille les nouvelles inscriptions via des sitemaps XML et exporte des résultats propres au format CSV ou JSON.

Suciu Dan15 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.