Aller au contenu
Retour au blog

Extraire des données d'API : un premier pipeline fiable

Gabriel CiociDernière mise à jour le 14 min read
Extraire des données d'API : un premier pipeline fiable
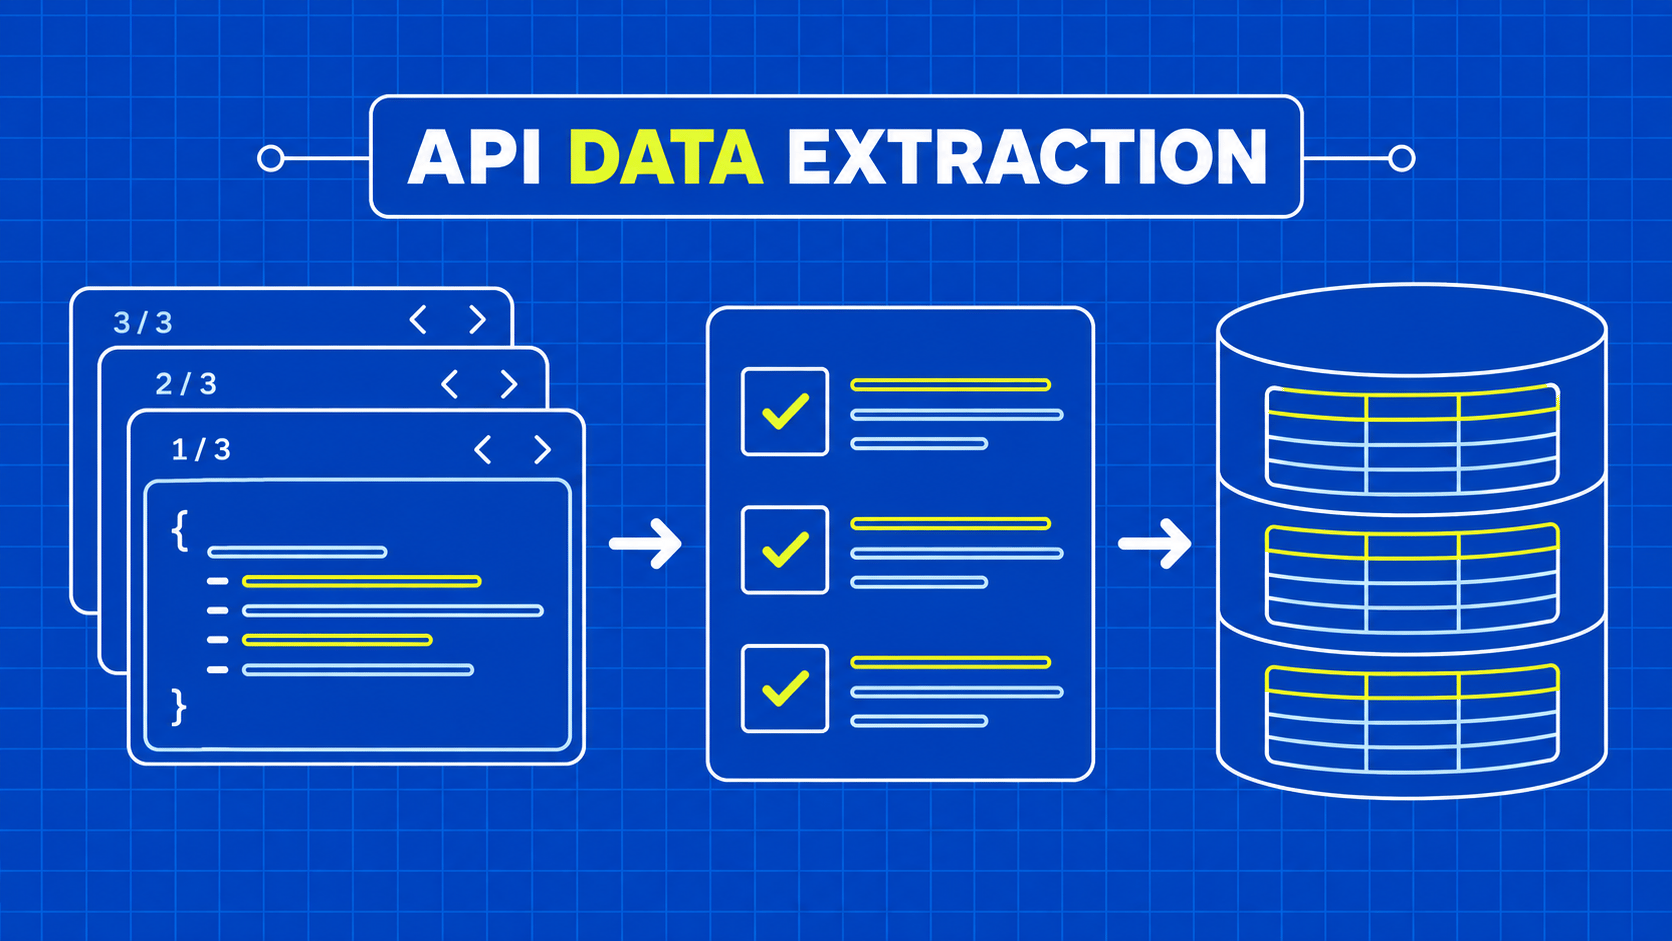
En bref : l’extraction via API est un processus qui va des requêtes documentées aux enregistrements validés. Commencez par définir un contrat de sortie minimal, testez la pagination et les cas d’échec en local, puis ajoutez un client réel, des points de contrôle durables et un rapport explicite indiquant si la collecte est terminée.

Une requête renvoie une liste de produits, votre script analyse le JSON et le terminal affiche une ligne. C’est un premier contrôle utile, mais l’extraction de données à partir d’API ne se limite pas à la réception d’une simple réponse. Un extracteur fiable doit déterminer quels enregistrements sont valides, comment poursuivre le processus et quoi signaler lorsque seule une partie de la collecte prévue est effectuée.

Ce guide élabore ces décisions autour d’un catalogue de produits fictif. L’exercice utilise un dispositif Python local plutôt qu’un service réseau, ce qui vous permet de tester la poursuite du traitement, la gestion des doublons et les enregistrements rejetés sans avoir besoin d’identifiants ni de trafic externe. Une fois ces règles opérationnelles, un véritable client HTTP peut fournir des pages via la même interface.

L’accent est mis sur la mise en œuvre plutôt que sur la terminologie. Si les méthodes, les en-têtes et les statuts de réponse vous sont encore peu familiers, le guide des API pour débutants explique ces notions fondamentales. Ici, le résultat est un petit projet d’extraction avec des conditions de réussite et d’échec observables. Vous serez en mesure de déterminer ce qui a été accepté, ce qui a été rejeté et si la condition de fin documentée par la source a été atteinte.

Planifiez l’extraction de données depuis les API autour d’un contrat de sortie

Définissez la ligne que vous comptez fournir avant de créer une boucle. Pour le catalogue fictif, chaque ligne acceptée doit comporter un identifiant de produit stable, un nom non vide, un prix sous forme d’entier non négatif exprimé en centimes et la devise EUR. Il s’agit de règles spécifiques à cet exercice, et non d’hypothèses à appliquer à tous les fournisseurs.

Séparez le contrat source du schéma de destination. La source peut représenter une somme d’argent sous forme de texte décimal, d’entier ou de valeur d’affichage formatée. Préservez explicitement cette signification lors du mappage vers la destination. Un champ nommé price ne vous indique pas en soi son unité, son traitement fiscal ou sa devise.

Décision

Exemple de règle

À éviter

Identité

Conserver l'ID du produit source

Considérer la position dans le tableau comme une clé de produit

Texte requis

Le nom doit contenir du texte sans espaces

Publication d’un champ vide comme enregistrement complet

Signification numérique

Centimes entiers dans le cadre de ce contrat de location

Deviner l'unité à partir de la valeur

Politique en matière de doublons

Conserver la première occurrence pour cet exercice

Mélange silencieux des observations contradictoires

Complétion

S'arrêter au curseur nul documenté

Considérer qu’un arrêt de budget de page est terminé

Provenance

Conserver la portée de la requête et l’heure de collecte

Perte du contexte ayant permis la sélection de ces enregistrements

La politique de déduplication mérite un choix explicite. L’exercice conserve la première occurrence valide car son modèle répète un produit identique. Un catalogue évolutif réel peut nécessiter à la place une comparaison d’horodatages ou un enregistrement de conflit. La déduplication doit mettre en œuvre la politique choisie, et non masquer les divergences entre les observations.

Lors de l’extraction de données à partir d’API, il convient de distinguer un enregistrement rejeté d’une page ayant échoué. Un élément invalide peut être mis en quarantaine tandis que d’autres éléments restent utilisables conformément à votre politique. Une enveloppe de page non reconnue peut vous empêcher de faire confiance à la fois aux éléments et à la valeur de continuation ; poursuivre aveuglément présenterait donc un risque différent.

Enfin, définissez la portée de la collecte. Enregistrez le compte, les filtres, la période et la version du point de terminaison, le cas échéant. Un enregistrement précis en dehors de cette portée reste un résultat incorrect pour la tâche.

Séparer la récupération, le décodage et l’acceptation des enregistrements

Utilisez trois frontières dans la mise en œuvre. La récupération obtient une réponse du fournisseur. Le décodage interprète la représentation. L’acceptation valide et mappe les enregistrements métier. Chaque frontière doit renvoyer un résultat utile ou un échec classifié, plutôt que de remplacer silencieusement un problème par une collecte vide.

La couche de récupération gère la requête documentée, les identifiants, les délais d’expiration de transport et le statut de la réponse HTTP. Elle doit fournir suffisamment d’éléments vérifiés pour diagnostiquer un échec. Ne confiez pas au validateur d’enregistrements la tâche de deviner si une page d’erreur HTML a été provoquée par un délai d’expiration ou par une exigence de connexion.

La couche de décodage vérifie le format et l’enveloppe attendus. L’analyse JSON établit que le texte respecte la syntaxe JSON ; elle ne prouve pas que le résultat correspond à une page de produit. La spécification JSON définit les valeurs et la structure, laissant la signification des champs au contrat d’application.

Pour cet exercice, une page comporte une items liste et une next valeur qui est soit nulle, soit une chaîne non vide. Une enveloppe inattendue entraîne l’échec de la page. Chaque élément est ensuite vérifié indépendamment par rapport aux règles du produit avant d’atteindre la sortie acceptée.

Ces limites facilitent le test de l’extraction de données à partir des API. Un test local peut remplacer la récupération de données tout en continuant à exercer la logique de décodage et d’acceptation en production. Vous pouvez reproduire une ligne mal formée ou un curseur répété sans dépendre d’un fournisseur pour générer cette condition à la demande.

Lorsque vous ajoutez un véritable client, limitez ses responsabilités. La comparaison des clients HTTP en Python est utile pour évaluer les contrôles de requêtes, mais aucune bibliothèque client ne peut déduire votre définition d’un produit valide. Conservez cette définition dans une fonction distincte et vérifiable.

Évitez également d’intercepter toutes les exceptions et de renvoyer []. Ce modèle rend l’infrastructure indisponible impossible à distinguer d’un catalogue vide valide. Un appelant doit pouvoir déterminer si le fournisseur n’a renvoyé aucun enregistrement correspondant ou si l’extracteur n’a pas pu établir un résultat valide.

Effectuez un exercice local de pagination et de validation

Enregistrez ce qui suit sous le nom extract_fixture.py et exécutez-le avec Python 3. Il utilise uniquement la bibliothèque standard et n’effectue aucune requête réseau. Les pages factices comprennent deux produits valides, un prix non valide et un doublon identique. Les assertions finales vérifient également qu’un curseur de continuation répété échoue de manière visible.

from copy import deepcopy

PAGES = {
    None: {"items": [
        {"id": "p1", "name": "Lamp", "price_minor": 2400,
         "currency": "EUR"},
        {"id": "bad", "name": "Chair", "price_minor": True,
         "currency": "EUR"},
    ], "next": "page-b"},
    "page-b": {"items": [
        {"id": "p1", "name": "Lamp", "price_minor": 2400,
         "currency": "EUR"},
        {"id": "p2", "name": "Book", "price_minor": 650,
         "currency": "EUR"},
    ], "next": None},
}

def valid_record(row):
    return (
        isinstance(row, dict)
        and isinstance(row.get("id"), str) and bool(row["id"].strip())
        and isinstance(row.get("name"), str) and bool(row["name"].strip())
        and type(row.get("price_minor")) is int
        and row["price_minor"] >= 0
        and row.get("currency") == "EUR"
    )

def collect(fetch_page, max_pages=5):
    cursor, visited, accepted = None, set(), {}
    rejected = duplicates = 0
    for _ in range(max_pages):
        if cursor in visited:
            raise ValueError("pagination cursor repeated")
        visited = visited | {cursor}
        page = fetch_page(cursor)
        if not isinstance(page, dict) or not isinstance(page.get("items"), list):
            raise ValueError("invalid page envelope")
        if "next" not in page or not (
            page["next"] is None
            or isinstance(page["next"], str) and bool(page["next"])
        ):
            raise ValueError("invalid continuation")
        for row in page["items"]:
            if not valid_record(row):
                rejected += 1
            elif row["id"] in accepted:
                duplicates += 1
            else:
                accepted = {**accepted, row["id"]: dict(row)}
        cursor = page["next"]
        if cursor is None:
            return list(accepted.values()), rejected, duplicates
    raise ValueError("page budget exhausted before completion")

rows, rejected, duplicates = collect(lambda cursor: deepcopy(PAGES[cursor]))
assert [row["id"] for row in rows] == ["p1", "p2"]
assert (rejected, duplicates) == (1, 1)
assert not valid_record({"id": "x", "name": "X",
                         "price_minor": True, "currency": "EUR"})
try:
    collect(lambda cursor: {"items": [], "next": "same"})
except ValueError as error:
    assert str(error) == "pagination cursor repeated"
else:
    raise AssertionError("repeated cursor was accepted")
print("2 accepted, 1 rejected, 1 duplicate; cycle check passed")

Le transport factice renvoie une copie ; l’extraction ne modifie donc pas le fixture. Le collecteur valide l’enveloppe avant de traiter les lignes, suit les curseurs indépendamment des identités des produits et n’accepte que les enregistrements respectant les règles déclarées. Une page répétée et un produit répété constituent des observations distinctes.

Notez la vérification du type numérique. En Python, les booléens sont une sous-classe des entiers ; ainsi, une vérification générale des instances d’entiers accepterait True comme prix. Ce fixture l’exclut délibérément grâce à une comparaison de types exacte. D’autres langages et outils de schéma nécessitent une attention équivalente à la coercition et aux types acceptés.

Le budget de pages est une limite de sécurité, et non une garantie d’exhaustivité. S’il expire avant l’apparition de la continuation nulle, l’opération génère une erreur. Elle ne renvoie jamais un résultat normal de fin simplement parce que la boucle a atteint son maximum configuré.

Il s’agit d’un extracteur pédagogique, et non d’un système de stockage de production. Il accumule les enregistrements acceptés en mémoire et lève une exception en cas d’échec de pagination, plutôt que de conserver de manière durable une progression partielle. Avant d’extraire des données à grande échelle à partir d’API, remplacez ces limitations par un « sink » et un « run record » qui préservent le travail déjà accepté.

Les prochains tests locaux doivent refléter votre contrat : une clé de continuation manquante, un champ non de type liste items et des doublons conflictuels. Précisez clairement les résultats attendus. L’objectif est de tester les décisions que la source réelle peut imposer, et non d’ajouter une vaste suite de tests qui se contente de reproduire l’implémentation.

Rendez explicites l’achèvement de la pagination et les points de contrôle

L’exercice utilise des valeurs de curseur, mais les fournisseurs publient différents contrats de pagination. Certains renvoient des liens, d’autres utilisent des décalages, et d’autres encore exigent des numéros de page ou des jetons de continuation. La documentation de GitHub sur la pagination illustre la continuation basée sur des liens pour ce service ; il s’agit d’un exemple, et non d’un format d’API universel.

Conservez les valeurs de continuation opaques exactement comme le fournit le fournisseur. Assurez-vous que les filtres pertinents et le contexte du compte restent associés à l’élément de travail. Un jeton généré pour une portée de requête ne doit pas être traité comme une instruction autonome s’appliquant à toute requête ultérieure.

Vérifiez la validité de la continuation basée sur une URL avant de la suivre. Un lien « next » fourni dans la réponse doit rester dans les destinations que votre intégration est autorisée à contacter, et les redirections nécessitent les mêmes vérifications de limites. Ne transmettez pas d’identifiants à un hôte sans rapport simplement parce qu’une réponse incluait cette URL.

Lors de l’extraction de données depuis des API vers un stockage durable, validez les données acceptées avant de faire avancer le point de contrôle. Si le point de contrôle avance en premier et que le stockage échoue, un redémarrage peut omettre des enregistrements. Si les données sont stockées en premier et que la mise à jour du point de contrôle échoue, la tentative suivante peut rejouer une page, ce qu’une politique de duplication délibérée peut gérer.

Une transaction atomique peut s’avérer utile lorsque le récepteur et le point de contrôle partagent un même système de stockage. Si ce n’est pas le cas, documentez le fonctionnement de la relecture et du rapprochement. Évitez de prétendre à un traitement « exactly-once » simplement parce que le scénario normal stocke une ligne par identifiant source.

Identifiez la raison de la fin du traitement. Une dernière page fournie par la source, un budget de pages, une date limite et une réponse rejetée constituent des résultats distincts. Un rapport ne contenant que le nombre de données acceptées ne permet pas de déterminer si la tâche a couvert l’étendue prévue.

Testez également les hypothèses du fournisseur concernant les données changeantes. Une liste basée sur des décalages peut se déplacer pendant que vous la parcourez, et un curseur peut expirer avant un redémarrage ultérieur. Enregistrez la fenêtre de collecte et utilisez un instantané documenté ou un mécanisme incrémental lorsque la tâche nécessite une cohérence plus forte que celle offerte par un parcours en temps réel.

Gérez les nouvelles tentatives sans masquer les lacunes ni les doublons

Une nouvelle tentative est une nouvelle tentative d’opération, et non une correction de ses données d’entrée. Répéter une requête avec des identifiants non valides ou des paramètres mal formés ne fait généralement que reproduire le problème. Commencez par classer l’échec et identifiez ce qui, le cas échéant, pourrait changer avant une nouvelle tentative.

Pour HTTP, la sémantique des méthodes décrite dans la RFC 9110 permet de distinguer les récupérations sans risque des opérations dont la répétition peut avoir des conséquences métier. Même pour les lectures, limitez le nombre de tentatives et respectez le comportement documenté du fournisseur. N’activez pas de fonctionnalité de nouvelle tentative générale sans vérifier quelles erreurs et quelles opérations elle répète.

Les limites de débit nécessitent de prêter attention à la charge globale. Une 429 réponse signale une condition de limitation ; la portée du comptage est définie par le service, et la réponse peut inclure des indications sur le délai. La RFC 6585 définit le statut. Plusieurs processus partageant les mêmes identifiants peuvent épuiser le même quota.

Choisissez un responsable des réessais. Si le client, l’intermédiaire et l’exécuteur de tâches effectuent tous des réessais de manière invisible, une seule requête prévue peut générer un trafic supérieur à ce que le collecteur enregistre. Rendez le nombre de tentatives et la durée écoulée de la tâche suffisamment visibles pour pouvoir analyser cette multiplication.

Lors de l’extraction de données à partir d’API, maintenez un statut distinct pour la collecte partielle. Si trois pages ont été acceptées et que la quatrième a échoué, conservez les données acceptées conformément à la politique et enregistrez la portée manquante. Ne créez pas de marqueur de dernière page et ne fournissez pas d’ensemble de données « complet » non validé.

Protégez le rapport d’échec lui-même. Stockez les identifiants de requête anonymisés, les catégories de réponse et les erreurs de schéma. Évitez de verser des identifiants d’authentification, des enregistrements de compte complets ou des corps de message non restreints dans un journal général simplement parce qu’une erreur s’est produite.

Enfin, distinguez la récupération répétée de la livraison répétée. Si l’exportation en aval échoue après une collecte réussie, réessayer l’exportation à partir des enregistrements stockés préserve l’observation d’origine. Récupérer à nouveau la source crée une exécution différente dont les valeurs et l’exhaustivité peuvent varier.

Fournissez les enregistrements avec des informations de provenance et des contrôles de modification

Une ligne acceptée doit comporter suffisamment de contexte pour expliquer d’où elle provient. Selon la tâche, cela inclut l’identité de la source, l’heure de collecte, la portée de la requête, la version du point de terminaison et la version de la transformation. Distinguez l’heure de modification de la source de l’heure à laquelle votre collecteur a observé l’enregistrement.

Vérifiez les limites de la transmission ainsi que la réponse de la source. Un entier correct peut se transformer en texte lors d’une exportation, une valeur nulle peut devenir une cellule vide, ou un consommateur peut interpréter un horodatage dans un fuseau horaire différent. Définissez le schéma de sortie et vérifiez un fichier ou un message représentatif avant de publier une exécution complète.

Pour l’extraction programmée de données à partir d’API, ajoutez un petit moniteur de changements. Comparez le nombre de rejets, la présence des champs obligatoires et le comportement de finalisation avec les attentes pour cette source. Une baisse soudaine du nombre d’enregistrements acceptés mérite d’être examinée, mais elle n’est pas automatiquement le signe d’un bug d’extraction ; les filtres ou l’inventaire de la source peuvent avoir changé de manière légitime.

Conservez un scénario de test approuvé pour la maintenance. Lorsqu’un fournisseur modifie un champ facultatif, un test doit permettre de vérifier si votre mappage l’ignore en toute sécurité ou s’il nécessite une mise à jour. Lorsqu’un champ obligatoire change de signification, révisez le contrat plutôt que d’ajouter une solution de repli générale produisant un résultat plausible.

Le guide du web scraping automatisé relie ces limites d’acceptation et de livraison au cycle de vie plus large d’une tâche. La même discipline opérationnelle s’applique, que les données d’entrée proviennent d’une API documentée ou d’une page web analysée.

Terminez la première implémentation par un rapport d’exécution utilisable par d’autres : nombre d’éléments acceptés, rejetés, en double et de pages ayant échoué ; motif du rejet ; et emplacement de la sortie validée. Ce rapport transforme un script fonctionnel en un processus de collecte dont les limites restent visibles.

Points clés à retenir

  • Définissez la signification des champs, l’identité, la politique en matière de doublons et les critères de finalisation avant d’extraire les données des API en boucle.
  • Séparez la récupération, le décodage et la validation métier afin que les échecs de transport ne se traduisent pas par des résultats de réussite vides.
  • Testez localement les curseurs répétés, les lignes non valides et les limites de pages avant de connecter l’extracteur à un fournisseur en production.
  • Enregistrez les données acceptées avant de passer à un point de contrôle suivant, et rendez le comportement de redémarrage compatible avec une relecture délibérée.
  • Conservez les traces des exécutions partielles et validez le format de livraison final avec autant de soin que la réponse source.

FAQ

La collecte et la transformation doivent-elles suivre le même calendrier ?

Pas nécessairement. La collecte d’une observation source et la transformation des données stockées sont des tâches distinctes. Les séparer peut vous permettre de corriger un mappage sans effectuer une nouvelle requête source. Déterminez la durée de conservation des observations brutes et les versions de transformation dont les consommateurs ont besoin, puis planifiez chaque étape en fonction de ces exigences.

Comment un collecteur d’API doit-il gérer un nouveau champ facultatif ?

Suivez la politique de compatibilité que vous avez choisie pour la source. Un collecteur qui ignore les champs optionnels inconnus peut continuer à fonctionner sans modification, tandis qu’un collecteur conservant un document brut complet peut les conserver pour un examen ultérieur. N’exposez pas automatiquement chaque nouveau champ aux consommateurs en aval sans vérifier sa signification et ses implications en matière d’accès.

Une exportation CSV peut-elle conserver toutes les valeurs de l’API ?

Pas sans un mappage explicite. Le format CSV ne conserve pas intrinsèquement les objets imbriqués, les tableaux ou les distinctions telles que la différence entre une valeur nulle et un texte vide. Aplatissez ou encodez ces valeurs de manière délibérée, documentez la convention et testez l’interprétation du consommateur. Conservez une représentation source plus riche si un traitement ultérieur venait à nécessiter des informations omises dans le tableau.

Conclusion

Commencez à extraire des données depuis des API avec un contrat restreint et une boucle tenant compte des échecs. Cet exercice local illustre les décisions clés : n’accepter que les enregistrements définis, traiter les produits en double séparément des curseurs répétés, et exiger une véritable condition de fin. Un véritable client HTTP ajoute des considérations liées au transport sans pour autant remplacer ces règles.

Avant de planifier la tâche, attribuez aux données acceptées une destination durable, assurez-vous que le point de contrôle puisse être rejoué en toute sécurité et générez un rapport distinguant les exécutions complètes des exécutions partielles. Ces contrôles vous permettent d’élargir la portée sans rendre les données manquantes plus difficiles à identifier.

Si certains champs obligatoires ne sont disponibles que via des pages web, envisagez l’API Scraper de WebScrapingAPI comme source d’entrée supplémentaire. Maintenez le même contrat d’acceptation, de provenance et de livraison pour ces données afin que le pipeline reste cohérent même lorsque les méthodes de collecte diffèrent.

À propos de l'auteur

Gabriel Cioci, Développeur full-stack @ WebScrapingAPI

Gabriel Cioci

Développeur full-stack

Gabriel Cioci est développeur Full Stack chez WebScrapingAPI, où il se charge de la création et de la maintenance des sites web, du panneau utilisateur et des principaux éléments de la plateforme destinés aux utilisateurs.

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.