Aller au contenu
Retour au blog

Les API pour les débutants : lire les requêtes et collecter des données

Robert MunceanuDernière mise à jour le 16 min read
Les API pour les débutants : lire les requêtes et collecter des données
En bref : une API est une interface qui permet à un logiciel d’exploiter les fonctionnalités d’un autre système. Pour la collecte de données, apprenez à lire le contrat de requête, à interpréter à la fois le statut et le contenu de la réponse, à protéger vos identifiants et à vérifier que vous avez bien récupéré les enregistrements souhaités avant d’envoyer d’autres requêtes.

Un fournisseur propose une page de produits et une API documentée permettant de consulter ce même catalogue. Vous souhaitez obtenir les noms, les prix et les identifiants des produits dans un ensemble de données. C’est à ce moment-là que les API pour débutants deviennent un sujet concret : vous devez comprendre comment un programme demande des données, ce qu’il reçoit en retour, et si le résultat correspond bien à ce que vous pensez.

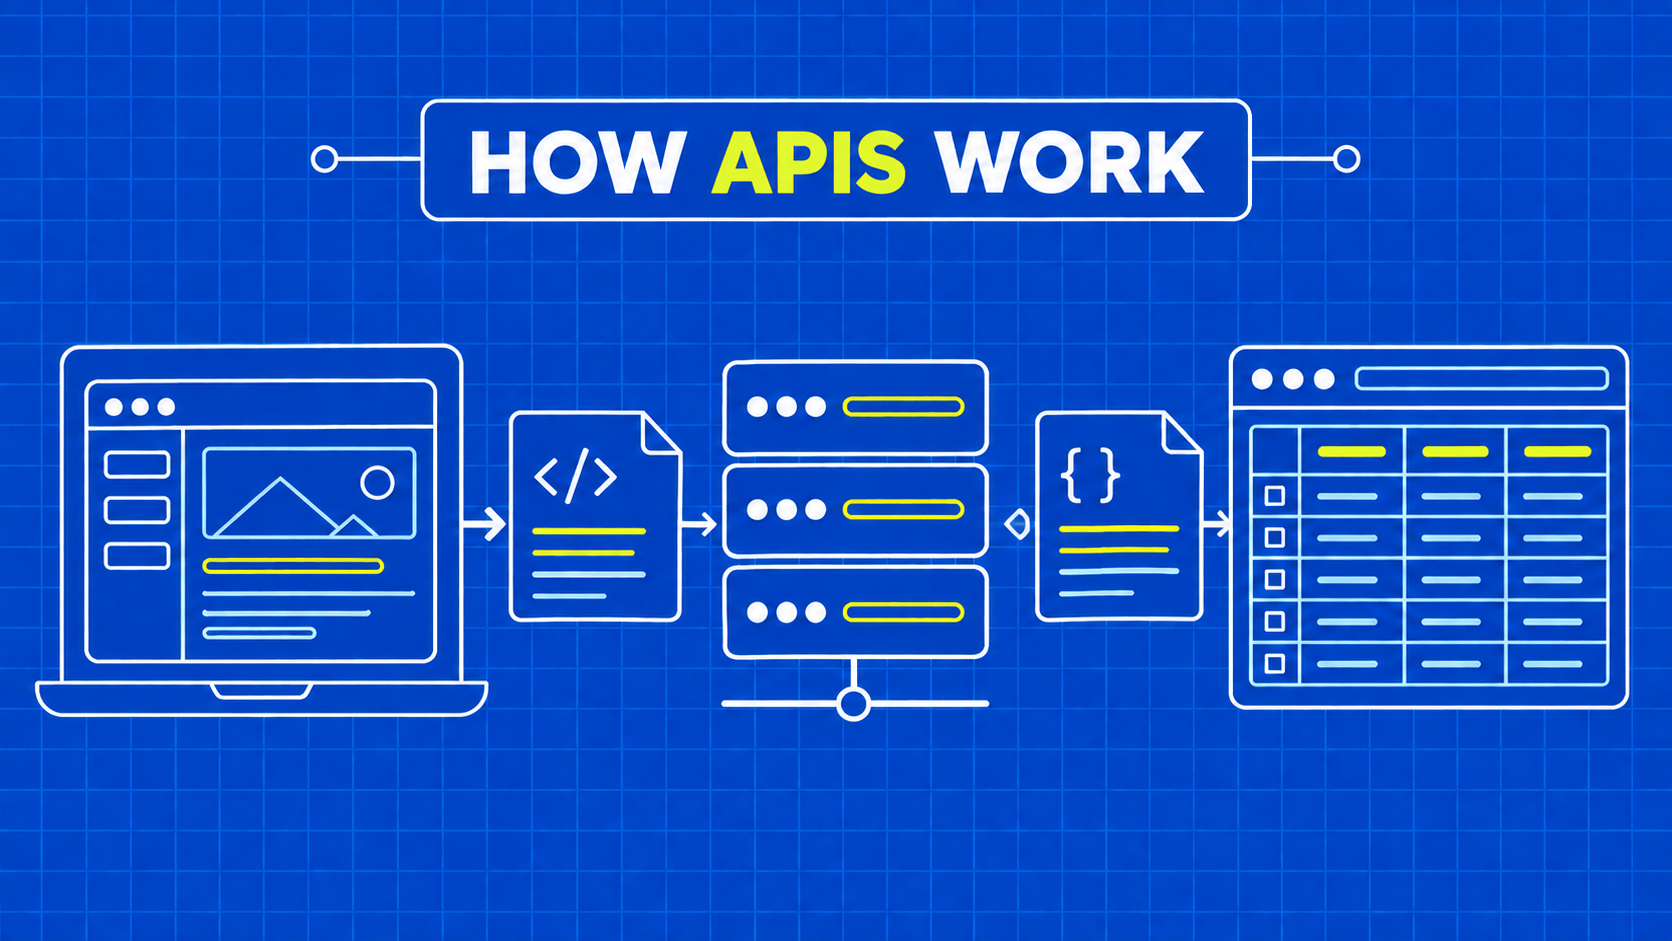
Une interface de programmation d’application (API) définit la manière dont un logiciel peut interagir avec une fonctionnalité. Toutes les API ne sont pas accessibles via un réseau ; une bibliothèque de programmation expose également une interface. Ce guide se concentre sur les API Web utilisées pour récupérer des données, dans lesquelles votre programme envoie une requête à un service et interprète sa réponse. L’introduction aux API de MDN explique cette distinction plus générale.

Commencez par une opération de lecture documentée et un enregistrement attendu. Nous utiliserons un catalogue fictif, puis examinerons un exemple de réponse autonome. Aucun compte, aucune clé API, aucun service externe ni aucune installation logicielle n’est requis. L’objectif est de formuler les questions qui rendront votre première intégration réelle fiable.

Comprendre les API pour les débutants à travers une tâche liée à un catalogue

Imaginez que votre tâche consiste à enregistrer chaque matin le prix catalogue d’une lampe de bureau proposé par le fournisseur. Une personne peut ouvrir la page du produit et le consulter. Un programme a besoin d’un moyen reproductible d’identifier le produit et de récupérer une représentation contenant les champs pertinents.

Une API documentée peut fournir cette interface. Sa documentation doit vous indiquer quelle opération permet de lire les produits, comment fonctionnent les identifiants, quelles informations d’authentification sont nécessaires et comment interpréter les champs. Vous devez tout de même vérifier la couverture : une API prise en charge peut omettre des informations affichées sur le site web ou les actualiser selon une fréquence différente.

Terme

Signification littérale

Exemple de catalogue fictif

Client

Logiciel effectuant une requête

Votre script de collecte

Serveur

Logiciel traitant la requête

Le service de catalogue du fournisseur

Point de terminaison

Adresse utilisée pour une opération API

L'adresse des produits répertoriés

Requête

Message du client demandant une tâche ou des données

Lire les produits d'une catégorie

Réponse

Réponse du serveur

Statut, en-têtes et document produit

Schéma

Règles décrivant la structure et la signification des données

ID du produit, nom, prix, devise

Les API destinées aux débutants doivent également faire la distinction entre les interfaces prises en charge et les détails d’implémentation accessoires. Les outils de développement d’un navigateur peuvent révéler les requêtes utilisées par un site web, mais cette découverte n’établit pas pour autant un contrat public ni une autorisation de les réutiliser. Privilégiez une interface documentée et respectez ses conditions d’accès.

Le scraping et l’utilisation d’une API peuvent alimenter le même pipeline de données. Le scraping extrait des informations d’une page ou d’un document ; l’utilisation d’une API documentée respecte un contrat logiciel publié. Aucune de ces deux méthodes ne garantit automatiquement qu’un champ est à jour, complet ou adapté à votre usage.

Avant d’effectuer des requêtes, définissez ce que vous considérez comme une observation valide : un produit connu, un nom non vide, le prix exprimé dans une unité et une devise connues, ainsi que l’heure à laquelle vous avez collecté ces informations. Cette définition guidera toutes les vérifications qui suivront.

Lisez la requête avant de choisir un client

Une requête HTTP est plus qu’une simple URL. Elle comprend une méthode, une cible, des en-têtes et parfois un corps. Chaque partie a un rôle à jouer. Lisez la description du fonctionnement du fournisseur avant de décider quelles valeurs envoyer ou de copier un exemple provenant d’un autre service.

La méthode décrit la sémantique de la requête. GET est utilisé pour la récupération ; les autres méthodes ont des finalités différentes. Ne déduisez pas les effets d’un point de terminaison inconnu à partir de son nom seul. La norme de sémantique HTTP définit les significations communes sur lesquelles s’appuient les implémentations.

L’URL identifie la destination de la requête. Un chemin peut identifier un produit ou une collection, tandis que les paramètres de requête peuvent fournir des filtres documentés ou des valeurs de pagination. Traitez les identifiants et les curseurs comme des données. Utilisez les fonctionnalités de construction d’URL de votre client lors de l’implémentation de la requête afin que les espaces, la ponctuation et les caractères réservés soient correctement encodés.

Les en-têtes transportent des métadonnées. Selon le contrat, ils peuvent indiquer les formats acceptés, authentifier le client ou fournir des conditions pour une requête. Un corps de requête transporte du contenu supplémentaire lorsque l’opération l’exige. Placer un champ au mauvais endroit n’équivaut pas à le fournir correctement, même si son nom semble correct.

Pour le catalogue fictif, rédigez une fiche de requête en langage clair : opération de lecture, filtre par catégorie, représentation attendue, méthode d’authentification requise, délai d’expiration et comportement de pagination documenté. Laissez les entrées inconnues sous forme de questions à clarifier dans la documentation. Ne les remplissez pas avec les conventions d’un autre fournisseur.

Considérez l’outil client comme secondaire par rapport à cette fiche de travail. Les clients en ligne de commande, les bibliothèques Python et les SDK construisent les requêtes avec des commodités et des valeurs par défaut différentes. Notre guide du client HTTP Python vous aide à comparer la couche de requête lorsque vous êtes prêt à l’implémenter.

Veillez à ce que le premier test en production soit de petite envergure et en lecture seule. Utilisez l’environnement de test du fournisseur ou un enregistrement d’exemple autorisé lorsqu’il est disponible, puis examinez la réponse avant d’élargir la portée de la requête.

Interprétez la réponse comme un statut et un contrat de données

Une réponse HTTP contient un code d’état, des en-têtes et, éventuellement, un corps. Un transfert réussi et un enregistrement métier valide sont deux observations distinctes. Votre collecteur doit vérifier ces deux éléments avant d’accepter les données.

Un code d’état résume le résultat de la requête au niveau HTTP. Un statut « réussi » ne garantit pas que le corps contienne exactement les champs dont votre tâche a besoin. À l’inverse, un statut « échoué » peut inclure un corps d’erreur structuré expliquant un paramètre manquant ou des identifiants périmés.

Observation

Ce qu’il faut vérifier ensuite

Ce qu’il ne faut pas supposer

Pas de réponse HTTP

Indices liés à la connexion, au DNS, au TLS ou à un délai d'expiration

Le catalogue était vide

Erreur d'authentification

Exigences documentées en matière d’identifiants

La saisie répétée des mêmes identifiants permettra de résoudre le problème

Refus d'autorisation

Portée du compte et accès aux ressources

Chaque refus correspond à un blocage réseau

Réponse de limitation de débit

Limites du fournisseur et recommandations en matière de délai

Un plus grand nombre de requêtes parallèles peut aider

Réussir avec un contenu inattendu

Type de média, schéma et identité de la page

Tout corps de réponse renvoyé est considéré comme une donnée acceptable

Collection vide valide

Filtres appliqués et état d'achèvement

Une collection vide signifie toujours un échec

Les en-têtes aident à comprendre le corps. Un type de média tel que application/json identifie un format de représentation, mais vous devez tout de même gérer les contenus mal formés ou inattendus. Une erreur générée par un autre composant peut arriver dans un format différent de celui que vous avez demandé.

Le JSON est un format texte contenant des valeurs telles que des objets, des tableaux, des chaînes de caractères, des nombres, des booléens et la valeur null. Il ne s’agit pas de l’API elle-même, et il ne fournit pas automatiquement de sens métier. La norme JSON définit le format ; c’est le fournisseur qui détermine si un champ particulier correspond à des centimes, des euros, une date ou autre chose.

Lorsque vous vous initiez aux API, évitez de confondre « analysé avec succès » et « correct ». Vérifiez les champs obligatoires, les types, les unités et l’identité après l’analyse. Distinguez également les valeurs manquantes, null, zéro et le texte vide. Le contrat peut attribuer à chacune une signification différente, et une valeur par défaut automatique peut effacer cette distinction.

Traitez les identifiants et l’accès comme des aspects distincts

Une clé API est un identifiant utilisé par certains services pour identifier ou authentifier un appelant. D’autres interfaces utilisent des jetons d’accès, des requêtes signées ou d’autres mécanismes. La documentation du fournisseur doit préciser la méthode requise et l’emplacement où l’identifiant doit être fourni.

L’authentification et l’autorisation répondent à des questions différentes. L’authentification permet de déterminer qui ou quoi effectue l’appel. L’autorisation détermine si cet appelant est autorisé à effectuer cette action sur cette ressource. Une clé valide ne donne pas nécessairement accès à tous les points de terminaison ni aux données de tous les comptes.

Pour le catalogue fictif, un fournisseur pourrait autoriser l’accès public aux descriptions de produits tout en limitant la consultation des quantités en stock à certains clients. Si l’opération relative au prix aboutit et que celle concernant le stock échoue, vérifiez d’abord les autorisations documentées. Ne partez pas du principe qu’un identifiant valide signifie que la deuxième requête doit également être autorisée.

Ne divulguez pas de secrets dans les exemples d’articles, les fichiers validés, les captures d’écran partagées et les journaux de base. Utilisez une variable d’environnement ou le mécanisme de gestion des secrets approuvé dans votre déploiement lors de la mise en œuvre d’un client. Enregistrez un identifiant d’identifiant d’authentification si nécessaire à des fins de diagnostic, et non la valeur secrète elle-même.

Les API destinées aux débutants doivent clairement établir une distinction supplémentaire : l’environnement du navigateur et un programme côté serveur présentent des risques d’exposition différents. Un secret intégré dans du code fourni par le navigateur est accessible à la personne qui utilise ce navigateur. Ne le traitez pas comme un identifiant conservé sur le serveur simplement parce que la variable est nommée « private ».

Lisez la documentation sur le cycle de vie des identifiants avant de planifier une tâche. Déterminez comment les identifiants expirent ou sont renouvelés, comment le processus obtient des identifiants de remplacement, et quel responsable peut résoudre les échecs d’accès. Un collecteur planifié a besoin d’un état d’échec clair lorsque l’authentification cesse de fonctionner, plutôt que d’une boucle qui répète la même requête rejetée.

Lorsque vous partagez un rapport de problème, incluez l’opération, le statut, l’heure et les détails de l’erreur anonymisés. Ces informations aident le prestataire à mener son enquête sans exposer les identifiants qui donnent accès à vos données.

Entraînez-vous à interpréter une réponse autonome

Supposons que le contrat de catalogue fictif indique price_minor est un nombre entier de cents, currency identifie la devise, et next_cursor est soit une valeur de continuation opaque, soit nulle lorsque ce résultat n’a pas de page suivante. Ces règles ont été inventées pour cet exercice et ne doivent pas être considérées comme valables pour une autre API.

Ce qui suit est un exemple de corps de réponse, et non une requête que vous devriez envoyer où que ce soit :

{
  "items": [
    {
      "id": "lamp-17",
      "name": "Desk lamp",
      "price_minor": 2400,
      "currency": "EUR"
    }
  ],
  "next_cursor": null
}

Commencez par l’identifiant. L’élément identifie lamp-17, votre enregistrement doit donc conserver cette valeur plutôt que d’utiliser sa position dans le tableau comme identifiant de produit. Le nom est un champ distinct et pourrait changer sans pour autant créer un produit différent.

Ensuite, appliquez la règle d’unité indiquée. Le montant est de 24,00 EUR car cet exercice définit explicitement l’entier comme étant exprimé en centimes. Sans cette définition, la division par cent ne serait qu’une supposition. Conservez l’entier d’origine et la devise parallèlement à toute valeur d’affichage formatée afin que les transformations ultérieures restent explicables.

Vérifiez ensuite la suite. La valeur null signifie qu’il n’y a pas de page suivante dans ce contrat fictif. Cela ne prouve pas que l’ensemble du stock du fournisseur ne contienne qu’un seul produit ; la requête a peut-être sélectionné une catégorie ou un autre filtre. L’exhaustivité se réfère toujours à un périmètre de requête défini.

Enfin, imaginez mentalement des cas négatifs : supprimez le nom, remplacez le nombre entier par un mot ou indiquez une devise inattendue. Déterminez quels cas votre collecteur rejetterait ou mettrait en quarantaine. Un corps de requête peut rester un JSON valide tout en enfreignant toutes les règles métier utiles.

Cet exercice met en évidence l’essence même des API pour les débutants : la syntaxe, la signification et l’acceptation constituent des couches distinctes. Une implémentation réelle devrait rendre ces couches observables afin qu’une réponse inconnue soit classée comme un échec plutôt que comme un enregistrement plausible mais incorrect.

Collecter plusieurs pages sans perdre le sens

Les API divisent souvent les collections volumineuses en pages. Le fournisseur peut utiliser des numéros de page, des décalages, des curseurs ou des liens. Apprenez le mécanisme de continuation documenté au lieu de supposer que l’incrémentation d’un nombre permet de récupérer l’intégralité des données.

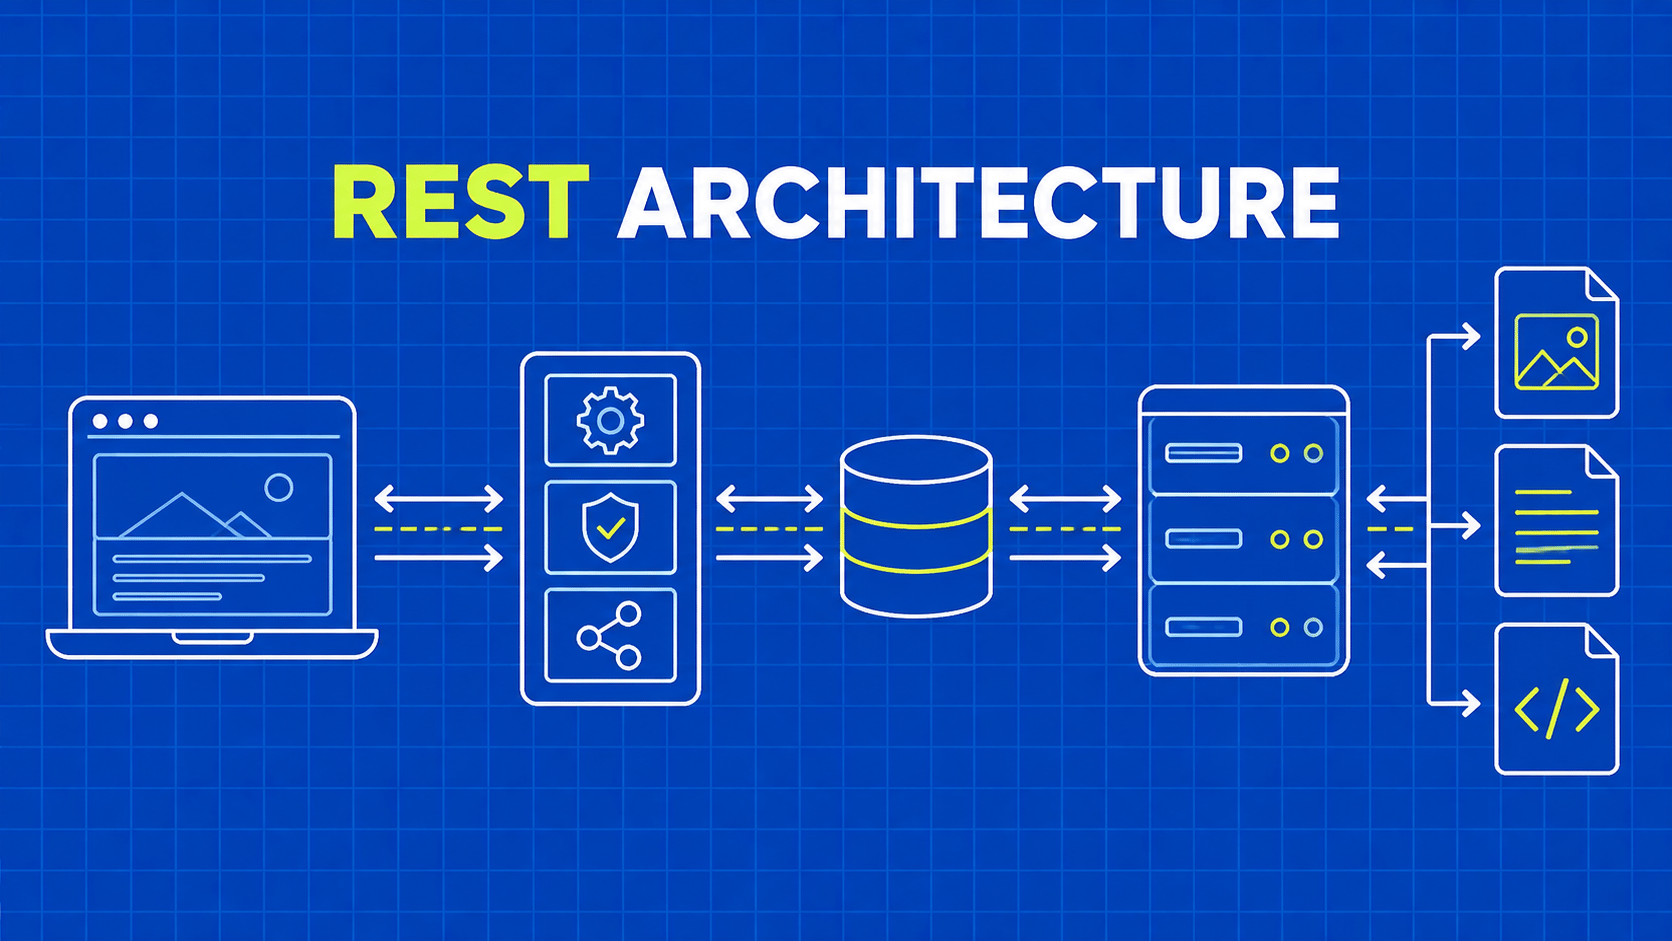
Un curseur est souvent opaque pour l’utilisateur : vous renvoyez la valeur fournie conformément aux instructions, sans l’interpréter ni la modifier. Il peut coder un état que le fournisseur est susceptible de modifier. De même, un lien vers la page suivante permet au service de fournir la destination. Le guide de l’architecture REST explique pourquoi les transitions prises en charge sont importantes dans une interface orientée ressources.

Pour le catalogue fictif, conservez les filtres de requête ainsi que la valeur de continuation. Un curseur destiné à une catégorie peut ne pas s’appliquer à une autre. Enregistrez les identifiants des éléments acceptés et définissez la manière dont les doublons sont gérés, en particulier lorsqu’un catalogue évolutif peut déplacer des enregistrements pendant la collecte.

Les limites de débit restreignent le volume des requêtes conformément à la politique du fournisseur. Une 429 Too Many Requests réponse indique une condition de limitation de débit, mais le statut ne définit pas la manière dont le fournisseur comptabilise l’utilisation. La RFC 6585 décrit le code 429 et précise qu’une réponse peut inclure Retry-After des indications.

Suivez les recommandations applicables en matière de délai et limitez le nombre de tentatives. Traitez une erreur d’autorisation répétée différemment d’une panne temporaire du service. Tenez également compte de l’ensemble de la tâche : plusieurs agents effectuant chacun un nombre modeste de requêtes peuvent, collectivement, dépasser le débit autorisé.

Les API destinées aux débutants devraient inclure une définition de la notion de « terminé ». Avez-vous atteint la dernière page documentée, vous êtes-vous arrêté en raison d’une contrainte de temps, ou avez-vous échoué après avoir accepté certains enregistrements ? Enregistrez cette classification avec l’exécution. « 500 produits collectés » ne précise pas si la portée de la requête en comptait 500 ou bien davantage.

Enregistrez la progression une fois que les données acceptées ont été stockées de manière durable, et concevez un comportement de redémarrage permettant d’éviter de sauter des étapes de travail. Conservez la fenêtre de collecte dans la sortie, car un long parcours d’une source évolutive peut représenter des observations dans le temps plutôt qu’un instantané précis.

Passer d’une requête réussie à un traitement fiable

Une réponse réussie prouve qu’une interaction a fonctionné dans des conditions particulières. Un collecteur planifié doit également gérer les données modifiées, les accès expirés, les exécutions partielles et les échecs de sortie. Ajoutez ces responsabilités de manière réfléchie plutôt que d’augmenter d’abord le volume des requêtes.

Commencez par un petit rapport d’acceptation. Indiquez-y la portée de la requête, l’heure de collecte, le nombre d’enregistrements acceptés, le nombre de rejets, l’état de poursuite et la catégorie d’échec le cas échéant. Évitez d’inclure des secrets bruts ou des corps de réponse non restreints dans ce rapport.

Préservez la distinction entre la récupération à la source et la livraison des données. Si les enregistrements ont été acceptés localement mais que l’exportation a échoué, la solution appropriée peut consister à renvoyer la sortie enregistrée plutôt que de récupérer à nouveau la source. Une deuxième récupération peut produire une observation différente et ne doit pas remplacer silencieusement l’originale.

Déterminez comment fonctionne l’actualité des données. Une réponse stockée n’est pas automatiquement à jour simplement parce qu’elle était valide à un moment donné. La mise en cache HTTP suit des règles de réutilisation et de validation, documentées dans la RFC 9111. Pour votre ensemble de données, précisez également l’ancienneté des observations que les consommateurs en aval peuvent tolérer.

Testez un ensemble restreint de cas de défaillance avant la planification : des identifiants non valides, un champ obligatoire manquant, un résultat valide mais vide, et une pagination interrompue. Utilisez des fixtures ou un environnement de test autorisé plutôt que de générer un trafic inutile vers le fournisseur. Chaque cas doit aboutir à un résultat explicite.

Les API pour débutants deviennent de l’ingénierie opérationnelle lorsque ces résultats ont des responsables. Désignez la personne chargée de gérer les problèmes d’accès, celle qui met à jour le mappage du schéma et celle qui décide si une exécution incomplète doit être livrée. Le guide de collecte automatisée relie ces vérifications à la planification et à la récupération.

Limitez le champ d’application du premier workflow de production. Un collecteur de petite envergure, dont le périmètre est documenté et la validation fiable, est plus facile à étendre qu’un collecteur de grande envergure dont la réussite masque des données manquantes.

Points clés à retenir

  • Lisez le contrat de requête documenté avant de sélectionner un client, notamment la méthode, la cible, les paramètres, les en-têtes et les informations d’identification requises.
  • Vérifiez séparément le statut de la réponse, le format de représentation et les champs métier ; un JSON valide ne garantit pas un enregistrement produit valide.
  • Conservez les identifiants, les valeurs d’origine, les unités et le contexte de collecte afin que les transformations de données restent compréhensibles et réversibles.
  • Définissez les conditions d’achèvement de la pagination, la gestion de la limitation de débit et le comportement de redémarrage avant de supposer qu’une requête réussie peut devenir une tâche planifiée.
  • Utilisez des catégories d’échec explicites et protégez les informations confidentielles afin que la maintenance ne dépende pas de la copie de traces de requêtes sensibles.

FAQ

Une API est-elle la même chose qu’une base de données ?

Non. Une base de données stocke et gère des données, tandis qu’une API expose une interface permettant d’utiliser des fonctionnalités ou des informations. Un service peut combiner plusieurs bases de données ou calculer un résultat sans exposer ces détails. Les utilisateurs doivent se fier au contrat d’API publié plutôt que d’essayer de deviner quelle table interne une réponse représente.

Ai-je besoin d’un navigateur pour appeler une API ?

Pas nécessairement. De nombreuses API Web documentées peuvent être utilisées par un client HTTP côté serveur sans afficher de page. Ce sont les exigences du fournisseur en matière d’authentification et d’interaction qui déterminent ce qui est nécessaire. Un navigateur peut être utile pour consulter la documentation, mais sa présence ne remplace pas la compréhension du contrat de requête ni le traitement correct de la réponse.

Toutes les API facturent-elles à chaque requête ?

Non. Les modalités d’accès varient selon le fournisseur et le service ; vérifiez donc le forfait et les conditions d’utilisation spécifiques. Ne partez pas du principe qu’une requête ayant échoué est gratuite ou qu’une période d’essai est soumise aux mêmes limites qu’un autre forfait. Consignez les règles d’utilisation pertinentes lors de l’intégration afin que les tâches planifiées restent dans les limites prévues.

Conclusion

Votre première étape importante consiste à disposer d’un enregistrement que vous pouvez expliquer : quelle opération l’a généré, que signifie chaque champ, quand il a été observé et pourquoi il a passé la validation. Cela est plus utile qu’un script qui affiche un corps de réponse inconnu et se termine avec succès.

Pour un véritable fournisseur, répétez l’exercice fictif du catalogue en utilisant sa documentation. Notez les données d’entrée de la requête, préservez la signification originale de la réponse et identifiez la condition exacte qui met fin à la collecte. Testez ensuite un cas d’échec avant d’ajouter d’autres pages ou une planification. Cela permet aux débutants en matière d’API de rester ancrés dans un comportement que vous pouvez inspecter.

Si les informations dont vous avez besoin ne sont disponibles que via des pages web, évaluez l’API Scraper de WebScrapingAPI comme option de collecte. Appliquez les mêmes habitudes à ces données d’entrée : protégez les identifiants, inspectez la réponse, validez l’enregistrement extrait et conservez suffisamment de contexte pour qu’une autre personne puisse comprendre le résultat.

À propos de l'auteur

Robert Munceanu, Développeur full-stack @ WebScrapingAPI

Robert Munceanu

Développeur full-stack

Robert Munceanu est développeur Full Stack chez WebScrapingAPI ; il participe à l'ensemble du produit et contribue à la création d'outils et de fonctionnalités fiables qui soutiennent la plateforme.

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.