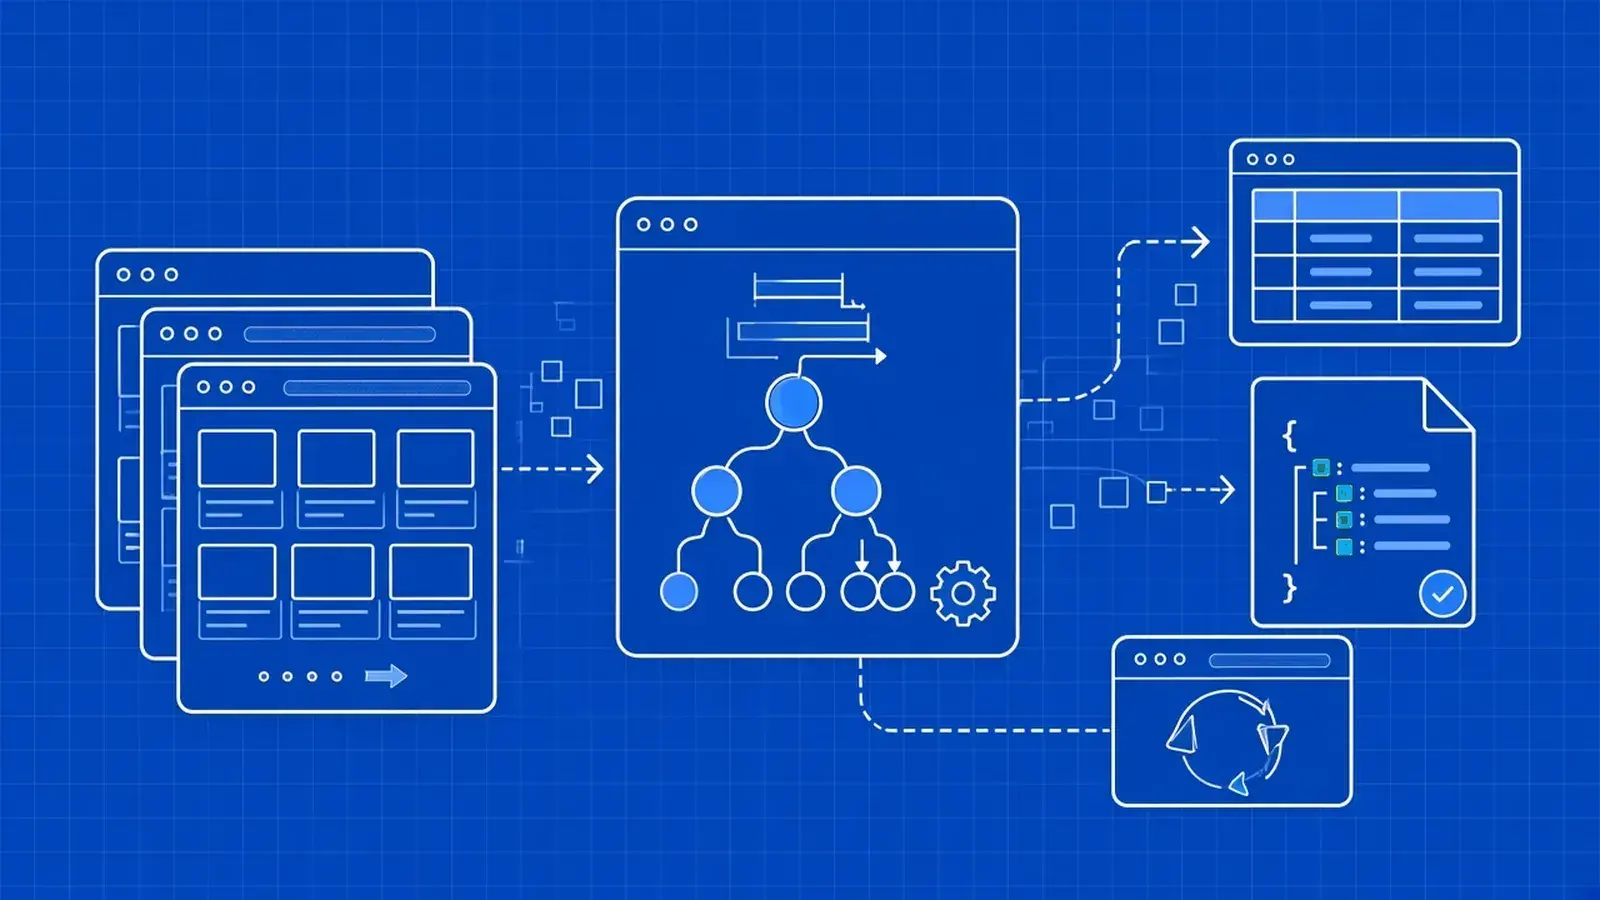
En bref : Ruby effectue du scraping sur le Web à l'aide de Faraday pour le protocole HTTP, de Nokogiri pour l'analyse du CSS et des expressions XPath, et d'un petit pool de threads pour la concurrence. Ce guide explique comment créer un scraper qui explore un catalogue de 1 000 livres au format CSV et JSON, effectue des tentatives de récupération de manière courtoise, gère une page JavaScript avec Ferrum et appelle une API de scraping à partir du même code.
Le scraping Web avec Ruby repose sur trois éléments : Faraday récupère la page, Nokogiri analyse le code HTML à l’aide de sélecteurs CSS ou d’expressions XPath, et un pool fixe de threads récupère plusieurs pages à la fois sans surcharger le site. Vous allez créer un scraper de A à Z. Il collecte tous les livres de books.toscrape.com, un catalogue d’entraînement public, suit la pagination, traite les pages en parallèle, réessaie correctement les requêtes soumises à une limite de débit et écrit les résultats au format CSV et JSON. Vous traiterez ensuite une page rendue en JavaScript (quotes.toscrape.com/js/) de trois manières différentes, vous vous connecterez à un formulaire de cabinet à l’aide de Mechanize, et vous appellerez une API de scraping à partir du même code Faraday.
Le code est destiné à Ruby 3.4 ou une version plus récente, ainsi qu’aux versions des gemmes indiquées dans le tableau ci-dessous.