Aller au contenu

Blog · Articles

Guides

Tutoriels étape par étape, bonnes pratiques et guides pratiques sur le web scraping, la gestion des proxys et l'extraction de données.

Articles publiés

105

Articles

Guides

105 articles

Web scraping avec AWS Lambda : guide pour Python et Java 2026
Guides

Web scraping avec AWS Lambda : guide pour Python et Java 2026

TL;DR: En bref : le web scraping avec AWS Lambda fonctionne mieux lorsque chaque invocation est courte, bien délimitée et peut faire l'objet d'une nouvelle tentative de manière indépendante. Commencez par utiliser les requêtes HTTP directes, AWS SAM et S3, puis ajoutez SQS, des conteneurs, le rendu dans un navigateur, des proxys ou une couche de récupération gérée uniquement lorsque la charge de travail démontre qu'elle en a besoin.

Suciu Dan33 min read
Lire l'article
Comment utiliser GoSpider : exploration, nettoyage des URL et extraction de données
Guides

Comment utiliser GoSpider : exploration, nettoyage des URL et extraction de données

TL;DR: En bref : GoSpider est un robot d'exploration en ligne de commande destiné à découvrir des URL, et non un outil complet de collecte de données structurées. Ce guide d'utilisation de GoSpider présente comment effectuer une exploration limitée, gérer correctement les résultats, transférer les données de Colly vers un fichier CSV, ainsi qu'une procédure de diagnostic pour les réponses 403 ou les pages nécessitant un rendu JavaScript.

Suciu Dan24 min read
Lire l'article
Comment récupérer les données de Redfin : Guide Python des données immobilières
Guides

Comment récupérer les données de Redfin : Guide Python des données immobilières

TL;DR: Redfin expose des points d'extrémité d'API cachés qui renvoient du JSON structuré pour les listes de propriétés, ce qui permet d'ignorer complètement l'analyse HTML fragile. Ce guide vous accompagne dans la construction d'un scraper Python qui extrait les données de location et de vente, effectue des recherches par emplacement, surveille les nouvelles inscriptions via des sitemaps XML et exporte des résultats propres au format CSV ou JSON.

Suciu Dan15 min read
Lire l'article
Comment analyser du JSON en Python : des réponses d'API au JSON caché dans les pages Web
Guides

Comment analyser du JSON en Python : des réponses d'API au JSON caché dans les pages Web

TL;DR: Analyser du JSON en Python avec les fonctions `json.loads` et `json.load`, corriger les erreurs de décodage, valider les données imbriquées, traiter des fichiers volumineux en continu et extraire le JSON-LD ou les éléments `__NEXT_DATA__` cachés dans les pages Web — sans oublier les enveloppes WebScrapingAPI.

Suciu Dan14 min read
Lire l'article
Les 10 meilleurs outils de web scraping IA pour 2026
Guides

Les 10 meilleurs outils de web scraping IA pour 2026

TL;DR: Aucun outil d'extraction basé sur l'IA n'est capable de s'adapter à toutes les charges de travail. Comparez 10 outils en fonction de leur méthode d'extraction, du type d'utilisateur, des opérations et du coût, puis utilisez un plan de test concret pour choisir celui qui vous convient le mieux.

Suciu Dan26 min read
Lire l'article
XPath Web Scraping : Un guide pratique avec des exemples en Python
Guides

XPath Web Scraping : Un guide pratique avec des exemples en Python

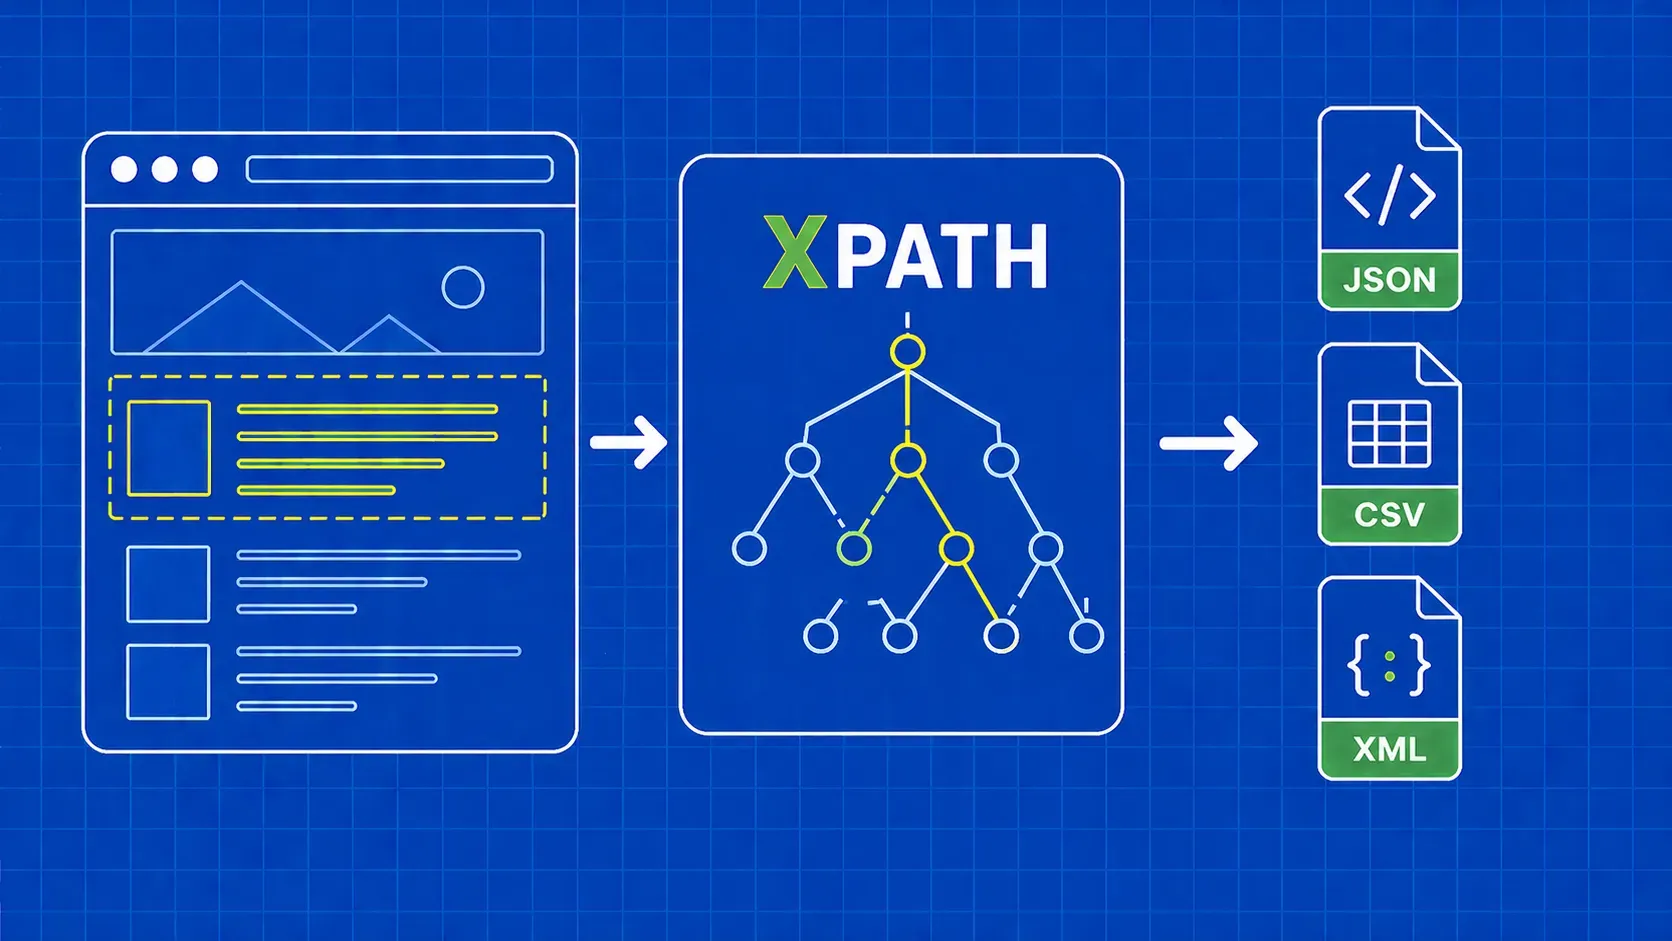
TL;DR: XPath est un langage de requête permettant de naviguer dans les arbres HTML/XML par chemin, attribut ou contenu textuel. Ce guide couvre la syntaxe, les axes et les fonctions XPath, puis montre des scrapers Python fonctionnels avec lxml et Selenium. Vous obtiendrez également un aide-mémoire consolidé et une section de dépannage pour les erreurs XPath les plus courantes.

Suciu Dan11 min read
Lire l'article
Tutoriel Scrapy Playwright : Scraper des sites lourds en JavaScript à grande échelle
Guides

Tutoriel Scrapy Playwright : Scraper des sites lourds en JavaScript à grande échelle

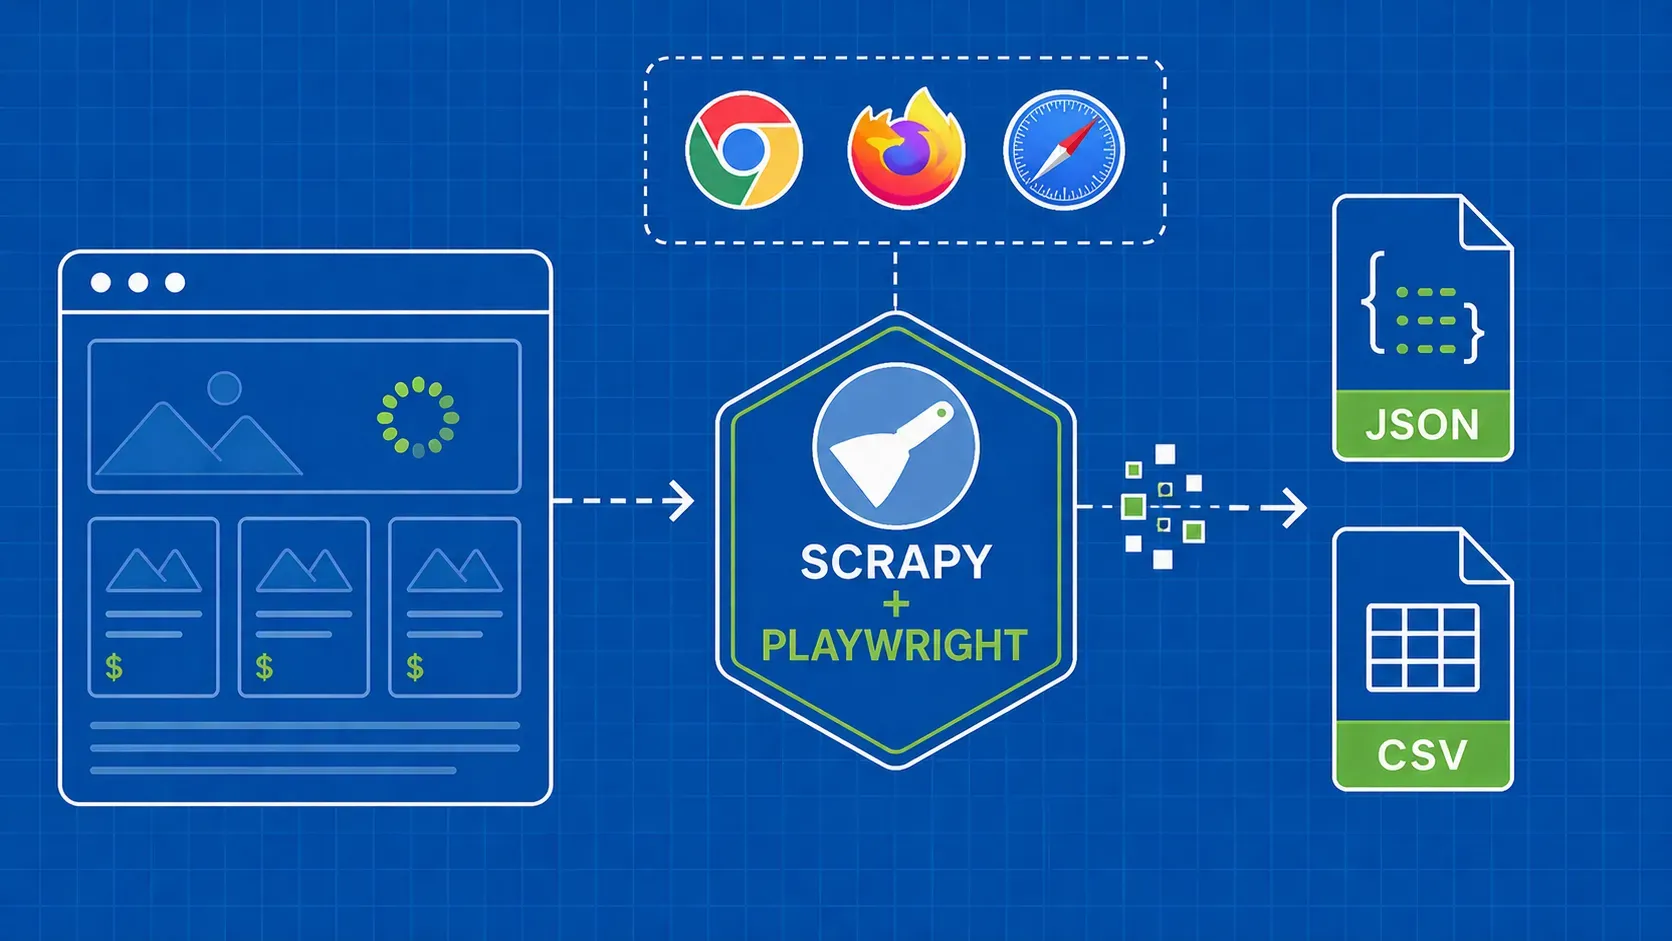
TL;DR: Scrapy-Playwright vous permet de rendre des pages lourdes en JavaScript directement à l'intérieur des spiders Scrapy en contrôlant de vrais navigateurs Chromium, Firefox, ou WebKit à travers Playwright. Ce tutoriel vous guide à travers l'installation, la configuration, les interactions entre les pages, l'interception AJAX, l'anti-détection, et une structure de projet prête pour la production afin que vous puissiez scanner des sites dynamiques sans quitter l'écosystème Scrapy.

Raluca Penciuc21 min read
Lire l'article
Comment extraire des données d'Expedia avec Python : hôtels, prix et avis (Guide 2026)
Guides

Comment extraire des données d'Expedia avec Python : hôtels, prix et avis (Guide 2026)

TL;DR: Extraire les annonces d'hôtels d'Expedia avec Python en utilisant le rendu JavaScript, des proxys, des sélecteurs CSS et la pagination, puis nettoyer et exporter les données au format CSV.

Mihai Maxim14 min read
Lire l'article
Guide de l'API de scraping des SERP : Google, Bing, DuckDuckGo, Yandex
Guides

Guide de l'API de scraping des SERP : Google, Bing, DuckDuckGo, Yandex

TL;DR: Envoyez votre première requête à l'API SERP de WebScrapingAPI en indiquant la clé dans une variable d'environnement, puis localisez les résultats Google par pays, langue et appareil, lisez les données JSON de Google et Bing de manière défensive, extrayez vous-même le code HTML de DuckDuckGo et Yandex, exécutez des tâches Google asynchrones, effectuez des tentatives de réessai en fonction des codes d'erreur documentés, et choisissez une formule tarifaire en vous basant sur les tarifs de Google en vigueur en octobre 2026.

Suciu Dan25 min read
Lire l'article
Comment utiliser l'API Amazon Scraper : guide de démarrage rapide
Guides

Comment utiliser l'API Amazon Scraper : guide de démarrage rapide

TL;DR: Lancez-vous avec l'API Amazon Scraper de WebScrapingAPI : envoyez votre première requête, choisissez parmi neuf types de requêtes (produits, recherche, meilleures ventes, offres promotionnelles, avis sur les vendeurs, etc.), ciblez 20 places de marché Amazon, analysez chaque réponse JSON, gérez les erreurs et les nouvelles tentatives, puis choisissez la formule qui vous convient.

Robert Sfichi25 min read
Lire l'article
Scrapy vs Beautiful Soup : Quel scraper Python choisir ?
Guides

Scrapy vs Beautiful Soup : Quel scraper Python choisir ?

TL;DR: Scrapy est un framework de crawling complet qui gère les requêtes, l'analyse et l'exportation des données en un seul package. Beautiful Soup est une bibliothèque d'analyse légère que vous associez à un client HTTP comme les requêtes. Choisissez Scrapy lorsque vous avez besoin d'un crawling concurrent à grande échelle avec des pipelines intégrés. Choisissez Beautiful Soup lorsque vous souhaitez une configuration rapide et minimale pour analyser une poignée de pages.

Mihnea-Octavian Manolache13 min read
Lire l'article
Tutoriel Scrapy Splash : Rendre des pages JavaScript
Guides

Tutoriel Scrapy Splash : Rendre des pages JavaScript

TL;DR: Scrapy Splash associe le moteur d'exploration rapide de Scrapy au navigateur sans tête Splash pour rendre les pages lourdes en JavaScript. Ce tutoriel scrapy splash vous guide à travers l'installation de Docker, la configuration du projet Scrapy, les bases de SplashRequest, les scripts Lua pour le défilement et le clic, l'intégration du proxy, et la correction des erreurs les plus courantes que vous rencontrerez.

Ștefan Răcilă13 min read
Lire l'article
Récupérer les données des produits Amazon avec Python : Guide pratique
Guides

Récupérer les données des produits Amazon avec Python : Guide pratique

TL;DR: Les pages de produits Amazon regorgent de données précieuses (prix, évaluations, commentaires, ASIN), mais les extraire de manière fiable nécessite plus qu'une simple requête HTTP. Ce guide vous aide à construire un scraper Python avec Requests et BeautifulSoup, à gérer la pagination et les défenses anti-bots, à exporter au format CSV ou JSON, et à introduire les résultats dans les flux de travail LLM. Vous apprendrez également quand utiliser une API de scraping au lieu de développer votre propre solution.

Raluca Penciuc19 min read
Lire l'article
Les meilleurs outils de Job Scraping en 2026 : Comparaison et guide
Guides

Les meilleurs outils de Job Scraping en 2026 : Comparaison et guide

TL;DR: Les outils de scraping d'offres d'emploi vont des services API légers et de l'automatisation des navigateurs open-source aux extracteurs alimentés par l'IA et aux plates-formes visuelles sans code. Ce guide compare les meilleurs outils de scraping d'offres d'emploi sur Google Jobs, Indeed, Monster, Upwork et les places de marché de freelance, puis vous accompagne dans la construction d'un pipeline fiable avec déduplication, planification et traitement anti-bot afin que vous puissiez commencer à collecter des données d'offres d'emploi propres à l'échelle.

Gabriel Cioci19 min read
Lire l'article
Contourner Cloudflare avec Selenium : 5 méthodes Python (2026)
Guides

Contourner Cloudflare avec Selenium : 5 méthodes Python (2026)

TL;DR: Cloudflare bloque le Selenium vanille en prenant l'empreinte du navigateur, en inspectant les en-têtes et en analysant les signaux comportementaux. Ce guide présente cinq méthodes de contournement pratiques (Undetected ChromeDriver, Selenium Stealth, SeleniumBase UC mode, CAPTCHA-solver integration, et scraping APIs), avec du code Python, un tableau de comparaison et un manuel de dépannage afin que vous puissiez choisir l'approche la plus adaptée à votre échelle et à votre budget.

Mihnea-Octavian Manolache21 min read
Lire l'article
7 meilleures API SERP en 2026 : Comparaison des prix et des fonctionnalités
Guides

7 meilleures API SERP en 2026 : Comparaison des prix et des fonctionnalités

TL;DR: Il n'existe pas d'API SERP officielle de Google, c'est pourquoi des fournisseurs tiers comblent cette lacune. Les prix varient entre 0,30 $ et 15 $ par millier de recherches, et le bon choix dépend de votre volume, de votre budget et des fonctionnalités SERP que vous souhaitez extraire. Ce guide compare les principaux fournisseurs côte à côte, décompose le coût réel à l'échelle et vous donne un cadre de décision pour sélectionner la meilleure API SERP pour votre projet.

Andrei Ogiolan22 min read
Lire l'article
Comment configurer le proxy Axios dans Node.js : Auth, Rotation, SOCKS5
Guides

Comment configurer le proxy Axios dans Node.js : Auth, Rotation, SOCKS5

TL;DR: Axios achemine les requêtes à travers un proxy en acceptant un objet proxy avec un hôte, un port et des champs d'authentification optionnels. Ce guide explique comment mettre en place une configuration de proxy Axios à partir de zéro : le câblage de base, les proxys authentifiés, le tunneling HTTPS, un système de rotation utilisant des intercepteurs, SOCKS5 via socks-proxy-agent, et le diagnostic des erreurs les plus courantes. Chaque extrait est du code Node.js à copier-coller.

Suciu Dan12 min read
Lire l'article
Fichier de téléchargement Puppeteer : 4 méthodes pour Node.js
Guides

Fichier de téléchargement Puppeteer : 4 méthodes pour Node.js

TL;DR: Un workflow de téléchargement de fichier Puppeteer peut prendre quatre formes : cliquer sur un bouton et laisser Chrome écrire dans un dossier que vous contrôlez, exécuter fetch() dans la page et renvoyer base64 à Node, piloter le protocole Chrome DevTools avec des événements de progression du téléchargement, ou ignorer le navigateur et extraire l'URL avec Axios en utilisant les cookies récoltés lors de la session Puppeteer. Choisissez en fonction de la taille du fichier, de l'authentification et de la façon dont le site expose le lien.

Mihnea-Octavian Manolache42 min read
Lire l'article
Comment utiliser un proxy dans Node-Fetch : Un guide pratique
Guides

Comment utiliser un proxy dans Node-Fetch : Un guide pratique

TL;DR: Node-Fetch n'a pas de commutateur proxy intégré, vous devez donc connecter un agent HTTP, HTTPS ou SOCKS5 à la requête via son option agent. Ce guide explique comment utiliser un proxy dans Node-Fetch de bout en bout : proxy HTTP et HTTPS authentifiés, SOCKS5, rotation, tentatives, cas limites de TLS, dépannage, et la route moderne undici pour Node 18+ native fetch.

Mihnea-Octavian Manolache13 min read
Lire l'article
Web Scraping JavaScript Tables in Python : Des API cachées à Playwright
Guides

Web Scraping JavaScript Tables in Python : Des API cachées à Playwright

TL;DR: Le scraping de tables JavaScript en Python nécessite rarement un navigateur sans tête. Ouvrez DevTools, trouvez le point de terminaison JSON qui hydrate la grille, rejouez-le avec des requêtes, paginez-le, et ne revenez à Playwright que lorsque l'appel réseau est signé, crypté ou autrement scellé.

Andrei Ogiolan13 min read
Lire l'article
Comment récupérer des tableaux HTML en Golang avec Colly : Guide de bout en bout
Guides

Comment récupérer des tableaux HTML en Golang avec Colly : Guide de bout en bout

TL;DR: Ce guide montre comment récupérer des tableaux HTML dans Golang de bout en bout : choisir entre Colly, goquery, et golang.org/x/net/html, cibler le bon <tbody>, modéliser les lignes comme une structure typée, et exporter du JSON et du CSV propre. Vous bénéficiez également de la pagination, de l'anti-blocage et de modèles de tableaux rendus par JavaScript.

Andrei Ogiolan12 min read
Lire l'article
Playwright Web Scraping : Le guide complet pour Python et Node.js
Guides

Playwright Web Scraping : Le guide complet pour Python et Node.js

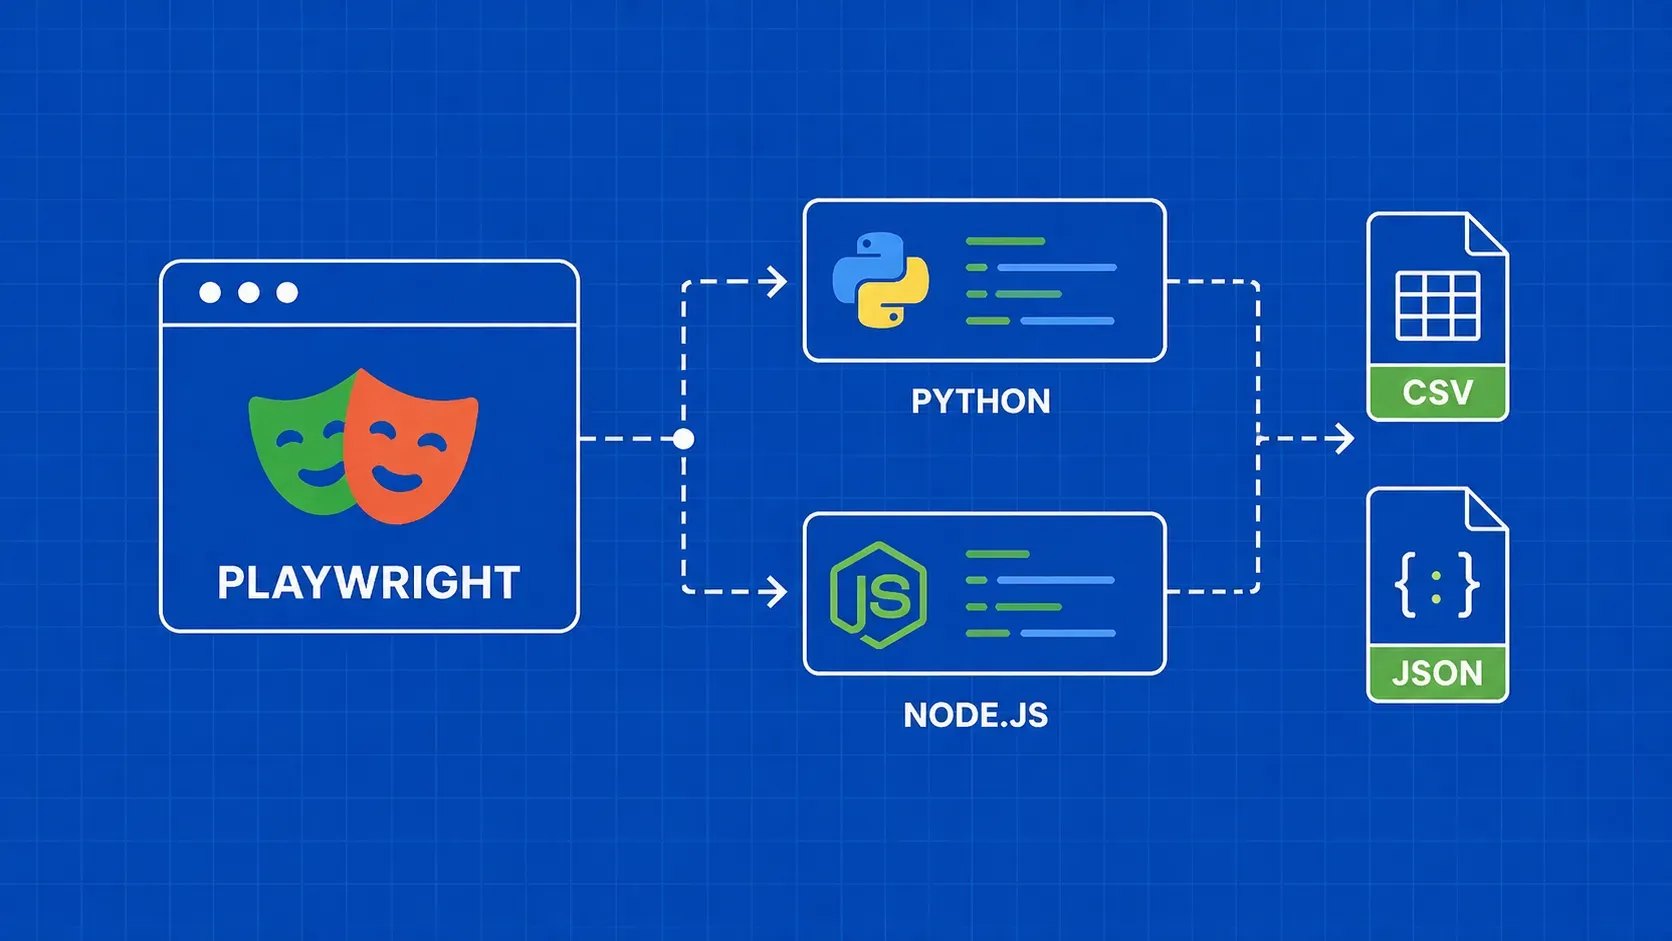
TL;DR: Playwright vous offre une automatisation complète du navigateur pour le scraping de sites à forte composante JavaScript, avec un support de premier ordre pour Python et Node.js. Ce guide vous accompagne dans l'installation, l'extraction d'éléments, la configuration du proxy, l'anti-détection, la pagination, le téléchargement d'images et l'exportation de données au format CSV ou JSON, le tout avec des exemples de code côte à côte dans les deux langages.

Mihnea-Octavian Manolache17 min read
Lire l'article
Comment récupérer des avis sur Google Maps : Un guide pratique en Python
Guides

Comment récupérer des avis sur Google Maps : Un guide pratique en Python

TL;DR: La recherche d'avis sur Google Maps se résume à trois méthodes : un scraper Selenium bricolé derrière un proxy rotatif, une API de scraping avec des instructions de rendu, ou une API Maps Reviews structurée qui renvoie du JSON analysé. Ce guide présente les trois méthodes en Python avec du code à copier-coller, des modèles de pagination, des tactiques anti-blocage et une étape finale de nettoyage qui transforme les avis bruts en quelque chose qu'une entreprise peut réellement utiliser.

Andrei Ogiolan18 min read
Lire l'article
Télécharger des fichiers avec Python : le guide pratique
Guides

Télécharger des fichiers avec Python : le guide pratique

TL;DR: Apprenez à télécharger des fichiers avec Python grâce à urllib, requests et aiohttp : streaming, barres de progression, téléchargements parallèles et asynchrones, relances et authentification.

Gabriel Cioci17 min read
Lire l'article
Proxy avec Python Requests : config, auth et rotation
Guides

Proxy avec Python Requests : config, auth et rotation

TL;DR: Ce guide explique comment utiliser les proxies avec Python Requests de bout en bout : un dict de proxies fonctionnel, des URLs authentifiées, des variables d'environnement, la réutilisation des sessions, SOCKS5 sans fuites DNS, et un pool de rotation avec des tentatives et un coupe-circuit. A la fin, vous saurez quand une API gérée gagne sa place par rapport à un pool bricolé.

Ștefan Răcilă12 min read
Lire l'article
Comment extraire les résultats de recherche de lieux sur Google Maps
Guides

Comment extraire les résultats de recherche de lieux sur Google Maps

TL;DR: Découvrez comment extraire les résultats de recherche de lieux sur Google Maps à l'aide de notre API et de Node.js : guide étape par étape, avantages d'un outil d'extraction professionnel, et bien plus encore. Récupérez facilement l'identifiant « data_id », les coordonnées et le paramètre « data ».

Andrei Ogiolan7 min read
Lire l'article
Web Scraping avec Regex : Un guide pratique
Guides

Web Scraping avec Regex : Un guide pratique

TL;DR: Le Web scraping avec regex est idéal lorsque vous avez besoin de motifs textuels courts et prévisibles (prix, SKUs, emails, dates) à partir d'un HTML auquel vous faites déjà confiance. Associez le module re de Python à Beautiful Soup, étendez vos motifs à un nœud analysé au lieu d'un balisage brut, et gardez les regex à l'écart de l'analyse complète de l'arbre HTML. Ce guide présente un scraper de titre et de prix fonctionnel, des fonctionnalités avancées de regex et les pièges qui guettent les vrais scrappers en production.

Mihai Maxim12 min read
Lire l'article
De l'analyse des sentiments au marketing : les nombreux avantages du web scraping sur Twitter
Guides

De l'analyse des sentiments au marketing : les nombreux avantages du web scraping sur Twitter

TL;DR: Tirez le meilleur parti des données Twitter grâce à des techniques avancées de web scraping. Découvrez comment extraire des données de Twitter pour l'analyse des sentiments, le marketing et la veille économique. Guide complet utilisant TypeScript.

Raluca Penciuc10 min read
Lire l'article
Comment utiliser un proxy avec HttpClient en C#
Guides

Comment utiliser un proxy avec HttpClient en C#

TL;DR: Pour utiliser un proxy avec HttpClient en C#, construisez un WebProxy, attachez-le à un HttpClientHandler (ou SocketsHttpHandler), et passez ce handler au constructeur de HttpClient. Pour la production, remplacez les boucles manuelles par IHttpClientFactory, ajoutez NetworkCredential pour les proxies authentifiés et enveloppez les appels dans des tentatives avec Polly pour que les IP mortes ne fassent pas tomber votre travailleur.

Suciu Dan19 min read
Lire l'article
Comment récupérer des tableaux HTML à l'aide de Python
Guides

Comment récupérer des tableaux HTML à l'aide de Python

TL;DR: La plupart des tableaux HTML peuvent être récupérés avec une seule ligne de pandas.read_html. Lorsque le tableau est paginé, rendu par JavaScript, ou a des en-têtes fusionnés, passez à Requests + BeautifulSoup ou à un navigateur sans tête comme Playwright. Ce guide vous donne une matrice de décision, du code de travail pour les trois approches, et les étapes de nettoyage qui transforment les lignes scrappées en données prêtes pour le pipeline.

Andrei Ogiolan18 min read
Lire l'article
Cheerio ou marionnettiste : Comment choisir le bon outil
Guides

Cheerio ou marionnettiste : Comment choisir le bon outil

TL;DR: Cheerio est un analyseur HTML léger ; Puppeteer pilote un vrai navigateur Chromium. Utilisez Cheerio quand les données sont déjà dans le HTML brut, Puppeteer quand JavaScript les rend, et combinez-les quand une page lourde en JS a beaucoup de champs à extraire par visite.

Sergiu Inizian10 min read
Lire l'article
Scraper Realtor.com : guide pratique 2026
Guides

Scraper Realtor.com : guide pratique 2026

TL;DR: Si vous cherchez à scraper proprement Realtor.com, trois choses comptent le plus : des sélecteurs stables qui survivent à leurs noms de classe hachés, une couche de requête qui survit à la protection anti-bot de Realtor, et un code qui parcourt à la fois les pages de listes et les pages de détails. Ce guide est la version complète de Python, avec des tactiques anti-blocage et des exportations prêtes pour LLM.

Raluca Penciuc15 min read
Lire l'article
Web Scraping Booking.com : Hôtels, prix et avis (Guide 2026)
Guides

Web Scraping Booking.com : Hôtels, prix et avis (Guide 2026)

TL;DR: Ce guide présente le web scraping de Booking.com de bout en bout en Python : extraction des listes de recherche, des pages d'hôtels, des prix de nuit, et des avis des clients. Vous obtiendrez deux méthodes complémentaires : un workflow Selenium Wire pour les pages rendues en JS et un chemin plus rapide qui appelle directement le point de terminaison interne /dml/graphql de Booking.com, plus un playbook anti-blocage, la gestion des devises, et une solution de contournement pour le plafond de pagination d'environ 1000 résultats.

Raluca Penciuc16 min read
Lire l'article
Comment récupérer des données sur Idealista : Un guide pour 2026
Guides

Comment récupérer des données sur Idealista : Un guide pour 2026

TL;DR: Idealista est la plus grande place de marché immobilière d'Espagne, d'Italie et du Portugal, mais une protection anti-bot sérieuse y bloque vite les scrapers naïfs. Ce guide explique comment extraire les données d'Idealista de bout en bout en Python : cartographie du site, Selenium avec undetected-chromedriver, gestion de DataDome, rotation de proxys et exportations propres, avec le durcissement pour la production que les concurrents négligent souvent.

Raluca Penciuc17 min read
Lire l'article
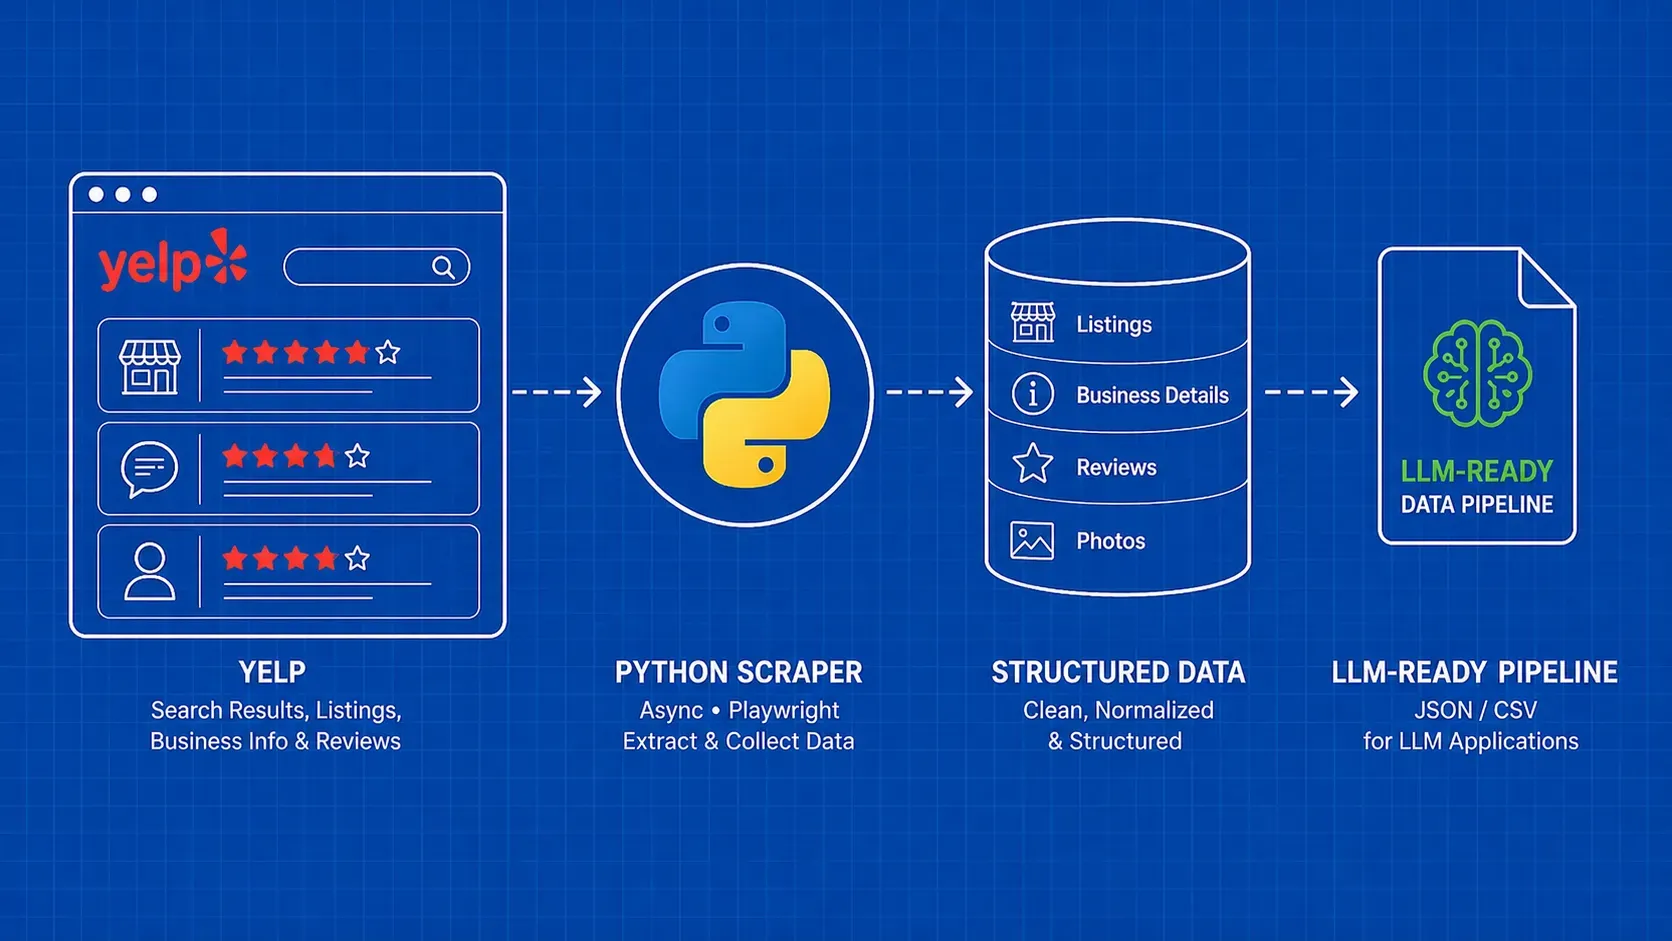
Comment gratter Yelp avec Python : Critiques, listes et pipelines de données prêts pour le LLM
Guides

Comment gratter Yelp avec Python : Critiques, listes et pipelines de données prêts pour le LLM

TL;DR: Ce guide vous accompagne dans la construction d'un scraper Yelp complet en Python, couvrant les résultats de recherche, les détails de l'entreprise et les commentaires avec un code fonctionnel. Vous apprendrez également à gérer les protections anti-bot, à exporter les données au format CSV ou JSON, et à intégrer les commentaires dans un LLM pour l'analyse des sentiments, ce qu'aucun autre tutoriel sur le scraping Yelp ne couvre.

Raluca Penciuc16 min read
Lire l'article
Scraper les vendeurs proches sur Google Shopping
Guides

Scraper les vendeurs proches sur Google Shopping

TL;DR: Découvrez comment utiliser Node.js et notre API pour extraire les informations des vendeurs à proximité depuis Google Shopping. Extrayez rapidement et facilement des données utiles grâce à notre outil professionnel de scraping Web.

Andrei Ogiolan6 min read
Lire l'article
Formulaire de soumission Puppeteer : Guide Node.js pour 2026
Guides

Formulaire de soumission Puppeteer : Guide Node.js pour 2026

TL;DR: Utilisez page.locator(selector).fill(value) pour les scripts de formulaire de soumission déterministes et rapides de Puppeteer et page.type() lorsque la page surveille les frappes de touches réelles (autocomplétion, anti-bot, validation en direct). Soumettez en cliquant sur le bouton, en appuyant sur Entrée ou en appelant form.requestSubmit(), et attendez toujours un signal de réussite concret au lieu d'un délai fixe.

Mihnea-Octavian Manolache15 min read
Lire l'article
Comment construire un scraper web avec Pyppeteer (Guide 2026)
Guides

Comment construire un scraper web avec Pyppeteer (Guide 2026)

TL;DR: Pyppeteer est le portage Python non officiel de Puppeteer et fonctionne toujours pour piloter un vrai Chromium à partir d'asyncio. Dans ce guide, vous l'installerez, écrirez un scraper web moderne avec Pyppeteer en utilisant asyncio.run et try/finally, gérerez les attentes, les formulaires, les captures d'écran, le scroll infini, les cookies et les proxies, et apprendrez quand migrer vers Playwright, Selenium, ou une API de scraping hébergée.

Mihnea-Octavian Manolache13 min read
Lire l'article
Comment gratter Walmart.com : Guide 2026 de bout en bout
Guides

Comment gratter Walmart.com : Guide 2026 de bout en bout

TL;DR: Ce guide explique comment récupérer les données des produits Walmart de bout en bout en Python, depuis l'analyse du JSON __NEXT_DATA__ caché jusqu'à la mise à l'échelle avec des proxies, des tentatives et des récupérations asynchrones. Il établit également une ligne de démarcation honnête pour savoir quand une API de scraper gérée est meilleure que le bricolage.

Raluca Penciuc15 min read
Lire l'article
Apprenez à extraire les caractéristiques des produits de Google Shopping à l'aide de Node.js
Guides

Apprenez à extraire les caractéristiques des produits de Google Shopping à l'aide de Node.js

TL;DR: Découvrez le guide étape par étape pour extraire les caractéristiques des produits de Google Shopping à l'aide de Node.js. Améliorez vos compétences en extraction de données Web grâce à ce tutoriel.

Andrei Ogiolan6 min read
Lire l'article
Contourner Cloudflare en 2026 : outils, code et tactiques
Guides

Contourner Cloudflare en 2026 : outils, code et tactiques

TL;DR: Cloudflare bloque les scrapers en combinant empreinte TLS, défis JavaScript, analyse comportementale et CAPTCHA Turnstile dans un score de confiance composite. Pour le contourner de manière fiable, il faut franchir toutes les couches à la fois. Ce guide décrit les couches de détection, compare quatre outils (Nodriver, SeleniumBase UC, Camoufox, curl-impersonate) et couvre les stratégies de proxy, la persistance des sessions, le dépannage et la mise à l'échelle en production.

Mihnea-Octavian Manolache17 min read
Lire l'article
Commencez à utiliser Web Stealth Proxy comme un pro : guide de démarrage rapide
Guides

Commencez à utiliser Web Stealth Proxy comme un pro : guide de démarrage rapide

TL;DR: Découvrez comment utiliser Web Stealth Proxy comme un pro grâce à notre guide de démarrage rapide. Suivez nos instructions étape par étape pour optimiser votre utilisation du proxy et renforcer encore davantage votre confidentialité en ligne. Commencez dès aujourd'hui !

Mihai Maxim6 min read
Lire l'article
Comment récupérer des données sur YouTube avec Python en 2026
Guides

Comment récupérer des données sur YouTube avec Python en 2026

TL;DR: Il s'agit d'un manuel de 2026 sur la façon de gratter YouTube avec Python. Vous choisirez la bonne méthode (Data API v3, yt-dlp, points d'extrémité cachés /youtubei/v1/, ou un scraper géré) en utilisant une matrice de décision, puis vous exécuterez du code pour les métadonnées vidéo, les commentaires, les chaînes, la recherche, les Shorts et les transcriptions, avec une section de production sur les proxies, les en-têtes et le 429 backoff pour ne pas être bloqué.

Raluca Penciuc21 min read
Lire l'article
Bibliothèques Python pour navigateurs sans tête pour le Web Scraping en 2026
Guides

Bibliothèques Python pour navigateurs sans tête pour le Web Scraping en 2026

TL;DR: Un navigateur Python sans tête vous permet de rendre JavaScript, de cliquer à travers des SPAs, et de gratter des sites que les clients HTTP ordinaires ne peuvent pas atteindre. Selenium est le choix par défaut le plus sûr, Playwright est le choix moderne pour le nouveau code, Pyppeteer et Splash ont toujours des utilisations de niche, et une API de navigateur hébergée est ce que vous recherchez lorsque les défenses anti-bots ou l'échelle commencent à mordre.

Mihnea-Octavian Manolache23 min read
Lire l'article
Analyseurs HTML et XML en Ruby : une comparaison basée sur la charge de travail
Guides

Analyseurs HTML et XML en Ruby : une comparaison basée sur la charge de travail

TL;DR: En bref : choisissez vos analyseurs HTML et XML en Ruby en fonction de la charge de travail, et non d'un classement générique. Commencez par Nokogiri pour l'analyse générale des arborescences HTML et XML, envisagez Ox ou LibXML Ruby pour les tâches spécifiques à l'XML, et n'ajoutez Selenium que lorsqu'un véritable navigateur doit afficher la page ou interagir avec celle-ci.

Raluca Penciuc15 min read
Lire l'article
Erreurs liées à l'état du proxy : diagnostic de l'étape de la requête ayant échoué
Guides

Erreurs liées à l'état du proxy : diagnostic de l'étape de la requête ayant échoué

TL;DR: Identifiez le saut qui a échoué avant de réessayer une requête proxy. Utilisez les codes d'état, les résultats de la requête CONNECT et les enregistrements de diagnostic sécurisés pour distinguer les échecs du proxy des réponses de la cible.

Mihai Maxim17 min read
Lire l'article
Comment extraire les données d'un tableau HTML en JavaScript et exporter un fichier CSV propre
Guides

Comment extraire les données d'un tableau HTML en JavaScript et exporter un fichier CSV propre

TL;DR: En bref : commencez par déterminer si les lignes du tableau figurent dans la réponse HTTP, proviennent d’une requête de données ou nécessitent un rendu par le navigateur. Utilisez ensuite le script statique Axios et Cheerio ou la méthode Puppeteer spécifique décrite ci-dessous pour extraire le contenu d’un tableau HTML en JavaScript, valider les enregistrements en fonction des en-têtes, dédupliquer les pages et générer un fichier CSV en toute sécurité. Un tableau HTML organise les informations en lignes et en colonnes, généralement à l'aide des éléments <table>, <tr>, <th> et <td>. Extraire un tableau HTML en JavaScript consiste à récupérer ou à afficher ce balisage, à convertir chaque ligne de données en un objet JavaScript, à valider le résultat et à le sérialiser dans un format tel que le CSV.

Mihai Maxim15 min read
Lire l'article
Analyse HTML en Java avec Jsoup
Guides

Analyse HTML en Java avec Jsoup

TL;DR: Jsoup est la bibliothèque par défaut pour l'analyse HTML en Java. Ce guide présente le cycle de vie complet (installation de Maven, chargement d'un document, sélecteurs CSS, traversée du DOM, extraction, modification et sérialisation), ainsi qu'un projet de scraping exécutable, la gestion des erreurs, la pagination et les limites qui vous poussent vers un navigateur sans tête ou une API de scraping.

Mihai Maxim14 min read
Lire l'article
Python Extraire du texte à partir de HTML
Guides

Python Extraire du texte à partir de HTML

TL;DR: Pour extraire du texte Python à partir de HTML, il faut analyser les balises avec un vrai analyseur (BeautifulSoup, lxml.html, ou html-text), supprimer les scripts, les styles et le chrome du site, puis normaliser les espaces blancs et l'Unicode avant de sauvegarder. Ce guide compare les principales bibliothèques, corrige les pièges de nettoyage les plus courants, et se termine par un crawler exécutable qui écrit du JSONL et des fichiers .txt par page.

Mihai Maxim27 min read
Lire l'article
Scraping Web avec Scrapy : 2026 Playbook
Guides

Scraping Web avec Scrapy : 2026 Playbook

TL;DR: Il s'agit d'un guide de bout en bout sur le web scraping avec Scrapy en 2026. Vous installerez Scrapy, prototyperez des sélecteurs dans le shell, construirez un spider de commerce électronique multi-pages, nettoierez les articles avec des Item Loaders, persisterez dans une base de données, renforcerez les paramètres contre les interdictions, et ajouterez Scrapy-Playwright pour les pages rendues en JavaScript.

Mihai Maxim18 min read
Lire l'article
JavaScript avec Scrapy : les données d'abord, le rendu uniquement lorsque cela est nécessaire
Guides

JavaScript avec Scrapy : les données d'abord, le rendu uniquement lorsque cela est nécessaire

TL;DR: En bref : l'utilisation de JavaScript avec Scrapy ne nécessite pas toujours un navigateur. Commencez par analyser la réponse brute, les requêtes réseau et l'état de la page intégrée ; n'ajoutez « scrapy-playwright » que lorsque les données cibles dépendent réellement de l'exécution dans un navigateur, puis gérez de manière réfléchie les temps d'attente, les interactions, le nettoyage et la concurrence.

Mihai Maxim13 min read
Lire l'article
Axios : les en-têtes en 2026 : le manuel du développeur
Guides

Axios : les en-têtes en 2026 : le manuel du développeur

TL;DR: Axios définit des en-têtes à travers cinq couches, la configuration par requête, les valeurs par défaut globales, les instances axios.create(), les intercepteurs de requêtes et de réponses, et la réponse elle-même. Ce guide présente chaque couche avec des extraits v1 exécutables, puis corrige les quatre bogues qui piquent tout le monde : les limites multipartites, les cookies CORS, les certificats auto-signés, et le casing des en-têtes.

Mihnea-Octavian Manolache18 min read
Lire l'article
Le web scraping avec JavaScript et Node.js : un guide pratique
Guides

Le web scraping avec JavaScript et Node.js : un guide pratique

TL;DR: Extrayez des données du Web avec JavaScript et Node.js : récupérez et analysez des pages à l'aide des fonctions natives `fetch` et `Cheerio`, explorez les sites paginés de manière respectueuse, appelez des points de terminaison JSON cachés, affichez les pages avec Playwright ou Puppeteer, testez votre analyseur hors ligne et transmettez les pages bloquées à une API de scraping sans avoir à la réécrire.

Robert Sfichi27 min read
Lire l'article
Web scraping avec Ruby : Faraday, Nokogiri, Selenium
Guides

Web scraping avec Ruby : Faraday, Nokogiri, Selenium

TL;DR: Le « web scraping » avec Ruby consiste à récupérer du contenu web, à identifier les informations utiles dans un code HTML ou un document affiché par un navigateur, puis à convertir ces informations en enregistrements structurés à l'aide de code Ruby. L'approche la plus facile à maintenir consiste à utiliser la combinaison d'outils la plus légère possible permettant d'accéder aux données de manière fiable.

Raluca Penciuc20 min read
Lire l'article
Web scraping avec PHP en 2026 : bibliothèques et code
Guides

Web scraping avec PHP en 2026 : bibliothèques et code

TL;DR: PHP est un langage parfaitement adapté au web scraping, grâce à des extensions intégrées comme cURL et DOMDocument, ainsi qu'un riche écosystème Composer qui inclut Guzzle, Symfony DomCrawler, et Symfony Panther pour la navigation sans tête. Ce guide vous guide à travers le flux de travail complet : récupérer les pages, analyser le HTML, stocker les résultats en CSV/JSON/MySQL, gérer les erreurs, et éviter les blocages.

Sorin-Gabriel Marica20 min read
Lire l'article
Cheerio Web Scraping sous Node.js : la fonction load() pour un scraper testé
Guides

Cheerio Web Scraping sous Node.js : la fonction load() pour un scraper testé

TL;DR: En bref : Cheerio est un analyseur HTML rapide pour Node.js doté d'une API de type jQuery ; il convient au web scraping quand les données sont déjà dans le HTML brut de la page. Utilisez fetch avec Cheerio pour les pages statiques, appelez directement le JSON de la page lorsqu'elle charge ses données ainsi, et ne passez par un navigateur que si JavaScript construit le contenu. Ce guide construit un scraper testé avec pagination, relances et export JSON ou CSV.

Raluca Penciuc22 min read
Lire l'article
XPath Cheat Sheet for Web Scraping : Syntaxe, axes et code réel
Guides

XPath Cheat Sheet for Web Scraping : Syntaxe, axes et code réel

TL;DR: Cet aide-mémoire XPath couvre la syntaxe, les prédicats, les axes et les fonctions dont vous avez réellement besoin pour le web scraping, ainsi qu'une table de traduction CSS-to-XPath et des exemples exécutables avec Puppeteer et Scrapy. Utilisez-la comme référence de bureau la prochaine fois qu'un sélecteur CSS se casse discrètement sur un site dont vous dépendez.

Mihai Maxim15 min read
Lire l'article
Comment utiliser cURL avec Python en 2026
Guides

Comment utiliser cURL avec Python en 2026

TL;DR: Il y a trois façons raisonnables d'utiliser cURL avec Python : utiliser le binaire curl avec subprocess, se lier à libcurl par l'intermédiaire de PycURL, ou ignorer complètement curl et utiliser la bibliothèque Requests. Savoir comment utiliser cURL avec Python signifie connaître les trois. Ce guide vous donne des exemples exécutables pour les trois, une table de traduction des drapeaux curl vers Python, et une matrice de décision afin que vous puissiez choisir le bon outil dès la première fois.

Andrei Ogiolan15 min read
Lire l'article
Découvrez comment utiliser Node-Fetch (NPM) pour effectuer des requêtes HTTP dans Node.js
Guides

Découvrez comment utiliser Node-Fetch (NPM) pour effectuer des requêtes HTTP dans Node.js

TL;DR: Découvrez comment utiliser le tout nouveau module node-fetch pour effectuer des requêtes HTTP directement depuis Node.js. Node-fetch est l'équivalent de l'API Fetch en JavaScript.

Sorin-Gabriel Marica9 min read
Lire l'article
Les 6 meilleurs clients HTTP Python pour le web scraping
Guides

Les 6 meilleurs clients HTTP Python pour le web scraping

TL;DR: Choisissez le client HTTP Python le mieux adapté à votre scraper. Comparez Requests, HTTPX, aiohttp, urllib3, curl_cffi et Niquests, à l'aide d'exemples concrets et de conseils sur la fiabilité.

Mihnea-Octavian Manolache23 min read
Lire l'article
Comment gratter LinkedIn en 2026 : un guide en Python
Guides

Comment gratter LinkedIn en 2026 : un guide en Python

TL;DR: Scraping LinkedIn signifie travailler autour d'un mur d'authentification agressif, le suivi comportemental, et TLS fingerprinting. Ce guide vous donne un arbre de décision méthode par page, des modèles Python pour les emplois, les profils et les entreprises (API cachée, JSON-LD, Selenium si nécessaire), et une liste de contrôle anti-blocage consolidée pour 2026.
Suciu Dan14 min read
Lire l'article
12 meilleurs outils gratuits de scraping web en 2026 : comparés
Guides

12 meilleurs outils gratuits de scraping web en 2026 : comparés

TL;DR: Les 12 meilleurs outils de web scraping gratuits en 2026 sont répartis en quatre catégories : API gérées avec des crédits gratuits, frameworks open-source, extensions de navigateur sans code et extracteurs d'IA. Choisissez d'abord en fonction du cas d'utilisation (scrape ponctuel ou pipeline programmé), puis en fonction du niveau de compétence. La plupart des niveaux gratuits couvrent l'évaluation, pas la production ; dès que votre taux de réussite tombe en dessous de ~90% ou que vous passez plus d'heures sur les blocs que sur les données, il est temps de passer à une API payante.

Suciu Dan31 min read
Lire l'article
Alternatives à l'API Yahoo Finance : guide à l'intention des développeurs
Guides

Alternatives à l'API Yahoo Finance : guide à l'intention des développeurs

TL;DR: Comparez les fournisseurs de données de marché certifiés, puis procédez à la migration en définissant clairement les exigences relatives aux flux de données, au fuseau horaire, aux ajustements, aux licences et à la validation.

Raluca Penciuc16 min read
Lire l'article
Le Web Scraping est-il légal en 2026 ? Cadre de conformité
Guides

Le Web Scraping est-il légal en 2026 ? Cadre de conformité

TL;DR: Le web scraping est-il légal ? En général, oui, mais avec des réserves. La légalité dépend du type de données, du chemin d'accès, des juridictions concernées et de ce que vous faites du résultat. Ce guide vous donne un verdict direct, un cadre de cinq minutes avant le scraping, les cas qui comptent et une liste de contrôle que vous pouvez exécuter avant d'envoyer le produit.

Suciu Dan16 min read
Lire l'article
Les 9 meilleures API de recherche d'images Google
Guides

Les 9 meilleures API de recherche d'images Google

TL;DR: Découvrez les 9 meilleurs outils de l'API Google Image Search pour un scraping d'images efficace. Apprenez à optimiser votre recherche d'images et à améliorer votre collecte de données grâce à ces API performantes.

Raluca Penciuc10 min read
Lire l'article
Comment tester les proxy : 6 méthodes pratiques
Guides

Comment tester les proxy : 6 méthodes pratiques

TL;DR: Les mauvais proxys coûtent cher. Ils consomment de la bande passante, déclenchent des interdictions et corrompent silencieusement les données dont dépendent vos scrapers. Ce guide montre comment tester les proxies sur cinq signaux de santé (connectivité, IP de sortie, vitesse, anonymat et réputation) en utilisant ping, curl, des vérificateurs en ligne, des bases de données d'IP et un script Python réutilisable que vous pouvez intégrer dans votre pipeline CI.

Robert Munceanu12 min read
Lire l'article
Les meilleures API de web scraping en 2026 : comparaison de 12 solutions selon leurs fonctionnalités et leur coût
Guides

Les meilleures API de web scraping en 2026 : comparaison de 12 solutions selon leurs fonctionnalités et leur coût

TL;DR: Le choix de la meilleure API de web scraping dépend du type de tâche : pages statiques, applications à forte intensité JavaScript, sites protégés, résultats de recherche, données de commerce électronique ou contenu au format Markdown compatible avec les modèles de langage de grande envergure (LLM). Ce guide compare 12 fournisseurs en fonction de leur domaine d'application et de leur modèle tarifaire, montre comment les multiplicateurs de crédits et la facturation des requêtes échouées modifient le coût réel par page utilisable, et vous fournit un framework Python pour tester votre sélection sur vos propres URL avant de vous engager.

Suciu Dan32 min read
Lire l'article
Avis sur webscraper.io : tarifs, limites et quand changer de service
Guides

Avis sur webscraper.io : tarifs, limites et quand changer de service

TL;DR: En bref : Web Scraper de webscraper. io est une extension gratuite pour Chrome et Firefox, plus le service payant Web Scraper Cloud ; c'est un bon choix pour les tâches récurrentes de petite et moyenne taille sur des sites publics ordinaires. Gardez-le si quelques personnes actualisent une poignée de sites chaque jour ou chaque semaine et que quelqu'un maintient les sélecteurs.

Suciu Dan21 min read
Lire l'article
Cookies HTTP : guide du développeur pour l'extraction des sessions
Guides

Cookies HTTP : guide du développeur pour l'extraction des sessions

TL;DR: Découvrez comment les fichiers « cookie jars », les politiques de navigateur et la propriété des sessions influencent les réponses extraites. Apprenez à diagnostiquer les échecs d'authentification sans divulguer d'identifiants.

Gabriel Cioci15 min read
Lire l'article
Applications de collecte de données : comparaison de quatre workflows concrets
Guides

Applications de collecte de données : comparaison de quatre workflows concrets

TL;DR: Comparez Octoparse, ParseHub, Web Scraper et Apify en fonction de la configuration des projets, de l'exécution, des exportations et de la maintenance, à travers un projet pilote qui teste l'ensemble du processus de livraison.

Mihnea-Octavian Manolache16 min read
Lire l'article
Extraction automatisée de données sur le Web : créez des tâches que vous pouvez récupérer
Guides

Extraction automatisée de données sur le Web : créez des tâches que vous pouvez récupérer

TL;DR: Créez des collecteurs planifiés dotés d’identités d’exécution explicites, de tentatives de réessai limitées, d’une validation et d’une livraison sans risque de redoublement. Découvrez comment remédier aux défaillances sans masquer les données manquantes.

Andrei Ogiolan18 min read
Lire l'article
Alternatives à Scrapebox : cinq outils adaptés à différentes tâches
Guides

Alternatives à Scrapebox : cinq outils adaptés à différentes tâches

TL;DR: Trouvez la solution de remplacement adaptée pour les audits de sites, l'exploration personnalisée, les interactions avec les navigateurs, l'extraction visuelle ou le nettoyage des ensembles de données, puis validez cette transition à l'aide d'un projet pilote.

Raluca Penciuc15 min read
Lire l'article
Outils de récupération de contenu : optez pour la fidélité du texte
Guides

Outils de récupération de contenu : optez pour la fidélité du texte

TL;DR: Choisissez un extracteur adapté à des articles présentant des mises en page variées ou respectant des règles de modèle précises, puis testez la fidélité du texte, les métadonnées, la structure et la gestion des erreurs sur votre propre corpus.

Robert Munceanu16 min read
Lire l'article
Alternatives à Puppeteer : scraping et tests
Guides

Alternatives à Puppeteer : scraping et tests

TL;DR: Puppeteer est excellent pour l'automatisation rapide de Chromium, mais son enfermement dans un seul navigateur, sa mise à l'échelle gourmande en ressources et l'absence de support anti-bot intégré poussent de nombreuses équipes à se tourner vers d'autres solutions. Ce guide présente les meilleures alternatives à Puppeteer en fonction des cas d'utilisation (scraping, tests E2E, QA multi-navigateurs, mobile), fournit un tableau comparatif côte à côte et se termine par un cadre de décision afin que vous puissiez choisir le bon outil sans tâtonnements.

Suciu Dan18 min read
Lire l'article
Screen scraping de sites web avec Playwright
Guides

Screen scraping de sites web avec Playwright

TL;DR: Créez un collecteur de navigateur doté d'une préparation explicite, d'enregistrements validés et de conditions d'arrêt fiables. Découvrez dans quels cas l'extraction du DOM est préférable aux captures d'écran et à la reconnaissance optique de caractères (OCR).

Raluca Penciuc14 min read
Lire l'article
Alternatives à Charles Proxy : Fiddler, Proxyman, mitmproxy
Guides

Alternatives à Charles Proxy : Fiddler, Proxyman, mitmproxy

TL;DR: Comparez mitmproxy, Fiddler Everywhere, HTTP Toolkit et Proxyman en fonction des tâches de débogage. Réalisez un test contrôlé pour vérifier la capture des données, le partage des preuves et le nettoyage des certificats.

Robert Sfichi15 min read
Lire l'article
Alternative à import.io : choisir en fonction du flux de traitement des données
Guides

Alternative à import.io : choisir en fonction du flux de traitement des données

TL;DR: Comparez Octoparse, Browse AI, Apify et Scrapy en fonction de la responsabilité de l'extraction et des besoins en matière de livraison. Mettez en place un projet pilote permettant de vérifier l'exhaustivité, l'actualité et l'état de préparation à la migration.

Ștefan Răcilă17 min read
Lire l'article
Site Scraper : créez un collecteur que vous pouvez valider
Guides

Site Scraper : créez un collecteur que vous pouvez valider

TL;DR: Concevez un collecteur de sites Web, de la définition des enregistrements à la livraison vérifiée. Délimitez le périmètre des sources, choisissez un modèle d'exécution, validez les observations et récupérez les exécutions incomplètes.

Mihnea-Octavian Manolache16 min read
Lire l'article
Alternatives à PhantomJS : quelles solutions utiliser aujourd'hui et comment effectuer la migration ?
Guides

Alternatives à PhantomJS : quelles solutions utiliser aujourd'hui et comment effectuer la migration ?

TL;DR: Le développement de PhantomJS a pris fin en 2018. Choisissez une alternative en fonction des fonctionnalités de votre script, remplacez les appels à PhantomJS par ceux de Playwright ou de Puppeteer, puis supprimez les anciennes dépendances.

Sorin-Gabriel Marica21 min read
Lire l'article
8 alternatives à Scrapy pour 2026 : choisissez en fonction des goulots d'étranglement, des coûts et des risques
Guides

8 alternatives à Scrapy pour 2026 : choisissez en fonction des goulots d'étranglement, des coûts et des risques

TL;DR: En bref : le bon choix dépend du goulot d'étranglement de Scrapy : rendu, blocage, adéquation du langage ou opérations. Conservez ou étendez les robots en bon état si possible ; utilisez des outils de navigateur pour les pages interactives, des plateformes hébergées pour les opérations, des outils légers pour les tâches statiques délimitées et des API gérées si l’infrastructure de requêtes est la contrainte. Validez la sélection avec un modèle de coûts et une preuve de concept représentative.

Mihai Maxim22 min read
Lire l'article
Alternative aux outils de scraping : adapter d'abord le workflow
Guides

Alternative aux outils de scraping : adapter d'abord le workflow

TL;DR: Comparez Octoparse, Browse AI, Apify et Playwright en fonction de leur modèle de création. Préservez la navigation, l'identité de l'enregistrement et le comportement de diffusion lors du remplacement de Web Scraper.

Suciu Dan16 min read
Lire l'article
Alternative à WebHarvy : comparatif des workflows de gestion des données produit
Guides

Alternative à WebHarvy : comparatif des workflows de gestion des données produit

TL;DR: Comparez Octoparse, ParseHub, Web Scraper et Apify pour l'extraction de données sur les produits. Vérifiez les variantes, les offres, les articles manquants et les exportations avant de remplacer WebHarvy.

Suciu Dan16 min read
Lire l'article
Alternative à Niche Scraper : optez pour de meilleures données de recherche
Guides

Alternative à Niche Scraper : optez pour de meilleures données de recherche

TL;DR: Comparez les différentes options de recherche sur les produits en fonction des tâches, de la provenance des données et des besoins en matière de livraison. Mettez en place un test reproductible sans confondre la demande estimée avec les ventes vérifiées.

Mihnea-Octavian Manolache16 min read
Lire l'article
Meilleures alternatives à Wget : Comparaison des outils de téléchargement CLI modernes
Guides

Meilleures alternatives à Wget : Comparaison des outils de téléchargement CLI modernes

TL;DR: Wget est fiable mais vieillissant. Si vous avez besoin de téléchargements parallèles, prenez aria2. Pour une large couverture des protocoles et l'écriture de scripts, curl est la solution. Vous voulez un workflow de test d'API plus convivial ? HTTPie (ou son frère Rust xh) convient parfaitement. Et si vous voulez le chemin de mise à jour le plus proche, wget2 ajoute HTTP/2, le multithreading, et un système de plugin tout en gardant les mêmes modèles de commandes que vous connaissez déjà.

Anda Miuțescu12 min read
Lire l'article
Comparaison de 5 alternatives à node-fetch : Native Fetch, Axios, Got, Ky et SuperAgent
Guides

Comparaison de 5 alternatives à node-fetch : Native Fetch, Axios, Got, Ky et SuperAgent

TL;DR: En bref : commencez par utiliser la fonction native `Fetch` sur les versions de Node.js prises en charge, puis ajoutez une dépendance uniquement si celle-ci permet de remplacer du code personnalisé pertinent. Axios privilégie la facilité d’utilisation sur plusieurs environnements d’exécution, Got offre un contrôle plus poussé spécifique à Node.js, Ky améliore l’ergonomie de `Fetch`, et SuperAgent est adapté aux workflows fluides de gestion de formulaires et de fichiers. Quel que soit votre choix, préservez le comportement en matière d’état, de délai d’expiration, de réessai, de cookies et de flux lors de la migration.

Raluca Penciuc19 min read
Lire l'article
Web scraping en R : guide pratique avec rvest et httr2
Guides

Web scraping en R : guide pratique avec rvest et httr2

TL;DR: Apprenez le web scraping en R avec rvest et httr2 : analyser pages et tableaux, suivre la pagination, gérer JavaScript, appeler une API de scraping et tester avec des fixtures.

Raluca Penciuc23 min read
Lire l'article
Profit Scraper : vérifier la disponibilité et remplacer le workflow
Guides

Profit Scraper : vérifier la disponibilité et remplacer le workflow

TL;DR: Vérifiez l'identité actuelle du service avant de suivre les anciennes recommandations de Profit Scraper. Mettez en place un nouveau processus pour le référencement des données, l'analyse des prix de vente et l'établissement d'hypothèses de coûts transparentes.

Mihai Maxim15 min read
Lire l'article
Le guide complet pour se lancer dans le web scraping avec Elixir
Guides

Le guide complet pour se lancer dans le web scraping avec Elixir

TL;DR: Voici le guide complet du web scraping avec Elixir. Découvrez comment créer un outil de web scraping à l'aide de l'un des meilleurs langages de programmation en matière de concurrence.

Robert Sfichi9 min read
Lire l'article
Apprendre le web scraping avec Rust
Guides

Apprendre le web scraping avec Rust

TL;DR: Rust est un langage rapide et économe en mémoire. Mais comment gère-t-il le web scraping ? Consultez ce guide destiné aux débutants et découvrez comment l'utiliser pour créer un outil de web scraping basique.

Mihai Maxim7 min read
Lire l'article
Web scraping avec Go : créer un scraper HTML fiable
Guides

Web scraping avec Go : créer un scraper HTML fiable

TL;DR: Créez un scraper en Go qui extrait les fiches de livres au format JSON. Suivez un exemple testé avec goquery, puis prévoyez la pagination, l'utilisation de Colly, le rendu dans le navigateur et la gestion des erreurs.

Sorin-Gabriel Marica16 min read
Lire l'article
Alternative à Octoparse : comparez les outils dont vous disposez
Guides

Alternative à Octoparse : comparez les outils dont vous disposez

TL;DR: Comparez Web Scraper, Browse AI, Apify et Scrapy en fonction du volume de travail conservé. Réalisez un test de réparabilité contrôlé et vérifiez que la livraison est complète avant de remplacer Octoparse.

Gabriel Cioci16 min read
Lire l'article
Extraction de données Web en C# avec HttpClient, AngleSharp et Playwright
Guides

Extraction de données Web en C# avec HttpClient, AngleSharp et Playwright

TL;DR: En bref : Pour le web scraping en C#, commencez sur .NET 10 avec le HttpClient intégré pour télécharger les pages et AngleSharp pour analyser le HTML avec des sélecteurs CSS. Choisissez HtmlAgilityPack si vous préférez XPath ou maintenez du code plus ancien, et ajoutez Playwright pour .NET lorsque JavaScript construit la page. Ce guide construit un scraper avec des relances respectueuses, un crawl borné, un export CSV et JSON et des tests hors ligne.

Sorin-Gabriel Marica31 min read
Lire l'article
Web scraping Node.js : 6 bibliothèques comparées
Guides

Web scraping Node.js : 6 bibliothèques comparées

TL;DR: Les meilleurs scrapeurs web Node.js en 2026 se divisent en deux camps : les clients HTTP comme Axios et Superagent pour les pages statiques, et les navigateurs sans tête comme Puppeteer et Playwright pour les sites à forte composante JavaScript. Choisissez en fonction du flux de travail et non de la popularité, et transférez le rendu à une API de scraping gérée une fois que les défenses anti-bots ou l'échelle commencent à consommer votre temps d'ingénierie.

Suciu Dan13 min read
Lire l'article
Alternative à ProxyScrape : choisissez la bonne solution de remplacement
Guides

Alternative à ProxyScrape : choisissez la bonne solution de remplacement

TL;DR: Comparez les réseaux de proxy et les services de récupération gérés en fonction du comportement par session, de la provenance des données et du coût par enregistrement accepté. Mettez en place un test contrôlé et un plan de migration réversible.

Ștefan Răcilă15 min read
Lire l'article
Comparaison de 7 alternatives à Axios pour les navigateurs, Node.js et le scraping
Guides

Comparaison de 7 alternatives à Axios pour les navigateurs, Node.js et le scraping

TL;DR: En bref : utilisez Fetch natif pour une solution de base avec peu de dépendances, Ky pour bénéficier de l'ergonomie de Fetch, Got ou SuperAgent pour un comportement client plus riche, et Alova lorsque l'état des requêtes front-end constitue une exigence réelle. Ne choisissez Puppeteer ou une API de scraping gérée que lorsque le rendu, les interactions, les proxys ou les systèmes anti-bots rendent le transport HTTP classique insuffisant.

Raluca Penciuc18 min read
Lire l'article
Comment extraire les données des pages eBay pour analyser les prix
Guides

Comment extraire les données des pages eBay pour analyser les prix

TL;DR: Pour les nouveaux produits, il est difficile de fixer le bon prix. Il existe pourtant une solution : extraire les données des géants du commerce électronique et fixer les prix en s'appuyant sur des données fiables.

Gabriel Cioci5 min read
Lire l'article
Comment faire du Web Scrape avec Puppeteer et NodeJS 2026 Guide
Guides

Comment faire du Web Scrape avec Puppeteer et NodeJS 2026 Guide

TL;DR: Puppeteer vous donne le contrôle total d'une instance Chrome sans tête à partir de Node.js, ce qui en fait l'outil de référence pour le scraping de pages rendues en JavaScript. Ce guide vous guide à travers l'installation, l'extraction basée sur des sélecteurs, le défilement infini, la connexion par formulaire, l'interception des requêtes, les plugins furtifs, l'exportation de données structurées et le déploiement Docker, afin que vous puissiez passer d'un script jouet à un scraper de niveau de production.

Gabriel Cioci19 min read
Lire l'article
Web scraping immobilier : comment collecter des données immobilières avec Python
Guides

Web scraping immobilier : comment collecter des données immobilières avec Python

TL;DR: Apprenez à extraire des données immobilières avec Python : choisir une source, analyser les annonces et le JSON-LD, vérifier les conditions des portails et obtenir les prix via l'open data.

Robert Munceanu25 min read
Lire l'article
Tutoriel BeautifulSoup : Construire un vrai scraper Python à partir de zéro
Guides

Tutoriel BeautifulSoup : Construire un vrai scraper Python à partir de zéro

TL;DR: Ce tutoriel BeautifulSoup vous guide à travers un scraper Python complet, de l'installation du pip à un script renforcé qui pagine Hacker News, exporte au format CSV et JSON, et reste suffisamment poli pour ne pas être bloqué. Chaque extrait est exécutable, et nous indiquons les moments exacts où BeautifulSoup n'est pas le bon outil.

Sorin-Gabriel Marica20 min read
Lire l'article
Web scraping en Java : créer un scraper fiable
Guides

Web scraping en Java : créer un scraper fiable

TL;DR: En bref : commencez par utiliser HttpClient et Jsoup lorsque les données sont présentes dans le code HTML renvoyé, appelez une source JSON exposée le cas échéant, et n'ajoutez le rendu ou Selenium que pour les états dépendants du navigateur. Ce tutoriel Java sur le web scraping développe une base de code Java 21 en abordant la pagination, la limitation de la concurrence, les tentatives de réessai, les sessions, la validation et la sortie durable.

Raluca Penciuc34 min read
Lire l'article
Web Scraping avec Selenium : Tutoriel Python pas à pas
Guides

Web Scraping avec Selenium : Tutoriel Python pas à pas

TL;DR: Selenium vous permet d'explorer des sites web à forte composante JavaScript en pilotant un véritable navigateur à partir d'un code Python. Ce tutoriel vous accompagne dans toutes les phases : installation de Selenium, configuration de Chrome, localisation et interaction avec les éléments, gestion des attentes et de la pagination, exportation de données propres, et mise à l'échelle de votre scraper avec des proxies, Selenium Grid, et des alternatives basées sur des API.

Robert Sfichi34 min read
Lire l'article
Extraction de données sur le Web en C et C++ avec libcurl et lexbor
Guides

Extraction de données sur le Web en C et C++ avec libcurl et lexbor

TL;DR: Extrayez des données de sites web en C et C++ avec libcurl et lexbor : créez un robot d'indexation C++20 « poli » à l'aide de CMake et vcpkg, exportez des fichiers CSV et JSON propres, gérez les pages JavaScript de trois façons différentes et exécutez le même robot d'indexation en C pur.

Raluca Penciuc30 min read
Lire l'article
Extraction de données à partir de plans de site : découvrez des URL en respectant des limites de sécurité
Guides

Extraction de données à partir de plans de site : découvrez des URL en respectant des limites de sécurité

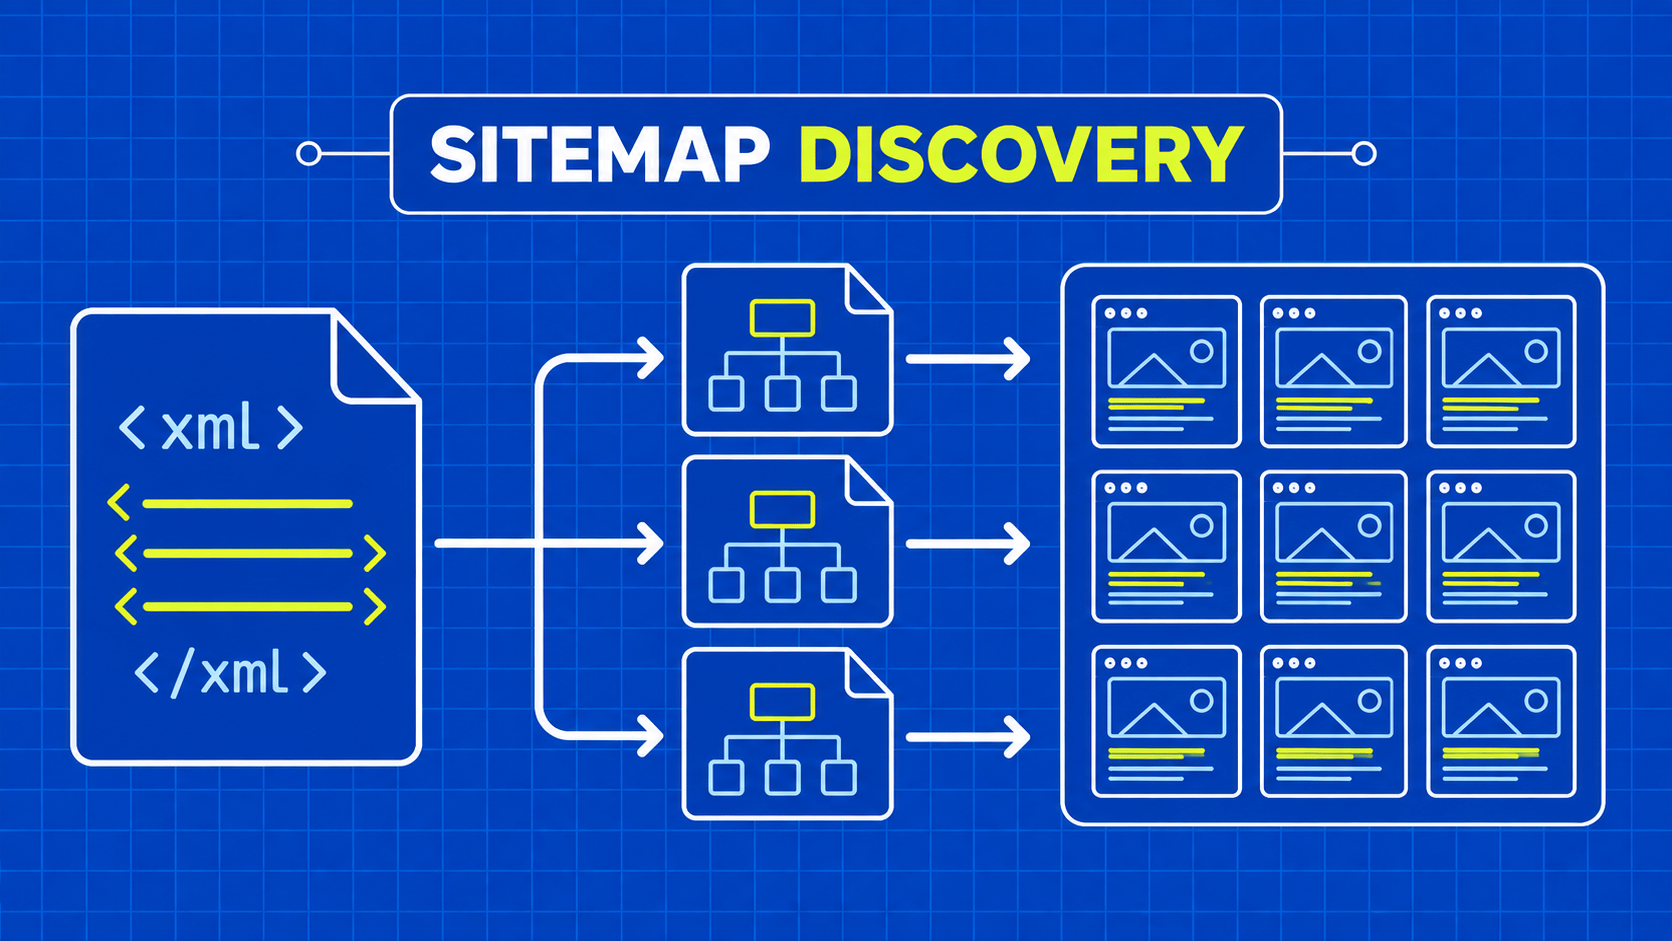
TL;DR: Transformez les index de plans de site en une file d'attente de découverte d'URL traçables. Découvrez l'analyse syntaxique tenant compte des espaces de noms, les limites des protocoles, les mises en garde relatives à l'actualité des données et les limites de sécurité pour les URL non fiables.

Robert Munceanu16 min read
Lire l'article
Comment utiliser WebScrapingAPI : guide de l'API de scraping et de Web MCP
Guides

Comment utiliser WebScrapingAPI : guide de l'API de scraping et de Web MCP

TL;DR: Envoyez votre première requête à l'API WebScrapingAPI en indiquant la clé dans une variable d'environnement, puis ajoutez le rendu JavaScript, le ciblage géographique, les règles d'extraction et les tâches asynchrones uniquement lorsque la cible en a besoin. Ce guide aborde tous les codes d'erreur documentés, le suivi des coûts par appel, les forfaits en vigueur à partir d'octobre 2026, les cas où il est préférable d'opter pour l'API Browser, SERP, Crawl ou Data, ainsi que la manière de connecter des agents IA via Web MCP.

Robert Munceanu29 min read
Lire l'article
Web scraping avec Python en 2026 : guide du développeur
Guides

Web scraping avec Python en 2026 : guide du développeur

TL;DR: En bref : voici un guide pratique sur le web scraping en Python qui commence par un arbre de décision, puis aborde successivement Requests et Beautiful Soup, XPath avec lxml, Playwright, Selenium, Scrapy, ainsi qu'une API de scraping pour les cibles difficiles. À la fin, vous disposerez d'un code fonctionnel, d'un guide pour contourner les blocages, de modèles de stockage compatibles avec les grands modèles de langage (LLM) et d'une liste de contrôle pour la mise en production.

Raluca Penciuc35 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.