
Aller au contenu
Retour au blog

Web scraping immobilier : comment collecter des données immobilières avec Python

Robert MunceanuDernière mise à jour le 25 min read
Web scraping immobilier : comment collecter des données immobilières avec Python
En bref : le web scraping immobilier collecte des annonces, des prix et des caractéristiques de biens sur des sites web pour en faire des données structurées. Avant de scraper, cherchez s'il existe de l'open data, un flux MLS ou une API de données, car Zillow, Realtor.com et Redfin interdisent la collecte automatisée dans leurs conditions d'utilisation. Ce guide couvre le modèle de données, les sources, les limites juridiques, le code Python et les contrôles qualité.

Tôt ou tard, quelqu'un vous demande de « récupérer des données immobilières » sur un marché : des prix affichés pour des comparables, le stock d'annonces pour un rapport, ou un flux des nouvelles mises en vente. Les données immobilières sont partout sur le web, si bien que le scraping semble la réponse évidente. Deux erreurs font pourtant échouer la plupart de ces projets. La première consiste à scraper un portail dont les conditions l'interdisent. La seconde, à prendre un prix affiché pour un prix de vente et à bâtir toute l'analyse sur le mauvais chiffre.

Commencez par la décision : quelles données existent, quelle source convient à chaque besoin et ce que les grands portails autorisent. Construisez ensuite un scraper Python avec requests, BeautifulSoup et pandas sur une page d'exemple que vous contrôlez, puis récupérez de vrais prix immobiliers à partir d'un fichier open data gratuit.

Qu'est-ce que le web scraping immobilier ?

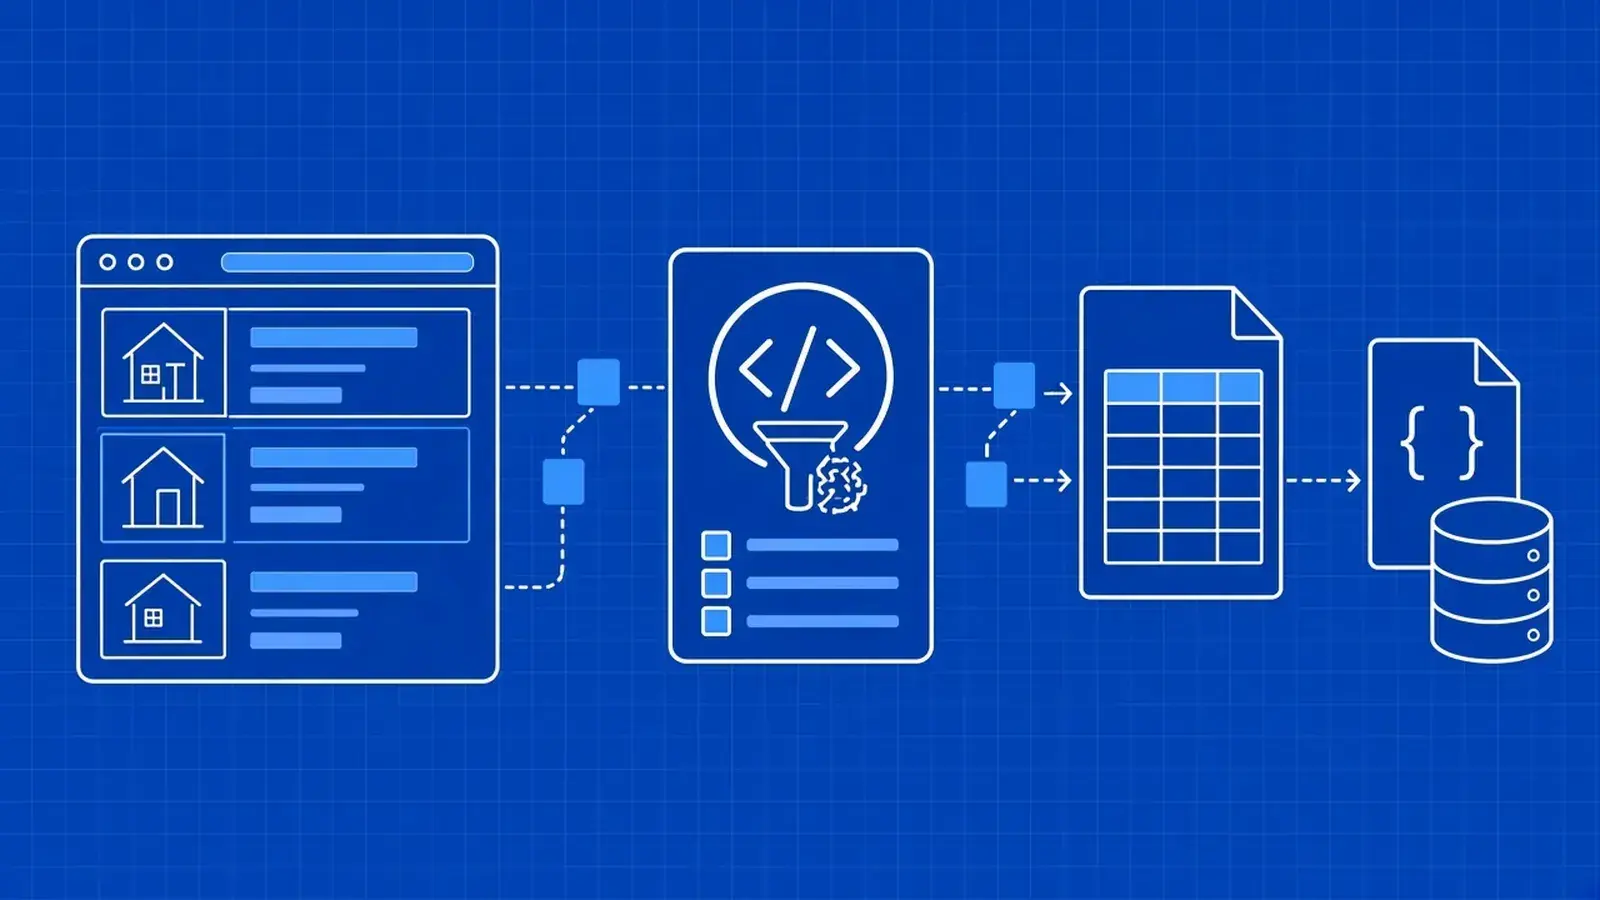
Le web scraping immobilier est la collecte automatisée d'informations sur des biens à partir de sites web : prix affichés, adresses, nombre de chambres, surface, photos ou durée de mise en vente. Un scraper récupère les pages, en extrait les champs et les enregistre sous forme de lignes dans un fichier CSV ou une base de données, pour comparer des marchés ou suivre leur évolution.

Le scraping n'est qu'un moyen parmi d'autres d'obtenir ces informations. Les mêmes chiffres existent souvent sous forme de téléchargements gratuits, de flux MLS sous licence ou d'API de données, et ces options sont généralement moins coûteuses à maintenir et plus sûres. Comparez-les avant d'écrire la moindre ligne de code.

Quelles données immobilières peut-on scraper ?

La plupart des pages d'annonce affichent l'adresse, le prix demandé ou le loyer, le nombre de chambres et de salles de bains, la surface habitable, la surface du terrain, le type de bien, le statut, la date de mise en ligne, les photos et l'agent responsable. Ces champs décrivent trois choses différentes : le bien, l'annonce qui le présente et chaque prix observé à une date donnée.

Un même logement peut être mis en vente trois fois en cinq ans, par deux agences, à cinq prix différents. Si vous stockez tout cela sur une seule ligne, vous perdez l'historique qui fait la valeur des données. Modélisez-les plutôt en trois couches :

Couche

Ce que c'est

Exemples de champs

Clé de dédoublonnage

Bien

Le logement physique, qui change rarement

Adresse, numéro de parcelle, chambres, salles de bains, surface habitable, surface du terrain, année de construction

Adresse normalisée ou identifiant de parcelle

Épisode d'annonce

Une période pendant laquelle le bien était sur le marché

Site source, identifiant d'annonce, statut, date de mise en ligne, agence, URL

Source + identifiant d'annonce

Observation

Ce que vous avez vu à un instant donné

Prix, statut, durée de mise en vente, collected_at

Identifiant d'annonce + horodatage

Les prix demandent la même rigueur. Une page d'annonce peut afficher plusieurs chiffres qui se ressemblent mais n'ont pas le même sens :

Type de prix

Ce qu'il signifie

Est-ce une transaction ?

Prix demandé (prix affiché)

Ce que le vendeur demande aujourd'hui ; il peut baisser ou augmenter

Non

Prix de vente

Ce que l'acheteur a payé à la signature

Oui

Loyer demandé

Ce que demande un propriétaire par période (mois ou semaine)

Non, et il faut une période

Estimation automatique

La valeur estimée par un modèle, comme un Zestimate

Non

Valeur fiscale

La valeur retenue par une autorité locale pour l'impôt foncier

Non

Gardez chaque type dans sa propre colonne, ou associez un type à chaque prix. Nos données d'annonces immobilières reposent sur la même idée : un bien, les annonces qui le présentent et des observations de prix datées, car une annonce vous dit ce que quelqu'un a demandé, pas ce que quelqu'un a payé.

Une dernière règle avant de collecter quoi que ce soit : les noms, numéros de téléphone et adresses e-mail des agents sont des données personnelles au sens de la plupart des lois sur la vie privée. Laissez-les de côté, sauf si vous avez une raison légitime de les conserver.

Qui utilise le scraping immobilier, et pour quoi faire ?

Les agents et les agences s'en servent pour les ventes comparables et la fixation des prix. Les investisseurs l'utilisent pour repérer des biens sous-évalués et suivre les rendements locatifs. Les équipes proptech construisent des flux d'annonces et des modèles d'estimation. Les chercheurs et les journalistes suivent le stock et les baisses de prix. Les acheteurs et les locataires surveillent un quartier.

L'essentiel est d'associer chaque besoin aux champs qu'il exige et à la source qui les fournit avec le moins de risque :

Cas d'usage

Champs nécessaires

Meilleure première source

Comparables et prix

Prix de vente, chambres, salles de bains, surface, date de vente

Flux MLS via une agence, ou données sous licence

Suivi du marché

Stock, prix affiché médian, durée de mise en vente par zone métropolitaine ou code postal

Téléchargements open data

Sélection d'investissements

Prix demandé, loyer, taxes, historique des prix

API de données ou données sous licence, plus des indices de loyers ouverts

Agrégation d'annonces

Fiches d'annonce complètes avec photos

IDX MLS ou flux sous licence ; le scraping est ici l'option la plus risquée

Génération de leads

Coordonnées des propriétaires ou des agents

Prudence : les règles sur les données personnelles et l'anti-spam s'appliquent

Recherche personnelle

Alertes sur quelques annonces

Les alertes de recherche enregistrée du portail

Si votre besoin correspond aux trois premières lignes, vous n'avez peut-être pas besoin de scraper du tout.

Faut-il scraper, télécharger ou acheter une licence de données immobilières ?

Téléchargez d'abord si vous avez besoin de chiffres à l'échelle du marché : Zillow, Redfin et Realtor.com publient des fichiers de données immobilières gratuits. Prenez une licence de flux MLS ou une API de données si vous avez besoin de fiches d'annonce en volume. Ne scrapez que les pages dont les conditions le permettent, ou vos propres sites, ceux de vos partenaires et les sources publiques qui autorisent l'accès automatisé.

Option

Ce qu'elle fournit

Coût et effort

Difficulté d'accès

Idéale pour

Points de vigilance

Téléchargements open data (Zillow Research, Redfin Data Center, bibliothèque de données Realtor.com, FHFA HPI)

Agrégats par zone métropolitaine, comté et code postal

Gratuit ; quelques lignes de pandas

Aucune

Tendances, rapports, analyse de marché

Mise à jour mensuelle ; pas de lignes au niveau de l'annonce

MLS via RESO Web API

Fiches d'annonce de référence, y compris les ventes conclues

Frais de licence et contrats

Élevée : adhésion, agence ou fournisseur agréé

Agences, sites IDX, estimation

Règles d'affichage et d'utilisation

API ou jeu de données immobilières

Fiches d'annonce structurées sans faire tourner de scrapers

Sur devis

Faible à moyenne

Produits qui ont besoin d'annonces sans équipe dédiée aux parseurs

Conditions du fournisseur, couverture et fraîcheur

Scraper API

HTML rendu des pages que vous avez le droit de collecter ; vous écrivez le parseur

Paiement à la requête

Faible

Sites d'agences, flux partenaires, sources publiques autorisées

Le parseur et la vérification de conformité restent à votre charge

Scraper maison (requests, BeautifulSoup, Playwright)

Tout ce que vous construisez

Votre temps, vos serveurs et vos proxys

Faible au départ, élevée en maintenance

Petits travaux autorisés et prototypes

Pannes, blocages et conformité

La plupart des équipes finissent par combiner les options : l'open data pour la vue d'ensemble du marché, un flux ou une API pour les fiches d'annonce, et un scraper pour la longue traîne de sites autorisés.

Est-il légal de scraper Zillow, Realtor.com et Redfin ?

Leurs conditions d'utilisation l'interdisent. Zillow proscrit les « automated queries », y compris le scraping et le contournement des captchas. Realtor.com interdit le scraping d'écran et de bases de données. Redfin interdit l'exploration automatisée sans autorisation écrite. Enfreindre ces conditions peut entraîner la fermeture de comptes, le blocage d'adresses IP ou des réclamations contractuelles, même là où scraper des pages publiques n'est pas une infraction pénale. Utilisez plutôt leurs téléchargements de données ou une source sous licence.

Voici ce que disent les conditions de chaque grand portail, dans leurs propres termes (citations en anglais, langue d'origine) :

Portail

Ce que disent les conditions

robots.txt

Alternative officielle

Zillow

Les conditions d'utilisation de Zillow (mises à jour le 28 octobre 2025) vous interdisent de mener des « automated queries (including screen and database scraping, spiders, robots, crawlers, bypassing 'captcha' or similar precautions…) ». La copie n'est autorisée que « without the aid of any automated processes ». Les données agrégées Local-Info peuvent être réutilisées avec la mention « Data Provided by Zillow Group ».

Fichier long avec des règles par chemin

Téléchargements Zillow Research ; API Zillow Group selon leurs propres conditions

Realtor.com

Les conditions de service de Realtor.com interdisent le « screen scraping » et le « database scraping », ainsi que la collecte « by automated means » via un « robot, spider, script ». Elles précisent que les réglages du robots.txt n'étendent pas vos droits.

Présent, mais ne prime pas sur les conditions

Bibliothèque de données résidentielles Realtor.com (CSV)

Redfin

Les conditions d'utilisation de Redfin comprennent une clause « No Scrubbing or Scraping » : aucune exploration ni requête automatisée « unless you have received prior express written permission ». Les mentions MLS des pages d'annonce répètent cette interdiction.

Présent, avec des règles par chemin

Téléchargements Redfin Data Center

Rightmove (Royaume-Uni)

Le pied de page des conditions d'utilisation de Rightmove indique : « Rightmove prohibits the scraping of its content. »

L'interdiction s'applique quoi que dise le robots.txt

Demander une autorisation écrite à Rightmove

Autres portails (Zoopla, Idealista, realestate.com.au, Domain, Homes.com)

Lisez la page des conditions de chaque site avant de collecter quoi que ce soit

À vérifier site par site

À vérifier site par site

Aux États-Unis, la Cour d'appel du neuvième circuit a jugé dans l'affaire hiQ Labs v. LinkedIn (2022) que le scraping de pages accessibles publiquement ne constitue probablement pas un « accès non autorisé » au sens du Computer Fraud and Abuse Act. Cette décision n'annule pas les autres règles. Les conditions d'utilisation sont des contrats, les photos et descriptions d'annonces sont protégées par le droit d'auteur, et les lois sur la vie privée protègent les personnes présentes dans les données. Les conditions de Zillow précisent d'ailleurs que le portail ne revendique aucun droit d'auteur sur les images et descriptions d'annonces. Ce droit appartient à leurs propriétaires. Hors des États-Unis, le droit des bases de données de l'UE et le RGPD ajoutent leurs propres limites.

Ceci ne constitue pas un avis juridique. Consultez un avocat avant de collecter des données sur un site dont les conditions l'interdisent. Pour une vue d'ensemble, lisez les bases juridiques du web scraping.

Peut-on scraper les données MLS ?

Non, pas de manière légitime. Les données MLS sont concédées sous licence aux membres, et les règles IDX permettent aux agences d'afficher les annonces aux consommateurs, mais pas à des tiers de les copier. La voie légitime est un flux RESO Web API, que l'on obtient via une adhésion à un MLS, une agence partenaire ou un fournisseur de données agréé. Les pages des portails alimentées par le MLS sont soumises aux mêmes restrictions.

La RESO Web API est une norme, pas une source de données. RESO publie un dictionnaire de données commun, de sorte que des champs comme ListPrice, StandardStatus et BedroomsTotal ont le même sens dans tous les MLS conformes. La Web API fournit ces champs en REST, selon les conventions OData. Il faut tout de même que quelqu'un vous accorde l'accès. Les voies habituelles sont :

  • Agence titulaire (broker of record). Une agence agréée pour laquelle vous travaillez ou avec laquelle vous êtes partenaire demande le flux à son MLS.
  • Fournisseur agréé par le MLS. De nombreux MLS concèdent leurs données à des éditeurs technologiques dans le cadre d'un contrat fournisseur.
  • Agrégateurs multi-MLS. Des entreprises qui ont signé des accords avec de nombreux MLS et revendent un accès normalisé.

Deux autres sigles reviennent souvent. L'IDX (Internet Data Exchange) permet aux agences participantes d'afficher les annonces des autres sur leur propre site. Un VOW (virtual office website) montre davantage de détails aux clients inscrits d'une agence. Ce sont tous deux des programmes d'affichage dont les règles sont fixées par le MLS. Aucun ne permet à un tiers de copier les annonces dans sa propre base de données.

Une fois les identifiants obtenus, une requête ressemble à peu près à ceci. L'exemple ne montre que la structure. Votre MLS vous fournit le point de terminaison et les champs que votre licence vous autorise à lire.

import os

import requests

# Shape only: your MLS or data vendor supplies the endpoint, token, and fields.
BASE_URL = os.environ["RESO_BASE_URL"]
TOKEN = os.environ["RESO_ACCESS_TOKEN"]

response = requests.get(
    f"{BASE_URL}/Property",
    headers={"Authorization": f"Bearer {TOKEN}"},
    params={
        "$select": "ListingKey,ListPrice,StandardStatus,BedroomsTotal,City",
        "$filter": "StandardStatus eq 'Active' and City eq 'Springfield'",
        "$top": 100,
    },
    timeout=30,
)
listings = response.json()["value"]

Les paramètres $select, $filter et $top viennent d'OData : le même schéma fonctionne donc sur tous les serveurs certifiés RESO, à quelques différences près dans la syntaxe des filtres.

Comment fonctionnent les scrapers immobiliers ?

Un scraper immobilier fonctionne en cinq étapes. Il découvre les URL des annonces à partir des pages de recherche ou des sitemaps, récupère chaque page en exécutant le JavaScript si nécessaire, puis extrait les champs des données structurées ou du HTML. Il normalise ensuite les prix, les surfaces et les adresses. Enfin, il stocke chaque observation avec un horodatage, pour que les exécutions suivantes détectent les changements de prix et de statut.

Découvrir les URL des annonces

Les URL des annonces proviennent des sitemaps, des pages de résultats de recherche et des liens de pagination. Les pages de recherche s'arrêtent souvent après un nombre fixe de résultats : découpez donc les grandes zones en zones plus petites, par code postal ou par tranche de prix. N'explorez pas toutes les combinaisons de filtres. Les ordres de tri et les filtres se multiplient en millions d'URL qui répètent pour l'essentiel les mêmes annonces. Lorsqu'un site que vous avez le droit de collecter publie un sitemap, commencez par là : il liste les URL canoniques des annonces, et les dates lastmod indiquent quelles pages ont changé depuis votre dernière exécution.

Récupérer les pages

Certains sites envoient un HTML complet. D'autres construisent la page dans le navigateur avec JavaScript. Récupérez la version statique quand c'est possible, car c'est plus rapide et moins cher. Mettez les réponses en cache, limitez la fréquence des requêtes et respectez le robots.txt, comme le décrit le Robots Exclusion Protocol. N'oubliez pas que le robots.txt n'accorde jamais une autorisation que les conditions refusent.

Extraire les champs

Vérifiez les sources dans cet ordre. D'abord, les blocs JSON-LD qui utilisent des types schema.org comme RealEstateListing ou SingleFamilyResidence. Ensuite, le JSON intégré dans des balises script par le framework front-end du site. Voici comment analyser du JSON intégré dans une page. Enfin, les sélecteurs HTML. Les données structurées changent moins souvent que le balisage, et votre scraper casse moins.

Normaliser et dédoublonner

Transformez « $1,250,000 » en 1250000, avec sa devise. Convertissez toutes les surfaces dans une même unité. Rendez la période du loyer explicite. Normalisez les adresses pour qu'un même logement corresponde d'une source à l'autre, et dédoublonnez sur cette adresse normalisée ou sur un identifiant de parcelle.

Stocker les observations et détecter les changements

Ajoutez une nouvelle ligne à chaque exécution au lieu d'écraser l'ancienne. Conservez collected_at, l'URL source et la valeur brute à côté de la valeur analysée. Comparer les lignes du jour avec celles de la semaine précédente fait apparaître les baisses de prix, les changements de statut et les nouvelles annonces. Avec pandas, il suffit de fusionner deux exécutions sur l'identifiant d'annonce. Les lignes présentes uniquement dans la nouvelle exécution sont de nouvelles annonces, celles présentes uniquement dans l'ancienne ont été retirées du marché, et celles présentes dans les deux avec un prix différent signalent un changement de prix.

Comment scraper des données immobilières avec Python ?

Installez requests, BeautifulSoup et pandas. Récupérez une page d'annonces que vous avez le droit de collecter, lisez d'abord son JSON-LD, puis utilisez les sélecteurs HTML pour les champs manquants. Convertissez les prix et les surfaces en nombres, supprimez les annonces en double et exportez en CSV. Utilisez une API de scraping lorsque les pages nécessitent l'exécution de JavaScript ou des résultats propres à une localisation.

Le tutoriel utilise un petit site d'exemple avec des annonces fictives, pour que vous puissiez exécuter chaque étape sans solliciter les serveurs de qui que ce soit. Le même code fonctionne sur le site de votre propre agence ou sur les pages d'un partenaire, une fois les sélecteurs adaptés.

Configurer le projet

Il vous faut Python 3.12 ou une version plus récente. Créez un dossier et un environnement virtuel, puis installez les quatre paquets :

mkdir property-scraper && cd property-scraper
python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
pip install requests beautifulsoup4 lxml pandas

Partir d'une page d'annonces d'exemple

Enregistrez la page d'exemple suivante sous le nom sample_listings.html. Elle contient quatre annonces fictives. Deux d'entre elles figurent aussi dans un bloc JSON-LD, comme c'est le cas sur beaucoup de vrais sites qui exposent des données structurées. L'une est une location, une autre un studio. Le parseur doit donc gérer les deux cas.

<!DOCTYPE html>
<html lang="en">
<head>
  <meta charset="utf-8">
  <title>Homes for sale and rent in Springfield (sample page)</title>
  <script type="application/ld+json">
  {
    "@context": "https://schema.org",
    "@type": "ItemList",
    "itemListElement": [
      {
        "@type": "RealEstateListing",
        "identifier": "SPR-1001",
        "url": "https://example.com/listings/SPR-1001",
        "datePosted": "2026-10-12",
        "offers": {"@type": "Offer", "price": 425000, "priceCurrency": "USD"},
        "about": {
          "@type": "SingleFamilyResidence",
          "address": {"@type": "PostalAddress", "streetAddress": "123 Example St",
                      "addressLocality": "Springfield", "addressRegion": "ST", "postalCode": "00001"},
          "numberOfBedrooms": 3,
          "numberOfBathroomsTotal": 2,
          "floorSize": {"@type": "QuantitativeValue", "value": 1850, "unitCode": "FTK"}
        }
      },
      {
        "@type": "RealEstateListing",
        "identifier": "SPR-1002",
        "url": "https://example.com/listings/SPR-1002",
        "datePosted": "2026-10-20",
        "offers": {"@type": "Offer", "price": 1250000, "priceCurrency": "USD"},
        "about": {
          "@type": "SingleFamilyResidence",
          "address": {"@type": "PostalAddress", "streetAddress": "45 Sample Ave",
                      "addressLocality": "Springfield", "addressRegion": "ST", "postalCode": "00002"},
          "numberOfBedrooms": 5,
          "numberOfBathroomsTotal": 4.5,
          "floorSize": {"@type": "QuantitativeValue", "value": 4100, "unitCode": "FTK"}
        }
      }
    ]
  }
  </script>
</head>
<body>
  <ul class="results">
    <li class="listing-card" data-listing-id="SPR-1001" data-status="for_sale">
      <a class="listing-link" href="https://example.com/listings/SPR-1001">123 Example St, Springfield, ST 00001</a>
      <span class="price">$425,000</span>
      <span class="beds">3 bd</span> <span class="baths">2 ba</span> <span class="area">1,850 sqft</span>
    </li>
    <li class="listing-card" data-listing-id="SPR-1002" data-status="for_sale">
      <a class="listing-link" href="https://example.com/listings/SPR-1002">45 Sample Ave, Springfield, ST 00002</a>
      <span class="price">$1,250,000</span>
      <span class="beds">5 bd</span> <span class="baths">4.5 ba</span> <span class="area">4,100 sqft</span>
    </li>
    <li class="listing-card" data-listing-id="SPR-1003" data-status="for_rent">
      <a class="listing-link" href="https://example.com/listings/SPR-1003">7 Placeholder Ln, Unit 2B, Springfield, ST 00001</a>
      <span class="price">$2,400/mo</span>
      <span class="beds">2 bd</span> <span class="baths">1 ba</span> <span class="area">950 sqft</span>
    </li>
    <li class="listing-card" data-listing-id="SPR-1004" data-status="for_sale">
      <a class="listing-link" href="https://example.com/listings/SPR-1004">88 Demo Rd, Springfield, ST 00003</a>
      <span class="price">$389,900</span>
      <span class="beds">Studio</span> <span class="baths">1 ba</span> <span class="area">610 sqft</span>
    </li>
  </ul>
  <a class="next" href="sample_listings_2.html">Next</a>
</body>
</html>

Le lien « Next » pointe vers une deuxième page d'exemple. Enregistrez-la sous le nom sample_listings_2.html. Elle reprend une annonce de la page 1, ce qui arrive sur les vrais sites lorsque de nouvelles annonces repoussent les plus anciennes vers le bas :

<!DOCTYPE html>
<html lang="en">
<head><meta charset="utf-8"><title>Homes in Springfield, page 2 (sample page)</title></head>
<body>
  <ul class="results">
    <li class="listing-card" data-listing-id="SPR-1004" data-status="for_sale">
      <a class="listing-link" href="https://example.com/listings/SPR-1004">88 Demo Rd, Springfield, ST 00003</a>
      <span class="price">$389,900</span>
      <span class="beds">Studio</span> <span class="baths">1 ba</span> <span class="area">610 sqft</span>
    </li>
    <li class="listing-card" data-listing-id="SPR-1005" data-status="for_sale">
      <a class="listing-link" href="https://example.com/listings/SPR-1005">19 Fixture Ct, Springfield, ST 00002</a>
      <span class="price">$615,000</span>
      <span class="beds">4 bd</span> <span class="baths">2.5 ba</span> <span class="area">2,300 sqft</span>
    </li>
  </ul>
</body>
</html>

Servez le dossier en local, pour que votre scraper récupère les pages en HTTP comme il le ferait sur un vrai site :

python -m http.server 8000

Laissez ce serveur tourner et ouvrez un second terminal pour la suite. Placez le code de cette étape et des cinq suivantes, dans l'ordre, dans un seul fichier nommé scraper.py. Commencez par les imports et une fonction de récupération qui envoie un User-Agent honnête et s'arrête net en cas d'erreur HTTP :

import json
import re
import time
from datetime import datetime, timezone
from urllib.parse import urljoin

import requests
from bs4 import BeautifulSoup

HEADERS = {"User-Agent": "property-research/1.0 (you@example.com)"}


def fetch(url: str) -> str:
    response = requests.get(url, headers=HEADERS, timeout=30)
    response.raise_for_status()
    return response.text

Extraire d'abord le JSON-LD

Le JSON-LD se trouve dans des balises <script type="application/ld+json">. Une page peut contenir un seul objet, une liste d'objets ou une ItemList qui regroupe les annonces : la fonction utilitaire gère donc ces trois formes. Elle convertit ensuite chaque RealEstateListing en champs à plat :

def iter_jsonld(soup: BeautifulSoup):
    """Yield every JSON-LD object on the page, unwrapping lists and ItemLists."""
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except json.JSONDecodeError:
            continue
        for item in data if isinstance(data, list) else [data]:
            if item.get("@type") == "ItemList":
                for element in item.get("itemListElement", []):
                    yield element.get("item", element)
            else:
                yield item


def listings_from_jsonld(soup: BeautifulSoup) -> dict:
    found = {}
    for item in iter_jsonld(soup):
        if item.get("@type") != "RealEstateListing":
            continue
        home = item.get("about", {})
        addr = home.get("address", {})
        offer = item.get("offers", {})
        found[item["identifier"]] = {
            "listing_id": item["identifier"],
            "url": item.get("url"),
            "address": f"{addr.get('streetAddress')}, {addr.get('addressLocality')}, "
                       f"{addr.get('addressRegion')} {addr.get('postalCode')}",
            "price": offer.get("price"),
            "currency": offer.get("priceCurrency"),
            "beds": home.get("numberOfBedrooms"),
            "baths": home.get("numberOfBathroomsTotal"),
            "sqft": home.get("floorSize", {}).get("value"),
            "source": "json-ld",
        }
    return found

Les valeurs issues du JSON-LD sont déjà des nombres, ce qui vous épargne l'essentiel du nettoyage.

Se rabattre sur les sélecteurs HTML

Deux des quatre fiches de la page 1 n'ont pas de JSON-LD, et aucune n'indique le statut de l'annonce dans ses données structurées. Le parseur HTML lit chaque fiche à partir de ses attributs data-* et de ses noms de classe, et conserve le texte brut de chaque champ. Si les sélecteurs sont nouveaux pour vous, commencez par notre tutoriel BeautifulSoup.

def text_of(card, selector: str) -> str | None:
    node = card.select_one(selector)
    return node.get_text(strip=True) if node else None


def listings_from_html(soup: BeautifulSoup, base_url: str) -> dict:
    found = {}
    for card in soup.select("li.listing-card"):
        link = card.select_one("a.listing-link")
        listing_id = card["data-listing-id"]
        found[listing_id] = {
            "listing_id": listing_id,
            "status": card.get("data-status"),
            "url": urljoin(base_url, link["href"]),
            "address": link.get_text(strip=True),
            "price_raw": text_of(card, ".price"),
            "beds_raw": text_of(card, ".beds"),
            "baths_raw": text_of(card, ".baths"),
            "sqft_raw": text_of(card, ".area"),
        }
    return found

Sur un vrai site, privilégiez les attributs data-* et les noms de classe stables plutôt que de longs chemins CSS. Ils résistent mieux aux refontes.

Nettoyer et normaliser les champs

Transformez maintenant les chaînes brutes en nombres. parse_price supprime tout sauf les chiffres : « $1,250,000 » devient 1250000 et « $2,400/mo » devient 2400. rent_period conserve l'information « /mo » dans une colonne dédiée. normalize fusionne les deux sources, donne la priorité au JSON-LD lorsqu'il contient une valeur, indique pour chaque prix s'il s'agit d'un prix demandé ou d'un loyer demandé, et horodate la ligne en UTC :

def parse_price(text: str | None) -> int | None:
    """'$1,250,000' -> 1250000 and '$2,400/mo' -> 2400."""
    if not text:
        return None
    digits = re.sub(r"[^\d]", "", text.split("/")[0])
    return int(digits) if digits else None


def rent_period(text: str | None) -> str | None:
    if text and re.search(r"/\s*(mo|month)", text, re.I):
        return "month"
    if text and re.search(r"/\s*(wk|week)", text, re.I):
        return "week"
    return None


def parse_number(text: str | None) -> float | None:
    if not text:
        return None
    if "studio" in text.lower():
        return 0.0
    match = re.search(r"\d[\d,]*(\.\d+)?", text)
    return float(match.group().replace(",", "")) if match else None


def normalize(html_row: dict, jsonld_row: dict | None) -> dict:
    raw_price = html_row.get("price_raw")
    row = {
        "listing_id": html_row["listing_id"],
        "status": html_row.get("status"),
        "price": parse_price(raw_price),
        "currency": "USD" if raw_price and "$" in raw_price else None,
        "rent_period": rent_period(raw_price),
        "beds": parse_number(html_row.get("beds_raw")),
        "baths": parse_number(html_row.get("baths_raw")),
        "sqft": parse_number(html_row.get("sqft_raw")),
        "address": html_row.get("address"),
        "url": html_row.get("url"),
        "source": "html",
    }
    # Structured data wins wherever it has a value.
    for key, value in (jsonld_row or {}).items():
        if value is not None:
            row[key] = value
    row["price_type"] = "asking_rent" if row["status"] == "for_rent" else "asking_price"
    row["sqft"] = int(row["sqft"]) if row["sqft"] is not None else None
    row["collected_at"] = datetime.now(timezone.utc).isoformat(timespec="seconds")
    row["price_raw"] = raw_price
    return row


def parse_page(html: str, base_url: str) -> list[dict]:
    soup = BeautifulSoup(html, "lxml")
    structured = listings_from_jsonld(soup)
    cards = listings_from_html(soup, base_url)
    return [normalize(card, structured.get(lid)) for lid, card in cards.items()]

La colonne source indique d'où proviennent les valeurs de chaque ligne. Si le JSON-LD disparaît d'une page après une refonte, cette colonne vous prévient avant que vos chiffres ne deviennent faux.

Gérer la pagination et les doublons

Le crawler suit le lien « Next » jusqu'à ce qu'il n'y en ait plus, attend entre deux requêtes et ignore les identifiants d'annonce déjà vus. Il s'arrête aussi sur une page vide et après max_pages, pour qu'un lien cassé ne puisse pas l'enfermer dans une boucle :

def crawl(start_url: str, max_pages: int = 20, delay: float = 2.0) -> list[dict]:
    rows, seen, url = [], set(), start_url
    for _ in range(max_pages):
        html = fetch(url)
        page_rows = parse_page(html, url)
        new_rows = [r for r in page_rows if r["listing_id"] not in seen]
        seen.update(r["listing_id"] for r in new_rows)
        rows.extend(new_rows)
        print(f"{url}: {len(page_rows)} cards, {len(new_rows)} new")

        next_link = BeautifulSoup(html, "lxml").select_one("a.next")
        if not page_rows or not next_link:
            break
        url = urljoin(url, next_link["href"])
        time.sleep(delay)
    return rows

Sur un vrai site, un délai de deux secondes ou plus est une valeur par défaut raisonnable. Augmentez-le si le serveur ralentit ou renvoie des erreurs.

Exporter en CSV

Le dernier bloc lance le crawl et écrit listings.csv avec pandas :

if __name__ == "__main__":
    import pandas as pd

    rows = crawl("http://localhost:8000/sample_listings.html", delay=1.0)
    df = pd.DataFrame(rows)
    df.to_csv("listings.csv", index=False)
    print(df[["listing_id", "price_type", "price", "rent_period",
              "beds", "baths", "sqft", "source"]].to_string(index=False, na_rep=""))

Lancez python scraper.py. Résultat obtenu sur les pages d'exemple :

http://localhost:8000/sample_listings.html: 4 cards, 4 new
http://localhost:8000/sample_listings_2.html: 2 cards, 1 new
listing_id   price_type   price rent_period  beds  baths  sqft  source
  SPR-1001 asking_price  425000               3.0    2.0  1850 json-ld
  SPR-1002 asking_price 1250000               5.0    4.5  4100 json-ld
  SPR-1003  asking_rent    2400       month   2.0    1.0   950    html
  SPR-1004 asking_price  389900               0.0    1.0   610    html
  SPR-1005 asking_price  615000               4.0    2.5  2300    html

Les six fiches donnent cinq annonces uniques : le doublon SPR-1004 de la page 2 a été ignoré. Les deux premières lignes tirent leurs valeurs du JSON-LD, les autres du HTML. La location conserve sa période mensuelle, et le studio compte zéro chambre au lieu d'une valeur manquante. Le CSV contient aussi status, currency, address, url, collected_at et le texte brut du prix pour chaque ligne.

Récupérer les pages riches en JavaScript avec une API de scraping

Le site d'exemple est statique. Beaucoup de vraies pages d'annonce chargent leurs données avec JavaScript, et certaines affichent des résultats différents selon la localisation du visiteur. Dans ces cas, une API de scraping peut récupérer la page via un vrai navigateur, depuis le pays de votre choix, et renvoyer le HTML final. Le rendu et la localisation sont d'ailleurs les deux réglages qui déterminent le plus souvent si vous voyez la même page qu'un visiteur. Pour en savoir plus, lisez comment éviter les blocages et les limites de débit.

La requête ci-dessous utilise le point de terminaison v2 de WebScrapingAPI. Lisez la clé depuis une variable d'environnement et ne l'affichez jamais. TARGET_URL est un exemple à remplacer par une page que vous avez le droit de collecter, comme le site de votre propre agence ou celui d'un partenaire :

import os

import requests

from scraper import parse_page

TARGET_URL = "https://www.your-brokerage.example/listings?city=springfield"

response = requests.get(
    "https://api.webscrapingapi.com/v2",
    params={
        "api_key": os.environ["WSA_API_KEY"],
        "url": TARGET_URL,
        "render_js": 1,
        "country": "us",
    },
    timeout=90,
)
response.raise_for_status()
rows = parse_page(response.text, TARGET_URL)
print(f"{len(rows)} listings parsed")

Définissez d'abord la clé dans votre shell avec export WSA_API_KEY=.... Le corps de la réponse est le HTML rendu : la fonction parse_page de votre scraper le traite donc sans modification. Seuls les sélecteurs doivent correspondre au site cible.

Comment obtenir les prix de l'immobilier sans scraping ?

Téléchargez-les. Realtor.com, Zillow et Redfin publient gratuitement des fichiers sur le marché immobilier avec les prix affichés médians, le stock, la durée de mise en vente et les baisses de prix par zone métropolitaine, comté ou code postal, mis à jour chaque mois. Le House Price Index de la FHFA suit les prix des reventes successives. Ces sources répondent aux questions de marché sans aucun scraping.

Les principales sources :

  • Bibliothèque de données résidentielles Realtor.com. La bibliothèque de données résidentielles Realtor.com propose des fichiers CSV mensuels par pays, État, zone métropolitaine, comté et code postal, en version actuelle et historique.
  • Zillow Research. Les données Zillow Research comprennent des indices de valeur immobilière et de loyers, des fichiers de stock et de prix de vente, publiés pour vos propres analyses.
  • Redfin Data Center. Le Redfin Data Center publie des fichiers de suivi du marché avec les prix de vente, le stock et les baisses de prix.
  • FHFA. Le House Price Index de la FHFA mesure l'évolution des prix à partir des ventes répétées des mêmes logements.

Cet exemple charge directement le fichier métropolitain de Realtor.com dans pandas et liste les 10 zones métropolitaines au prix affiché médian le plus élevé :

import pandas as pd

CSV_URL = ("https://econdata.s3-us-west-2.amazonaws.com/"
           "Reports/Core/RDC_Inventory_Core_Metrics_Metro.csv")

metros = pd.read_csv(CSV_URL)
month = metros["month_date_yyyymm"].iloc[0]
top = (metros.dropna(subset=["median_listing_price"])
             .nlargest(10, "median_listing_price")
             [["cbsa_title", "median_listing_price",
               "active_listing_count", "median_days_on_market"]])
print(f"Data month: {month}")
print(top.to_string(index=False))

Résultat :

Data month: 202609
                        cbsa_title  median_listing_price  active_listing_count  median_days_on_market
                     Nantucket, MA             5873250.0                   145                   84.0
                Vineyard Haven, MA             2495000.0                   260                   99.0
                    Jackson, WY-ID             2150000.0                   418                  108.0
     Santa Maria-Santa Barbara, CA             1720750.0                   718                   58.0
                         Heber, UT             1594500.0                  1595                   90.0
                         Rifle, CO             1510750.0                   875                   93.0
                         Kapaa, HI             1507750.0                   385                  116.0
San Jose-Sunnyvale-Santa Clara, CA             1388472.0                  2112                   35.0
                       Salinas, CA             1289500.0                   551                   66.0
                          Napa, CA             1272500.0                   572                   81.0

Source : Realtor.com Residential Data Library, indicateurs clés par zone métropolitaine, septembre 2026 (month_date_yyyymm 202609).

Le fichier contient aussi price_reduced_share, new_listing_count, pending_listing_count et median_listing_price_per_square_foot, ainsi que leurs variations d'un mois sur l'autre et d'une année sur l'autre. Affichez le mois à chaque exécution du script, car le fichier est mis à jour mensuellement et votre rapport doit préciser le mois qu'il décrit. Citez la source sous chaque graphique ou tableau que vous publiez.

Pour les tendances dans le temps, la même bibliothèque propose une version _History de chaque fichier, avec une ligne par zone métropolitaine et par mois. Changez le nom du fichier dans CSV_URL, puis filtrez sur cbsa_title et tracez median_listing_price en fonction de month_date_yyyymm. Les fichiers par code postal utilisent les mêmes colonnes d'indicateurs avec leurs propres colonnes géographiques : le code change donc à peine.

Comment vérifier que les données immobilières scrapées sont correctes ?

Vérifiez chaque exécution à l'aide de quelques règles. Chaque ligne a une adresse, un prix et une URL source. Les prix se situent dans une fourchette plausible pour le marché. Le nombre de lignes est proche du total annoncé par le site. Aucun identifiant d'annonce n'apparaît deux fois. Les valeurs de vente, de loyer et d'estimation ne partagent jamais la même colonne de prix.

Un scraper qui reçoit un HTTP 200 peut tout de même renvoyer n'importe quoi. Ces contrôles repèrent les défaillances les plus courantes :

Contrôle

Règle

Action en cas d'échec

Champs obligatoires

Chaque ligne a une adresse, un prix et une URL source

Suspendre l'exécution et inspecter les lignes

Cohérence des prix

Prix supérieur à zéro, dans la fourchette normale du marché, devise renseignée

Signaler les lignes ; chercher un chiffre manquant ou un loyer dans la colonne des ventes

Période du loyer

Chaque location a une période (mois ou semaine)

Corriger le parseur avant le chargement

Nombre de lignes

Proche du total affiché par le site pour la recherche

Chercher une limite de pagination ou une page manquée

Identifiants en double

Aucun identifiant d'annonce n'apparaît deux fois dans une exécution

Corriger le dédoublonnage ; vérifier si les identifiants changent d'une page à l'autre

Dérive des champs

La part de valeurs vides par champ reste proche de celle de l'exécution précédente

Comparer avec l'exécution précédente ; un saut signifie qu'un sélecteur a cassé

Pages obsolètes

Les annonces vendues ou retirées sont marquées comme telles, pas comptées comme actives

Mettre à jour le statut et conserver l'historique

Parseur cassé

Zéro ligne ou chute soudaine du nombre de lignes

Déclencher une alerte et garder les données de la veille en ligne

Plusieurs de ces contrôles tiennent dans un court script pandas à lancer après chaque crawl :

import pandas as pd

df = pd.read_csv("listings.csv")
problems = []

missing = df[df[["address", "price", "url"]].isna().any(axis=1)]
if len(missing):
    problems.append(f"{len(missing)} rows missing address, price, or URL")

sale = df[df["price_type"] == "asking_price"]
if not sale["price"].between(10_000, 50_000_000).all():
    problems.append("sale price outside the plausible range")

rent = df[df["price_type"] == "asking_rent"]
if rent["rent_period"].isna().any():
    problems.append("rental without a rent period")

if df["listing_id"].duplicated().any():
    problems.append("duplicate listing IDs")

null_share = df.isna().mean().round(2)
print(null_share[null_share > 0].to_dict())
print("OK" if not problems else problems)

Résultat sur les données d'exemple :

{'rent_period': 0.8}
OK

Seule la colonne rent_period contient des valeurs vides, ce qui est normal : quatre des cinq annonces sont des ventes. Enregistrez la part de valeurs vides de chaque exécution pour que le contrôle de dérive des champs ait une base de comparaison.

Quels outils de scraping immobilier utiliser ?

Choisissez selon la part du travail que vous voulez assumer vous-même. Les bibliothèques Python comme requests et BeautifulSoup conviennent aux pages statiques. Playwright gère les sites riches en JavaScript. Une API de scraping ajoute le rendu, les proxys et le géociblage sans infrastructure. Une API de données ou un jeu de données fournit des annonces structurées sans parseur. Les flux MLS restent la source de référence pour les données d'annonce sous licence.

Catégorie

Exemples

Ce que vous maintenez

Idéal pour

Limites

Bibliothèques HTTP + parseurs

requests, httpx, BeautifulSoup, lxml

Tout : récupération, analyse, planification, proxys

Pages statiques, petits travaux autorisés

Pas de JavaScript ; les blocages sont à votre charge

Automatisation de navigateur

Playwright, Selenium

Navigateurs, analyse, serveurs

Pages riches en JavaScript

Plus lent et plus lourd par page

API de scraping

Scraper API de WebScrapingAPI et services similaires

Analyse et planification

Pages rendues de sites autorisés, quel que soit le volume

Le parseur reste à écrire et à corriger

API et jeux de données

Data API de WebScrapingAPI (Zillow, Redfin, Zoopla) et autres fournisseurs

Rien au-delà de votre pipeline

Fiches d'annonce structurées sans équipe dédiée aux parseurs

Couverture et champs définis par le fournisseur ; sur devis

Outils no-code

Scrapers visuels pointer-cliquer et extensions de navigateur

Des configurations pointer-cliquer

Extractions ponctuelles par des non-développeurs

Difficiles à versionner, tester et faire évoluer

Flux MLS et agrégateurs

RESO Web API via un MLS ou un fournisseur agréé

Intégration et conformité d'affichage

Données de référence sur les annonces et les ventes

Licences, contrats, règles d'affichage

Si vous avez besoin d'annonces Zillow en volume, un flux de données Zillow maintenu vous fournit des fiches structurées par un prestataire qui gère la collecte, au lieu d'un scraper qu'il vous faudrait construire et défendre vous-même. Cela ne change rien à ce que disent les conditions de Zillow sur votre propre scraping. Si vous hésitez entre votre propre code et un service, lisez comment choisir entre développer et acheter un scraper.

Où trouver des guides pour des sites immobiliers précis ?

Nous proposons des guides pas à pas pour plusieurs sites immobiliers, chacun avec ses propres remarques juridiques :

FAQ

Est-il légal de scraper des sites immobiliers ?

Cela dépend du site, des données et de votre pays. De nombreux grands portails interdisent le scraping dans leurs conditions, et les photos d'annonces sont souvent protégées par le droit d'auteur. Les données publiques non personnelles issues de sites qui autorisent l'accès automatisé présentent bien moins de risques. Lorsque les conditions l'interdisent, utilisez l'open data ou un flux sous licence, et consultez un avocat.

Puis-je scraper Zillow ?

Les conditions d'utilisation de Zillow interdisent les requêtes automatisées, y compris le scraping d'écran, les crawlers et le contournement des captchas. Pour les tendances du marché, téléchargez les données Zillow Research, que Zillow publie pour vos propres analyses. Pour des fiches au niveau de l'annonce, passez par un fournisseur de données sous licence ou un flux MLS. Ne bâtissez pas une activité sur des données collectées en violation des conditions.

Quel est le meilleur scraper immobilier ?

Il n'existe pas d'outil unique idéal. Pour les pages statiques que vous avez le droit de collecter, Python avec requests et BeautifulSoup suffit. Pour les pages riches en JavaScript, utilisez Playwright ou une API de scraping. Si vous préférez ne pas maintenir de parseurs, une API de données immobilières ou un jeu de données sous licence vous fournit directement des annonces structurées.

Existe-t-il une API de données immobilières gratuite ?

Rares sont celles qui sont gratuites au niveau de l'annonce. Les options gratuites portent surtout sur le marché : Realtor.com, Zillow et Redfin publient des fichiers immobiliers téléchargeables, et la FHFA publie son House Price Index. Les API au niveau de l'annonce et les flux MLS exigent généralement un abonnement payant, une licence ou une relation avec une agence. Vérifiez les conditions de chaque source avant de réutiliser les données.

À quelle fréquence faut-il scraper les annonces immobilières ?

Adaptez le calendrier à la vitesse à laquelle les données changent. Des exécutions quotidiennes captent les nouvelles annonces, les baisses de prix et les changements de statut sur les marchés actifs. Des exécutions hebdomadaires conviennent aux marchés plus lents et à la recherche. Les fichiers open data mensuels suffisent pour l'analyse des tendances. Ne récupérez à nouveau que les annonces qui ont changé, pour alléger la charge sur le site source.

Faut-il des proxys pour scraper des sites immobiliers ?

Pas pour de petits travaux respectueux sur des sites qui autorisent la collecte. Les gros volumes nécessitent souvent des proxys, l'exécution de JavaScript et des résultats propres à une localisation, ce que regroupe une API de scraping. Les proxys ne changent rien aux conditions d'un site. Si un portail interdit le scraping, faire tourner des adresses IP pour contourner ses blocages augmente le risque juridique.

Comment collecter des photos de biens à grande échelle ?

Stockez les URL et les métadonnées des images, pas des copies, sauf si vous détenez les droits sur les photos. Les photos d'annonces appartiennent généralement au photographe, à l'agent ou au MLS, et non au portail. Pour une réutilisation sous licence, obtenez les images via un flux MLS ou IDX, ou auprès d'un fournisseur de données dont la licence couvre l'affichage, et conservez la mention de la source.

Quelle approche choisir ?

Partez de la question à laquelle vous devez répondre, pas du scraper :

  • Chiffres à l'échelle du marché, comme les prix médians, le stock et la durée de mise en vente : téléchargez l'open data.
  • Fiches au niveau de l'annonce en volume : prenez une licence de flux MLS ou utilisez une API de données.
  • Vos propres sites, ceux de vos partenaires et les sources publiques autorisées : utilisez une API de scraping ou le scraper Python de ce guide.

Quelle que soit l'option choisie, gardez les trois couches séparées, associez un type à chaque prix et lancez les contrôles qualité à chaque chargement.

Obtenez des données immobilières sans maintenir de scrapers

Besoin de fiches d'annonce, de prix et d'historiques pour vos marchés ? Indiquez-nous les sources et les champs, et nous définirons un flux adapté. Découvrir les données immobilières

Vous collectez sur vos propres sites ou sur des sites autorisés ? Démarrez avec Scraper API et 5 000 requêtes gratuites. Aucun crédit supplémentaire pour l'exécution de JavaScript ou le géociblage, et les requêtes échouées ne sont pas facturées. Voir les offres Scraper API

À propos de l'auteur

Robert Munceanu, Développeur full-stack @ WebScrapingAPI

Robert Munceanu

Développeur full-stack

Robert Munceanu est développeur Full Stack chez WebScrapingAPI ; il participe à l'ensemble du produit et contribue à la création d'outils et de fonctionnalités fiables qui soutiennent la plateforme.

Web scraping avec AWS Lambda : guide pour Python et Java 2026
Guides

Web scraping avec AWS Lambda : guide pour Python et Java 2026

TL;DR: En bref : le web scraping avec AWS Lambda fonctionne mieux lorsque chaque invocation est courte, bien délimitée et peut faire l'objet d'une nouvelle tentative de manière indépendante. Commencez par utiliser les requêtes HTTP directes, AWS SAM et S3, puis ajoutez SQS, des conteneurs, le rendu dans un navigateur, des proxys ou une couche de récupération gérée uniquement lorsque la charge de travail démontre qu'elle en a besoin.

Suciu Dan33 min read
Lire l'article
Comment utiliser GoSpider : exploration, nettoyage des URL et extraction de données
Guides

Comment utiliser GoSpider : exploration, nettoyage des URL et extraction de données

TL;DR: En bref : GoSpider est un robot d'exploration en ligne de commande destiné à découvrir des URL, et non un outil complet de collecte de données structurées. Ce guide d'utilisation de GoSpider présente comment effectuer une exploration limitée, gérer correctement les résultats, transférer les données de Colly vers un fichier CSV, ainsi qu'une procédure de diagnostic pour les réponses 403 ou les pages nécessitant un rendu JavaScript.

Suciu Dan24 min read
Lire l'article
Comment récupérer les données de Redfin : Guide Python des données immobilières
Guides

Comment récupérer les données de Redfin : Guide Python des données immobilières

TL;DR: Redfin expose des points d'extrémité d'API cachés qui renvoient du JSON structuré pour les listes de propriétés, ce qui permet d'ignorer complètement l'analyse HTML fragile. Ce guide vous accompagne dans la construction d'un scraper Python qui extrait les données de location et de vente, effectue des recherches par emplacement, surveille les nouvelles inscriptions via des sitemaps XML et exporte des résultats propres au format CSV ou JSON.

Suciu Dan15 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.