
Aller au contenu
Retour au blog

Web scraping avec Go : créer un scraper HTML fiable

Sorin-Gabriel MaricaDernière mise à jour le 16 min read
Web scraping avec Go : créer un scraper HTML fiable
En bref : pour le web scraping avec Go, utilisez net/http pour récupérer du HTML statique et goquery pour extraire des champs à l’aide de sélecteurs CSS. Commencez par une seule page, validez chaque enregistrement, puis exportez au format JSON. Ajoutez Colly pour planifier le crawling ou un navigateur pour le JavaScript uniquement lorsque votre cible l’exige. L’exemple complet ci-dessous inclut des délais d’attente, des limites de réponses, des vérifications d’état et des erreurs d’analyse explicites.

Un scraper qui affiche un titre une seule fois est facile à présenter. Un scraper qui vous signale quand une page change, qu’une requête échoue ou qu’un champ disparaît est bien plus utile dans une application Go. La différence réside dans les contraintes que vous mettez en place autour de la récupération, de l’analyse et de l’exportation des données.

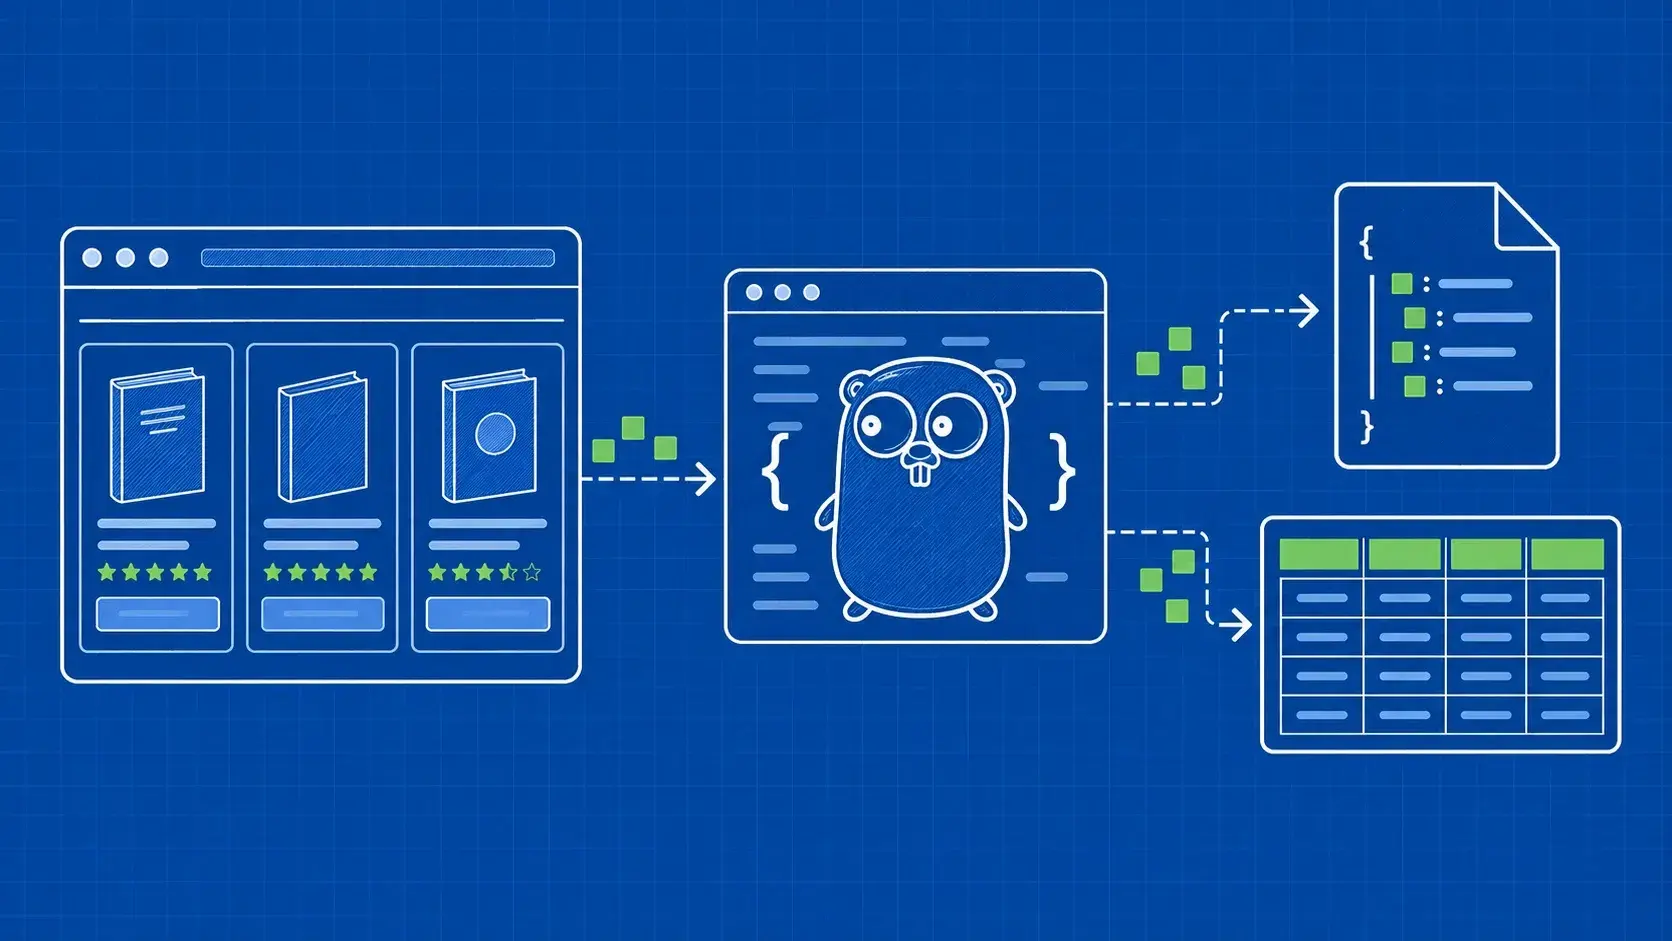
Ce guide vous guide pas à pas dans le scraping Web avec Go à l’aide d’une librairie d’entraînement. Vous allez créer un module, récupérer une page de catalogue, extraire des fiches de livres et écrire un fichier JSON. Le programme est complet, vous pouvez donc l’exécuter avant d’adapter les sélecteurs à une autre source. Vous devriez déjà être à l’aise avec les fonctions, les structs, les retours d’erreur et les opérations de base en ligne de commande sous Go.

La même approche s’applique à de nombreux projets de web scraping en Go : définissez d’abord les champs de sortie, inspectez le code HTML source et rendez les données manquantes détectables. Nous aborderons ensuite la pagination, Colly, le rendu dans le navigateur et les tests, afin que vous puissiez étendre la première version sans perdre le contrôle de son comportement.

Veillez à ce que le critère de réussite initial soit concret : une page demandée produit un ensemble valide d’enregistrements de livres, ou une erreur expliquant pourquoi cela n’a pas été possible. Cela vous donne un indicateur utile à mesurer avant d’ajouter d’autres pages ou d’autres workers.

Web scraping avec Go : choisir le bon outil

Commencez par séparer la récupération de la page, l’analyse du code HTML et l’exécution dans le navigateur. Il s’agit de tâches distinctes, même lorsqu’une bibliothèque regroupe plusieurs d’entre elles. Pour une page dont la réponse HTML contient déjà les enregistrements souhaités, un client HTTP et un analyseur suffisent.

Outil

Responsabilité

Un bon point de départ

net/http

Envoyer des requêtes et lire les réponses

Vous souhaitez un contrôle explicite sur les requêtes et les échecs

goquery

Sélectionner et lire des éléments HTML

Vous avez besoin de sélecteurs CSS sur le contenu téléchargé

Colly

Coordonner les requêtes et les rappels

Vous avez besoin de règles de navigation et d'une planification de l'exploration

chromedp

Contrôler un navigateur via une plateforme CDP

La page nécessite l'exécution ou l'interaction avec JavaScript

L'exemple ci-dessous combine net/http avec goquery. Cela permet de garder les fonctions de récupération et d’analyse suffisamment légères pour être testées séparément. Une modification apportée à un sélecteur ne nécessite pas d’appel réseau pour être vérifiée, et un échec HTTP ne passe pas inaperçu au sein du code d’extraction.

Utilisez Colly lorsque la charge de planification devient importante. Lancez un navigateur après avoir inspecté la réponse et confirmé que les champs sont absents du code HTML initial. Le fait de lancer un navigateur ne garantit pas automatiquement l’exactitude des valeurs extraites.

Pour le web scraping avec Go, ce choix est généralement plus important que la comparaison de la vitesse des langages. Choisissez l’outil le moins compliqué qui renvoie le contenu dont votre analyseur a réellement besoin, puis vérifiez les enregistrements obtenus.

Configurer un module Go reproductible

Créez un répertoire en dehors de tout module Go existant et initialisez un petit projet :

mkdir go-book-scraper
cd go-book-scraper

go mod init example.com/book-scraper
go get github.com/PuerkitoBio/goquery@v1.13.0

L’exemple a été testé avec Go 1.26.2 et goquery 1.13.0. Cette version verrouillée de goquery spécifie Go 1.25.0 comme version minimale dans les métadonnées du module. Utilisez une chaîne d’outils compatible plutôt que de reproduire les informations obsolètes d’un ancien tutoriel concernant la dernière version de Go.

Conservez go.mod et go.sum avec le projet. Le guide de gestion des dépendances de Go explique comment les exigences des modules et les sommes de contrôle permettent d'obtenir des builds reproductibles. Mettez à jour les dépendances de manière réfléchie et relancez les tests du parseur après chaque mise à jour.

Notre cible est Books to Scrape, une librairie fictive destinée à des exercices de scraping. Son catalogue contient des fiches produits comprenant un titre, un prix et un lien. L’exemple part du principe que le code HTML est en UTF-8 et traite une page du catalogue par appel. Cette portée délibérément restreinte facilite l’inspection du scraping Web avec Go avant d’ajouter une navigation ou des workers concurrents.

Créer un scraper HTML-vers-JSON testé

Enregistrez le programme complet suivant sous le nom main.go. Il extrait le titre complet de chaque livre, le prix affiché et l’URL absolue du produit. Il conserve les prix sous forme de chaînes de caractères, y compris leur symbole monétaire, au lieu d’introduire une conversion numérique dès la première étape d’extraction.

Les sélecteurs sont spécifiques à ce site d’entraînement. Chaque article.product_pod est un conteneur d’enregistrements, h3 a contient le lien vers le livre et l’attribut « titre complet », et .price_color contient le prix affiché. Lisez les champs au sein de chaque « card » afin d’éviter qu’un titre de livre ne soit accidentellement associé au prix d’un autre livre.

package main

import (
	"bytes"
	"context"
	"encoding/json"
	"fmt"
	"io"
	"log"
	"net/http"
	"net/url"
	"os"
	"strings"
	"time"

	"github.com/PuerkitoBio/goquery"
)

const maxBody = 2 << 20 // A 2 MiB limit chosen for this tutorial.

type Book struct {
	Title string `json:"title"`
	Price string `json:"price"`
	URL   string `json:"url"`
}

func parseBooks(r io.Reader, base *url.URL) ([]Book, error) {
	doc, err := goquery.NewDocumentFromReader(r)
	if err != nil {
		return nil, fmt.Errorf("parse HTML: %w", err)
	}
	cards := doc.Find("article.product_pod")
	if cards.Length() == 0 {
		return nil, fmt.Errorf("no book cards found")
	}
	books := make([]Book, 0, cards.Length())
	for _, node := range cards.Nodes {
		card := goquery.NewDocumentFromNode(node)
		link := card.Find("h3 a").First()
		title, _ := link.Attr("title")
		href, _ := link.Attr("href")
		price := strings.TrimSpace(card.Find(".price_color").Text())
		title = strings.TrimSpace(title)
		href = strings.TrimSpace(href)
		if title == "" || href == "" || price == "" {
			return nil, fmt.Errorf("book card has a missing required field")
		}
		target, err := base.Parse(href)
		if err != nil || (target.Scheme != "http" && target.Scheme != "https") {
			return nil, fmt.Errorf("book card has an invalid link")
		}
		books = append(books, Book{Title: title, Price: price, URL: target.String()})
	}
	return books, nil
}

func fetchBooks(ctx context.Context, client *http.Client, target string) ([]Book, error) {
	req, err := http.NewRequestWithContext(ctx, http.MethodGet, target, nil)
	if err != nil {
		return nil, err
	}
	req.Header.Set("User-Agent", "GoBookTutorial/1.0")
	resp, err := client.Do(req)
	if err != nil {
		return nil, fmt.Errorf("fetch page: %w", err)
	}
	defer resp.Body.Close()
	if resp.StatusCode != http.StatusOK {
		return nil, fmt.Errorf("unexpected HTTP status: %s", resp.Status)
	}
	body, err := io.ReadAll(io.LimitReader(resp.Body, maxBody+1))
	if err != nil {
		return nil, fmt.Errorf("read body: %w", err)
	}
	if len(body) > maxBody {
		return nil, fmt.Errorf("response exceeds 2 MiB")
	}
	return parseBooks(bytes.NewReader(body), resp.Request.URL)
}

func run(w io.Writer, target string) error {
	client := &http.Client{Timeout: 15 * time.Second}
	defer client.CloseIdleConnections()
	books, err := fetchBooks(context.Background(), client, target)
	if err != nil {
		return err
	}
	encoder := json.NewEncoder(w)
	encoder.SetIndent("", "  ")
	return encoder.Encode(books)
}

func main() {
	target := "https://books.toscrape.com/"
	if len(os.Args) > 1 {
		target = os.Args[1]
	}
	if err := run(os.Stdout, target); err != nil {
		log.Fatal(err)
	}
}

Exécutez le programme et n’enregistrez sa sortie JSON qu’après une extraction réussie :

go run . > books.tmp.json && mv books.tmp.json books.json

Sur la première page vérifiée, le premier enregistrement était « A Light in the Attic », avec un prix affiché de « 51,77 £ » et une URL absolue du produit. Vérifiez ces trois champs dans votre sortie avant d’adapter l’exemple. Un fichier JSON lisible ne prouve pas à lui seul que les sélecteurs ont capturé les valeurs souhaitées.

Le fichier de sortie temporaire évite de remplacer votre dernier jeu de données réussi par un fichier vide si la requête suivante échoue. La sortie standard contient le document JSON ; les erreurs sont redirigées vers la sortie d’erreur standard et génèrent un code de sortie différent de zéro.

Le client HTTP dispose d’un délai d’expiration de 15 secondes. La fonction `fetch` limite également la réponse à 2 Mio, une contrainte choisie pour les besoins de ce tutoriel plutôt qu’une recommandation universelle concernant la taille des pages. Elle lit un octet supplémentaire afin qu’un document trop volumineux génère une erreur explicite au lieu d’être tronqué en silence sous forme de code HTML.

Le contexte de la requête est transmis au client. Dans un programme plus volumineux, remplacez context.Background() à la limite d’appel par le contexte de la tâche, afin que l’annulation puisse interrompre le travail en cours. La documentation Go sur HTTP fait également une distinction importante : une réponse telle que 404 peut arriver sans erreur de transport. C’est pourquoi la vérification du statut est distincte de err.

L’analyse renvoie une erreur lorsque la structure de carte attendue ou un champ obligatoire disparaît. Cet exemple rejette la page plutôt que de produire un résultat partiellement rempli. Il s’agit d’un choix de politique que vous pouvez modifier ultérieurement, mais faites-le explicitement : enregistrez les lignes rejetées si votre pipeline de production accepte une sortie partielle.

Enfin, les liens vers les produits sont résolus par rapport à l’URL de réponse finale. Cela a son importance lorsqu’une page redirige ou utilise des liens relatifs. Le code valide les schémas de liens avant de les exporter ; il ne suit pas ces URL de produits.

Pour le web scraping avec Go, ces limites vous fournissent une base de référence utile : les erreurs de requête, les limites de taille de page, les échecs de sélecteur et les erreurs de sortie restent visibles. Les enregistrements obtenus doivent encore faire l’objet de vérifications spécifiques à l’application avant que vous ne les considériez comme un ensemble de données finalisé.

Ajouter une pagination sans exploration illimitée

Le programme d’une seule page n’explore pas l’intégralité de la librairie. Pour inspecter la page suivante du catalogue, transmettez explicitement son URL :

go run . https://books.toscrape.com/catalogue/page-2.html

Les deux pages du catalogue ont renvoyé 20 enregistrements lors des tests effectués pour ce tutoriel. Il s’agit d’un résultat observé sur le site d’entraînement, et non d’une garantie concernant les futures mises en page ou d’autres sites web.

Pour une pagination automatique, séparez la découverte des enregistrements de leur extraction. Analysez le lien vers la page suivante à partir du même document téléchargé, résolvez-le par rapport à l’URL de réponse, puis déterminez s’il doit faire partie du lot de requêtes suivant. Évitez de récupérer une page deux fois simplement parce que l’extraction et la navigation sont des fonctions distinctes.

Une boucle de pagination délimitée doit procéder comme suit :

  1. Commencer par l’URL du catalogue approuvée et une limite de pages.
  2. Récupérer et valider la page actuelle.
  3. Extraire les enregistrements et inspecter le lien vers la page suivante.
  4. Résoudre ce lien et vérifier qu’il respecte le schéma, l’hôte et le chemin d’accès attendus.
  5. S'arrêter s'il n'y a pas de lien vers la page suivante, si l'adresse a déjà été visitée ou si la limite de pages est atteinte.
  6. Attendez en respectant les limites de fonctionnement de la source avant de demander la page suivante.

Vérifier les destinations des redirections ainsi que les liens découverts si l’exploration doit rester sur une seule origine. Une vérification de la même origine sur l’adresse initiale seule ne limite pas la destination vers laquelle une redirection HTTP envoie le client.

Suivez les URL des pages visitées séparément des identifiants d’enregistrements. Une page de catalogue en double et un livre en double constituent deux problèmes de doublons distincts. Veillez à ce que ces deux vérifications restent compréhensibles, plutôt que de supprimer tous les paramètres de requête et de supposer que les adresses deviennent équivalentes.

Notre guide d’exploration GoSpider présente un workflow de découverte dédié. Lorsque le web scraping avec Go dépasse le cadre des adresses connues, cette séparation vous aide à déterminer si les enregistrements manquants proviennent d’une découverte incomplète ou d’une extraction incorrecte.

Utilisez Colly lorsque vous avez besoin de planifier des explorations

Colly s’avère utile lorsque vous gérez vous-même un grand nombre de callbacks de requêtes, de règles de navigation et de limites par domaine. Son collecteur coordonne la récupération et les gestionnaires tels que OnHTML, OnRequest, et OnError.

Pour le module v2, utilisez le chemin d’accès au module versionné :

go get github.com/gocolly/colly/v2@v2.3.0

Import github.com/gocolly/colly/v2 dans votre source Go. Le /v2 suffixe est important ; un exemple plus ancien important le chemin non versionné ne sélectionne pas cette version du module. Si vous ajoutez Colly au projet de démonstration ultérieurement, veillez à maintenir la cohérence des règles d’enregistrement de l’analyseur plutôt que de modifier le schéma de sortie en même temps.

Configurez AllowedDomains pour restreindre les destinations et utilisez un LimitRule pour le domaine concerné. Vérifiez l’erreur renvoyée par Limit. Définissez un délai d’expiration pour les requêtes et enregistrez OnError afin que les échecs de requête ne soient pas masqués par les callbacks.

Si vous activez Async, appelez Wait avant de considérer la tâche comme terminée. Protégez les tranches partagées et les rédacteurs de sortie, ou transmettez les enregistrements à un rédacteur via un canal. Une fonction de rappel concurrente qui ajoute des éléments à une tranche partagée reste du code concurrent et nécessite une stratégie de synchronisation.

La documentation de référence du package de Colly décrit ces contrôles. Notez que MaxDepth les limites concernent la profondeur des liens ; il ne s’agit pas d’un budget de pages total. Une page peu profonde peut contenir des liens vers de nombreuses destinations.

Pour le web scraping avec Go, un framework peut réduire le code de planification, mais il ne choisit pas les sélecteurs appropriés, ne valide pas les champs métier et ne détermine pas le degré d’exhaustivité requis pour un ensemble de données. Veillez à ce que ces responsabilités restent explicites.

Gérez JavaScript et les requêtes ayant échoué de manière réfléchie

Inspectez la réponse reçue avant de modifier votre chaîne d’extraction. Un champ manquant peut indiquer un changement de sélecteur, une page de réponse différente ou un contenu que JavaScript n’a pas encore affiché.

Symptôme

Première vérification

Code HTTP 200 sans fiches produit

Inspectez le corps de la réponse et vérifiez qu’il s’agit bien de la page attendue

Les données visibles dans le navigateur sont absentes du code HTML de la réponse

Vérifiez si elles sont fournies par JavaScript ou par une interaction

HTTP 429

Réduire la fréquence des requêtes et respecter Retry-After lorsqu’elle est présente

HTTP 403

Vérifier la réponse et les conditions d'accès

Cartes valides comportant des valeurs manquantes

Vérifiez à nouveau les sélecteurs de champs et la politique relative aux champs obligatoires

Un navigateur sans interface graphique peut exécuter du JavaScript et effectuer des interactions. En Go, chromedp contrôle un navigateur via le protocole Chrome DevTools. Son comportement par défaut lance Chrome en mode sans interface graphique ; l'exécution du navigateur nécessite toutefois un environnement de navigation approprié.

Ne remplacez pas systématiquement chaque requête HTTP par un navigateur. Déterminez d’abord quel contenu nécessite un rendu, puis attendez qu’un élément ou un état de page pertinent apparaisse, plutôt que de vous fier uniquement à un délai d’attente arbitraire.

De même, ne considérez pas chaque requête ayant échoué comme pouvant faire l’objet d’une nouvelle tentative. Définissez un budget de tentatives, distinguez les échecs temporaires des rejets persistants et respectez les instructions d’exploration de la source. Une chaîne d’agent utilisateur identifie ce client du tutoriel ; elle ne constitue pas une garantie d’accès.

Pour effectuer un web scraping fiable avec Go, il faut commencer par diagnostiquer à quelle étape l’échec s’est produit. Changer de sélecteurs ne permet pas de résoudre un délai d’expiration de transport, et augmenter la concurrence ne permet pas de réparer une page qui ne contient pas les données demandées.

Testez les enregistrements avant d’augmenter la concurrence

Les fonctions `fetch` et `parse` disposent d’entrées distinctes, ce qui vous permet de les tester sans dépendre d’un site web en constante évolution. Fournissez parseBooks un petit fichier HTML de test et une URL de base. Vérifiez l’attribut « title » complet, la chaîne de prix d’origine et l’adresse du produit résolue par rapport aux valeurs attendues explicites.

Modifiez ensuite le fichier de test. Supprimez un prix, renommez la classe de la fiche produit, omettez l’attribut « title » et fournissez un lien invalide. Chaque variation doit produire l’échec attendu par votre pipeline. Incluez une page qui renvoie un statut HTTP de réussite mais ne contient aucune fiche produit.

Pour le comportement réseau, utilisez le package `httptest` de Go afin de fournir des réponses contrôlées. Renvoyez les codes d'erreur 404 et 429, retardez une réponse jusqu'à l'expiration du délai d'attente du client et envoyez un corps de réponse dépassant la limite de taille configurée. Ces cas mettent en évidence des échecs qu'une seule requête en production réussie ne permet pas de détecter.

L’exemple ci-joint a été vérifié à l’aide de fixtures locales, go vetet le détecteur de courses à l’exécution. La suite de fixtures a couvert la sortie JSON réussie et les cas d’erreur ci-dessus, avec une couverture des instructions de 84,3 %. Deux requêtes directes vers le catalogue d’entraînement ont vérifié séparément les sélecteurs en production. Il s’agit d’une validation fonctionnelle, et non d’un test de débit.

Avant d’ajouter du parallélisme, assurez-vous que le chemin de sortie est compatible avec plusieurs workers. Réutilisez un client HTTP configuré, limitez le nombre de workers et attribuez un seul propriétaire pour l’écriture des enregistrements. Conservez les erreurs avec suffisamment de contexte de page pour pouvoir les analyser, tout en veillant à ce que les identifiants n’apparaissent pas dans les journaux.

Pour le web scraping avec Go, augmentez une limite à la fois et vérifiez le nombre d’enregistrements valides ainsi que le nombre de requêtes. Un nombre plus élevé de requêtes abouties n’est utile que si elles produisent les enregistrements dont votre application a besoin.

Points clés à retenir

  • Séparez la récupération de l’extraction. Un client HTTP obtient une réponse ; l’analyseur transforme son code HTML en enregistrements. En gardant ces fonctions indépendantes, vous pouvez reproduire l’échec d’un sélecteur à partir d’un fixture enregistré sans avoir à effectuer une nouvelle requête en direct.
  • Définissez le comportement en cas d’échec parallèlement à votre schéma de sortie. Décidez si un titre manquant, un prix vide ou une page inattendue doit entraîner le rejet d’une ligne ou de l’ensemble du résultat. L’exemple rejette la page, ce qui rend immédiatement visible tout changement de mise en page.
  • Délimitez la navigation avant de l’automatiser. Les destinations autorisées, les adresses visitées, le nombre de pages et la cadence de requêtes résolvent des problèmes différents. Traitez-les comme des contrôles explicites lorsque vous étendez la commande « une page » à une exploration.
  • Ajoutez la concurrence une fois que vous pouvez vous fier aux enregistrements. Une limite de travailleurs et un propriétaire unique de la sortie facilitent la compréhension de la version suivante. Surveillez les enregistrements acceptés et les pages rejetées parallèlement aux requêtes réseau.

FAQ

golang.org/x/net/html fait-il partie de la bibliothèque standard ?

Non. L’analyseur HTML se trouve dans le module distinct golang.org/x/net . Le html de Go et ce parseur ont des chemins d’importation et des responsabilités différents. goquery utilise le parseur externe sous-jacent à son API de sélection. Vérifiez les dépendances des modules lorsque vous suivez un tutoriel, plutôt que de supposer que tous les paquets maintenus au sein du projet Go sont fournis avec la chaîne d’outils.

goquery peut-il analyser du code HTML enregistré sur le disque ?

Oui. Ouvrez le fichier et transmettez son lecteur à `goquery.NewDocumentFromReader`, en vérifiant les deux erreurs. Fermez le fichier dans votre code d'appel ; l'analyseur ne se charge pas de le fermer. Lorsque vous avez besoin de liens absolus, conservez séparément l’URL d’origine de la page, car un nom de fichier local ne fournit pas le contexte de résolution de l’URL du site web.

Comment gérer les pages non-UTF-8 ?

Convertissez les données d’entrée avant de les analyser. Le package golang.org/x/net/html/charset fournit NewReader, qui renvoie un lecteur convertissant le HTML en UTF-8 à l’aide de la détection d’encodage et du type de contenu déclaré. Gérez les erreurs de configuration de la conversion et respectez les limites de taille de réponse dans votre couche de récupération. Un test contenant des caractères accentués permet de détecter les problèmes d’encodage qu’un test en ASCII seul ne permettrait pas de repérer.

Dois-je exporter les prix sous forme de nombres JSON ?

Choisissez la représentation adaptée à l’utilisateur. Si vous avez besoin d’effectuer des calculs, définissez explicitement la devise et l’échelle décimale ; un entier en unités mineures ou une représentation décimale peut être plus adaptée qu’une virgule flottante binaire. Conservez la valeur affichée d’origine dans un champ distinct lorsque la traçabilité est importante. Ne supprimez pas la ponctuation à l’aveuglette : les séparateurs de groupe et décimaux dépendent des conventions de mise en forme de la source.

Conclusion

Une première implémentation utile du web scraping avec Go repose sur un contrat restreint et observable. Elle interroge une page connue, valide la réponse, extrait un format d’enregistrement défini et signale les échecs. L’exemple de la librairie vous offre ce point de départ avec un programme exécutable et des sélecteurs validés par rapport au catalogue de référence.

Votre prochaine étape doit s’adapter au problème que vous rencontrez concrètement. Ajoutez une pagination lorsque les enregistrements s’étendent sur plusieurs pages connues du catalogue. Intégrez Colly lorsque la planification des requêtes et les callbacks prennent de l’ampleur. Utilisez le rendu du navigateur lorsque le contenu requis dépend de JavaScript ou d’une interaction. Dans chaque cas, veillez à ce que le schéma de sortie et les règles de validation restent suffisamment stables pour pouvoir comparer les résultats avant et après la modification.

Si la gestion de la récupération des pages devient une charge opérationnelle distincte, évaluez l’API Scraper de WebScrapingAPI pour cette partie du flux de travail. Votre application Go peut conserver la responsabilité de l’analyse syntaxique, de la validation des enregistrements et du stockage. Comparez le contenu renvoyé aux mêmes fixtures et aux mêmes attentes de champs que celles que vous utilisez avec les requêtes directes.

Commencez par exécuter l’exemple, examinez son JSON, puis modifiez délibérément un sélecteur pour observer l’échec. Comprendre ce chemin d’échec constitue une base pratique pour étendre le scraper en toute confiance.

À propos de l'auteur

Sorin-Gabriel Marica, Développeur full-stack @ WebScrapingAPI

Sorin-Gabriel Marica

Développeur full-stack

Sorin Marica est ingénieur Full Stack et DevOps chez WebScrapingAPI ; il développe des fonctionnalités pour les produits et assure la maintenance de l'infrastructure qui garantit le bon fonctionnement de la plateforme.

Web scraping avec AWS Lambda : guide pour Python et Java 2026
Guides

Web scraping avec AWS Lambda : guide pour Python et Java 2026

TL;DR: En bref : le web scraping avec AWS Lambda fonctionne mieux lorsque chaque invocation est courte, bien délimitée et peut faire l'objet d'une nouvelle tentative de manière indépendante. Commencez par utiliser les requêtes HTTP directes, AWS SAM et S3, puis ajoutez SQS, des conteneurs, le rendu dans un navigateur, des proxys ou une couche de récupération gérée uniquement lorsque la charge de travail démontre qu'elle en a besoin.

Suciu Dan33 min read
Lire l'article
Comment utiliser GoSpider : exploration, nettoyage des URL et extraction de données
Guides

Comment utiliser GoSpider : exploration, nettoyage des URL et extraction de données

TL;DR: En bref : GoSpider est un robot d'exploration en ligne de commande destiné à découvrir des URL, et non un outil complet de collecte de données structurées. Ce guide d'utilisation de GoSpider présente comment effectuer une exploration limitée, gérer correctement les résultats, transférer les données de Colly vers un fichier CSV, ainsi qu'une procédure de diagnostic pour les réponses 403 ou les pages nécessitant un rendu JavaScript.

Suciu Dan24 min read
Lire l'article
Comment récupérer les données de Redfin : Guide Python des données immobilières
Guides

Comment récupérer les données de Redfin : Guide Python des données immobilières

TL;DR: Redfin expose des points d'extrémité d'API cachés qui renvoient du JSON structuré pour les listes de propriétés, ce qui permet d'ignorer complètement l'analyse HTML fragile. Ce guide vous accompagne dans la construction d'un scraper Python qui extrait les données de location et de vente, effectue des recherches par emplacement, surveille les nouvelles inscriptions via des sitemaps XML et exporte des résultats propres au format CSV ou JSON.

Suciu Dan15 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.