Aller au contenu
Retour au blog

Web scraping ou web crawling : guide pour débutants

Anda MiuțescuDernière mise à jour le 14 min read
Web scraping ou web crawling : guide pour débutants
En bref : le crawling permet de découvrir et de visiter des pages pertinentes ; le scraping extrait les informations utiles de leur contenu. Si vous disposez déjà des URL, vous pouvez commencer par l'extraction. Si vous devez trouver des pages et collecter leurs données, combinez les deux tâches et vérifiez les résultats séparément.

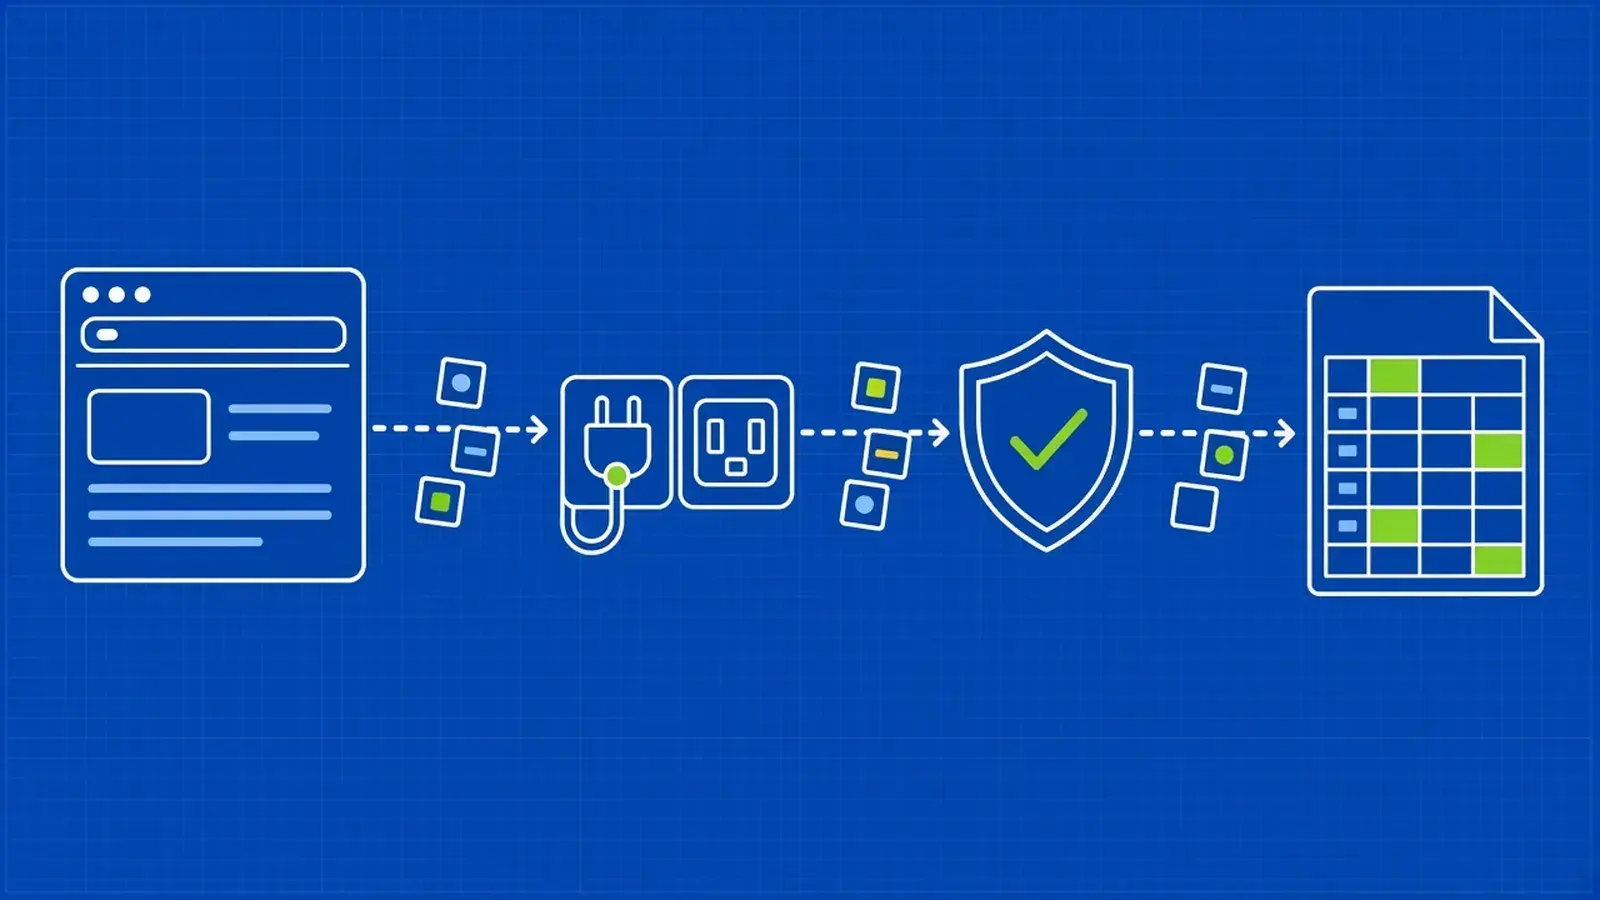
La différence entre le web scraping et le web crawling réside dans le fait que le premier consiste à extraire des informations de pages web, tandis que le second consiste à découvrir quelles pages visiter. On utilise le scraping pour collecter des données telles que les titres et les prix de livres ; on utilise le crawling pour trouver les pages qui les contiennent.

Imaginez que vous ayez besoin d’un tableau récapitulatif des livres de programmation vendus par une boutique en ligne. La page de catégorie vous donne un point de départ, mais elle peut renvoyer vers plusieurs pages de résultats. Trouver les adresses des livres est une tâche. Extraire le nom de l’auteur et le prix corrects de chaque page de livre en est une autre.

Connaître cette différence vous aide à éviter deux résultats frustrants : une longue liste de liens sans données exploitables, ou des données exactes provenant de quelques pages seulement tandis que le reste du catalogue passe inaperçu. Cela vous aide également à comprendre ce que fait réellement un outil lorsqu’il se présente comme un « scraper », un « crawler », un « spider » ou un service d’extraction de données.

Ce guide compare les résultats, explique les mécanismes et suit le parcours d’une librairie fictive, de la découverte des données jusqu’à la validation des enregistrements. Vous disposerez ainsi d’une méthode pratique pour choisir un workflow et le tester sur un petit lot avant de le déployer à plus grande échelle.

Web scraping vs web crawling : comparaison des résultats

Un « web crawler » (robot d’indexation) découvre des pages et décide lesquelles visiter. Un « web scraper » (outil de scraping) extrait des informations du contenu des pages. Tous deux récupèrent du contenu Web et peuvent traiter un grand nombre de pages, mais ils interviennent à des étapes différentes d’une tâche de collecte.

Ce que vous comparez

Exploration du Web

Extraction de données

Objectif principal

Trouver et visiter les pages pertinentes

Collecter les champs ou le texte dont vous avez besoin

Données d'entrée types

Adresses de départ et règles de navigation

Adresses de pages ou contenu et règles d'extraction

Résultats utiles

URL, pages téléchargées et informations sur les visites

Données structurées telles que les titres, les prix et les dates

Principale question relative à la qualité

La tâche a-t-elle atteint les pages visées ?

A-t-il extrait les bonnes valeurs ?

Échecs courants

Pages manquantes ou liens non pertinents suivis

Champs manquants ou lecture d’un élément erroné

Par exemple, découvrir les pages produits d’une boutique en ligne relève du crawling. Extraire le prix de chaque produit relève du scraping. Un projet qui surveille un catalogue évolutif doit pouvoir gérer ces deux aspects.

La distinction ne réside pas dans le fait d’avoir « une page ou plusieurs pages ». Vous pouvez extraire une liste fournie de milliers d’adresses sans découvrir de nouveaux liens. Vous pouvez également explorer une petite section explicitement délimitée d’un site.

Lorsque vous comparez des outils de scraping et d’exploration Web, demandez-vous ce que l’outil renvoie. Une liste de liens ne contient pas les prix que vous recherchez. À l’inverse, un prix correct provenant d’une page connue ne prouve pas que vous avez trouvé le reste du catalogue. Choisissez les fonctionnalités requises par votre résultat final.

Comment un robot d’exploration découvre des pages

Commencez par des URL de départ, c’est-à-dire les adresses à partir desquelles un robot d’exploration commence son exploration. Sur le site d’une librairie, une URL de départ pourrait être la catégorie « programmation ». Le robot d’exploration récupère cette page, identifie les liens pertinents et place les nouvelles adresses dans une file d’attente, qui n’est autre qu’une liste de pages en attente d’être visitées.

Un crawl délimité suit une séquence répétable :

  1. Récupérer une adresse dans la file d’attente.
  2. Lire les liens de la page renvoyée.
  3. Résoudre les liens relatifs par rapport à l’adresse de la page.
  4. Conserver les adresses autorisées par vos règles de domaine et de chemin d’accès.
  5. Ajouter les adresses non encore consultées à la file d'attente.
  6. Continuez jusqu’à ce que la file d’attente soit vide ou que la limite d’arrêt soit atteinte.

La pagination est l’une des raisons pour lesquelles cela est important. La première page d’une catégorie peut n’afficher qu’une partie de son catalogue. Suivre un lien vers la page suivante éligible peut révéler davantage de produits, tandis qu’une limite de pages permet de garder le test gérable.

L'exploration est également distincte de l'indexation. L'explication de Google sur le fonctionnement de la Recherche fait la distinction entre le téléchargement des pages et l'analyse et le stockage de leur contenu dans un index. La découverte ou la récupération ne garantit pas l'inclusion dans les résultats de recherche. Votre propre robot d'exploration peut avoir uniquement besoin de produire un inventaire, sans qu'aucun index de recherche n'intervienne.

Pour les projets de web scraping par opposition aux projets de web crawling, veillez à ce que cet inventaire reste consultable. Enregistrez l’adresse découverte et suffisamment d’informations sur la visite pour analyser les échecs. Notre guide de crawling GoSpider montre comment un outil de découverte dédié s’intègre dans un workflow de collecte plus large. La tâche du crawler est terminée lorsqu’il a atteint les pages définies par votre périmètre, et non lorsqu’il a exploré tous les liens qu’il rencontre.

Comment un outil de scraping extrait les champs utiles

Une page produit contient bien plus qu’un simple prix. Elle peut inclure des éléments de navigation, des produits associés, des avis clients et plusieurs prix correspondant à différentes éditions. Un outil de scraping a besoin de règles permettant de distinguer les champs souhaités du reste du contenu.

Le processus commence par l’analyse syntaxique, c’est-à-dire la lecture de la structure de la page afin de localiser les éléments pertinents. Un sélecteur CSS peut identifier un élément par son type, sa classe ou d’autres attributs. Par exemple, la méthode `querySelector` du navigateur renvoie le premier élément correspondant, ou aucun élément si aucun ne correspond. C’est en raison de ce comportement qu’un scraper doit gérer explicitement les champs manquants.

Une tâche d’extraction type se déroule comme suit :

  1. Récupérer le contenu de la page.
  2. Localiser les éléments contenant les champs requis.
  3. Lire leurs valeurs.
  4. Normaliser ces valeurs selon le format de votre choix.
  5. Valider l'enregistrement avant de l'enregistrer.

Un prix affiché de €18.50, par exemple, pourrait devenir 18.50 dans un champ numérique et EUR dans un champ de devise distinct. Déterminez si vous avez besoin du prix actuel, du prix d'origine ou des deux avant de créer la règle d'extraction.

Les sélecteurs CSS constituent une option ; le web scraping via XPath offre une autre méthode pour localiser du contenu au sein des structures de documents. Aucune de ces deux approches ne remplace la vérification de la présence effective des données souhaitées. Si une page ajoute des champs via JavaScript, un navigateur sans interface graphique peut s'avérer utile pour le rendu avant l'extraction.

C’est là que réside la différence entre le web scraping et le web crawling en termes de qualité des données. Une adresse peut être correcte et un téléchargement peut aboutir, alors que le prix extrait est manquant ou correspond à une autre édition. Validez les valeurs, et pas seulement le résultat de la requête.

Exemple d’une librairie : des liens aux enregistrements

Supposons que vous souhaitiez un petit ensemble de données sur des livres de programmation. Le domaine books.example, les titres de livres et les valeurs ci-dessous sont fictifs. Ils illustrent le déroulement du processus sans pour autant suggérer que nous ayons exécuté une collecte en conditions réelles.

Découvrez les adresses pertinentes

Fournissez au robot d’exploration l’adresse de la catégorie https://books.example/category/programming. Autorisez la pagination de cette catégorie et les pages de produits sur le même domaine. Excluez les catégories non pertinentes de cet exercice et fixez une limite de pages réduite avant de commencer.

La phase de découverte pourrait générer les adresses suivantes :

https://books.example/book/python-foundations
https://books.example/book/practical-web-data

Ces URL constituent le relais vers l’extraction. Elles vous indiquent où chercher, mais ne précisent pas encore le prix de chaque livre.

Extrayez et validez chaque enregistrement

Pour cet exercice, définissez cinq champs : URL source, titre, auteur, prix et devise. Voici à quoi pourrait ressembler un exemple d’enregistrement extrait :

{
  "url": "https://books.example/book/python-foundations",
  "title": "Python Foundations",
  "author": "Taylor Reed",
  "price": 18.5,
  "currency": "EUR"
}

Distinguez clairement les valeurs manquantes des valeurs réelles. Si aucun prix n’apparaît, marquez l’enregistrement pour révision au lieu d’enregistrer zéro. Si deux éditions partagent un même titre, conservez l’adresse d’identification plutôt que de les fusionner sur la seule base du titre. Une règle utile consiste à stocker suffisamment de contexte pour retrouver l’élément source exact.

Combiner les tâches sans les confondre

Un seul programme peut prendre en charge ces deux tâches. Le tutoriel Scrapy montre comment extraire des données et suivre les liens vers la page suivante au sein du même spider. L’utilisation d’applications distinctes est facultative ; ce sont des responsabilités clairement définies qui facilitent l’analyse des problèmes.

Pour cet exercice sur la librairie, examinez indépendamment l’inventaire des adresses et les enregistrements. Un livre manquant peut indiquer un problème de découverte. Un livre présent avec un prix erroné suggère un problème d’extraction. La distinction entre le web scraping et le web crawling est utile, car ces échecs nécessitent des solutions différentes.

Choisissez un workflow et testez-le sur un petit lot

Choisissez le workflow le plus simple capable de produire le résultat souhaité. Connaître les adresses exactes des pages permet souvent d’éviter une étape de découverte distincte.

Situation de départ

Première approche utile

Vous disposez d’une liste fixe d’URL de produits

Récupérez et extrayez ces pages

Vous devez localiser des pages dans une catégorie

Effectuez l'exploration dans des limites bien définies

Vous avez besoin d'enregistrements provenant d'un catalogue évolutif

Combiner la découverte et l'extraction

Vous avez besoin d’un inventaire des pages à des fins d’audit

Explorer et conserver les informations pertinentes relatives aux visites

Une fonctionnalité d'exportation adaptée ou une API documentée est disponible

Évaluez cette interface avant de collecter le contenu des pages

Le choix entre le web scraping et le web crawling doit également tenir compte de ce que vous êtes à l'aise de gérer. Un analyseur syntaxique nécessite des règles de sélection des champs. Un robot d'indexation nécessite des règles de navigation et d'arrêt. Un framework peut regrouper ces fonctionnalités, tandis qu'un service hébergé peut prendre en charge certaines parties spécifiques du travail.

Commencez par un site que vous contrôlez ou par un environnement de test dédié au scraping. Choisissez une page et notez les champs attendus avant de lancer quoi que ce soit. Comparez les données extraites avec la source, puis étendez l’opération à un petit lot que vous pouvez encore vérifier manuellement.

Définissez concrètement ce qui constitue une réussite pour ce lot : les pages attendues ont été atteintes, les champs obligatoires sont présents et les prix échantillonnés correspondent aux produits visés. Cela s’avère plus utile que de se contenter de compter les requêtes réussies.

Une fois que le lot fonctionne, modifiez un paramètre à la fois, comme le nombre de pages ou la catégorie couverte. Cela permet de relier plus facilement un résultat inattendu au changement qui l’a provoqué.

Évitez les erreurs courantes de crawling et de scraping

Une découverte de liens à grande échelle peut dépasser le cadre de la tâche que vous aviez prévue. Les filtres, les calendriers et les navigations répétées peuvent générer de nombreuses adresses. Définissez des limites et une condition d’arrêt avant d’étendre la couverture.

La gestion des doublons nécessite également une attention particulière. Certains paramètres d’URL se contentent d’enregistrer une visite ; d’autres sélectionnent une édition différente du produit ou une région spécifique. Vérifiez ce que modifie un paramètre avant de le supprimer. De même, des titres identiques ne prouvent pas que deux enregistrements décrivent le même article.

Respectez les instructions de crawl du site. La norme « Robots Exclusion Protocol » précise que robots.txt les règles ne constituent pas une autorisation d’accès. Un chemin autorisé ne doit pas être considéré comme une permission générale d’accéder à son contenu ou de le réutiliser. Limitez la collecte au champ d’application pour lequel vous êtes autorisé à opérer.

Surveillez les signaux de réponse ainsi que les données extraites. Le code HTTP 429 signifie que le client a envoyé trop de requêtes au cours d’une période donnée. Un Retry-After en-tête peut indiquer quand réessayer. Respectez ce signal plutôt que de répéter immédiatement la même requête dans une boucle serrée.

Enfin, comparez des tâches équivalentes. Une requête pour une page connue et un exploration découvrant des centaines de pages sont des tâches différentes. Les exigences de rendu, le volume de pages, la complexité de l’extraction et le rythme des requêtes influent sur le temps et les ressources nécessaires. Il n’y a pas de gagnant universel en matière de vitesse entre le web scraping et le web crawling. Suivez séparément les URL découvertes, les pages récupérées et les enregistrements valides afin de voir où le temps est consacré et où la tâche nécessite une attention particulière.

Points clés à retenir

  • Commencez par le résultat dont vous avez besoin. Un inventaire de pages nécessite une découverte ; un tableau de prix nécessite également une extraction de champs.
  • Limitez l’exploration aux domaines autorisés, aux chemins d’accès pertinents et à une limite d’arrêt explicite. Vérifiez les URL découvertes avant d’étendre la couverture.
  • Définissez les champs obligatoires avant le scraping. Considérez une valeur manquante comme un problème à examiner, plutôt que de la remplacer par une valeur par défaut qui semble plausible.
  • Vérifiez séparément la découverte, la récupération et l’extraction. Une requête réussie ne prouve pas que l’enregistrement correct a été généré.
  • Élargissez progressivement un petit lot vérifié afin de comprendre pourquoi les résultats évoluent.

FAQ

Puis-je extraire des données à partir de fichiers HTML enregistrés sur mon ordinateur ?

Oui. Vous pouvez analyser un fichier HTML enregistré sans récupérer à nouveau la page, à condition que le fichier contienne les champs dont vous avez besoin. Conservez l'URL d'origine et l'heure de téléchargement à côté du fichier afin que les valeurs extraites restent traçables. Si le fichier a été enregistré avant que JavaScript n'ajoute le contenu pertinent, ce contenu n'apparaîtra pas simplement parce que vous analysez le fichier plus tard.

Un robot d’indexation peut-il découvrir une page sans liens entrants ?

Un robot d’indexation a besoin d’une autre source pour cette adresse, telle qu’un plan du site ou une liste de départ explicite. Le suivi des liens ne suffit pas à lui seul à révéler une page vers laquelle aucune des pages visitées ne pointe. Lorsque l'exhaustivité est importante, comparez les résultats de la découverte à un inventaire de référence auquel vous avez accès. Une file d'attente vide signifie que l'exploration disponible est terminée ; cela ne prouve pas que toutes les pages ont été trouvées.

À quelle fréquence dois-je revisiter une page ?

Définissez la fréquence de revisite en fonction du degré d’actualité requis pour votre ensemble de données et des limites opérationnelles de la source. Une archive ponctuelle et un rapport quotidien sur les prix ont des exigences différentes. Enregistrez les heures de collecte et vérifiez si les champs changent réellement entre deux visites. Utilisez ces observations pour affiner la fréquence de collecte, plutôt que de partir du principe qu’une collecte plus fréquente produit toujours des données plus utiles.

Dois-je apprendre Python pour commencer ?

Non. L’exploration et l’extraction de données sont des tâches plutôt que des fonctionnalités propres à un langage de programmation. Vous pouvez utiliser un autre langage que vous maîtrisez déjà ou un outil proposant le flux de travail requis via une interface visuelle. Vous devrez tout de même définir les pages et les champs souhaités, inspecter les enregistrements obtenus et comprendre quelles parties du processus l’outil gère à votre place.

Conclusion : élaborez le flux de travail le plus simple possible qui produise des données utiles

Le résultat utile d’un projet de collecte, ce sont des données que vous pouvez comprendre et vérifier. Le « web scraping » et le « web crawling » décrivent deux tâches qui vous aident à atteindre ce résultat : trouver les pages pertinentes et en extraire les informations dont vous avez besoin.

Si vous disposez déjà des adresses, commencez par tester l’extraction sur une seule page. Si les adresses manquent, définissez d’abord une tâche de découverte limitée. Dans les deux cas, déterminez à quoi ressemble un enregistrement valide avant d’augmenter le volume. L’exemple de la librairie fonctionne car les champs de sortie et la portée prévue des pages sont suffisamment clairs pour être vérifiés.

Gardez le suivi du transfert de tâches visible à mesure que le projet prend de l’ampleur. Notez quelles pages ont été découvertes, lesquelles ont été récupérées et lesquelles ont produit des données valides. Ces informations vous aident à distinguer un problème de navigation d’un champ manquant ou d’une requête ayant échoué, et elles vous fournissent un point de départ concret pour les corrections.

Si la récupération des pages devient la partie pour laquelle vous avez besoin d’aide, explorez l’API Scraper de WebScrapingAPI. Elle peut prendre en charge la couche de récupération tandis que vous conservez une définition explicite de votre périmètre de collecte et de vos vérifications de données. Commencez par une page représentative et évaluez le résultat par rapport aux champs dont votre projet a réellement besoin.

À propos de l'auteur

Anda Miuțescu, Rédacteur de contenu technique @ WebScrapingAPI

Anda Miuțescu

Rédacteur de contenu technique

Anda Miuțescu est rédactrice de contenu technique chez WebScrapingAPI ; elle rédige des articles clairs et utiles qui aident les développeurs à comprendre le produit et ses fonctionnalités.

Tutoriel Python Nodriver : extraction de données de navigateur en mode furtif, du premier script à la mise en production
Les techniques de web scraping

Tutoriel Python Nodriver : extraction de données de navigateur en mode furtif, du premier script à la mise en production

TL;DR: En bref : Nodriver est une bibliothèque Python asynchrone qui pilote Chromium via le Chrome DevTools Protocol, sans Selenium ni binaire chromedriver. Utilisez-la lorsqu'un navigateur furtif auto-hébergé, plus proche d'une vraie session Chrome, convient mieux qu'une pile WebDriver, mais sachez qu'elle ne supprime pas à elle seule les risques liés à l'IP, au TLS ou au comportement. Ce tutoriel va d'un premier script à la production en conteneur et à une Browser API hébergée.

Suciu Dan16 min read
Lire l'article
Comment gérer les URL de redirection Google /goto et les jetons CAES dans un outil de collecte de données SERP
Les techniques de web scraping

Comment gérer les URL de redirection Google /goto et les jetons CAES dans un outil de collecte de données SERP

TL;DR: En bref : Les URL Google /goto avec un jeton CAES, ainsi que les anciens wrappers /url, sont des couches de redirection, pas des destinations : un scraper de SERP qui traite chaque href comme final fausse le suivi de positions et les bases de liens. Préférez une API SERP structurée lorsqu'elle renvoie les liens de destination. Si vous devez analyser le HTML, classez chaque href, dédoublonnez les redirections et résolvez-les avec un simple GET. Ne déchiffrez pas CAES.

Suciu Dan14 min read
Lire l'article
En-têtes de réponse HTTP dans cURL : Tous les drapeaux, techniques et recettes de script
Les techniques de web scraping

En-têtes de réponse HTTP dans cURL : Tous les drapeaux, techniques et recettes de script

TL;DR: cURL cache les en-têtes de réponse par défaut. Utilisez -i pour voir les en-têtes avec le corps, -I pour une requête HEAD qui ne renvoie que les en-têtes, -v pour un débogage complet de la requête/réponse, et -D pour enregistrer les en-têtes dans un fichier. Pour les scripts modernes, cURL 7.83+ vous permet d'extraire des en-têtes individuels ou de les récupérer tous en JSON avec l'option -w write-out.

Suciu Dan13 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.