Aller au contenu

Blog · Articles

Les techniques de web scraping

Des analyses techniques approfondies sur les principes scientifiques qui sous-tendent l'exploration et l'analyse syntaxique des sites web, les systèmes anti-bots, ainsi que les défis techniques liés à l'extraction de données à l'échelle du web.

Articles publiés

34

Articles

Les techniques de web scraping

34 articles

Tutoriel Python Nodriver : extraction de données de navigateur en mode furtif, du premier script à la mise en production
Les techniques de web scraping

Tutoriel Python Nodriver : extraction de données de navigateur en mode furtif, du premier script à la mise en production

TL;DR: En bref : Nodriver est une bibliothèque Python asynchrone qui pilote Chromium via le Chrome DevTools Protocol, sans Selenium ni binaire chromedriver. Utilisez-la lorsqu'un navigateur furtif auto-hébergé, plus proche d'une vraie session Chrome, convient mieux qu'une pile WebDriver, mais sachez qu'elle ne supprime pas à elle seule les risques liés à l'IP, au TLS ou au comportement. Ce tutoriel va d'un premier script à la production en conteneur et à une Browser API hébergée.

Suciu Dan16 min read
Lire l'article
Comment gérer les URL de redirection Google /goto et les jetons CAES dans un outil de collecte de données SERP
Les techniques de web scraping

Comment gérer les URL de redirection Google /goto et les jetons CAES dans un outil de collecte de données SERP

TL;DR: En bref : Les URL Google /goto avec un jeton CAES, ainsi que les anciens wrappers /url, sont des couches de redirection, pas des destinations : un scraper de SERP qui traite chaque href comme final fausse le suivi de positions et les bases de liens. Préférez une API SERP structurée lorsqu'elle renvoie les liens de destination. Si vous devez analyser le HTML, classez chaque href, dédoublonnez les redirections et résolvez-les avec un simple GET. Ne déchiffrez pas CAES.

Suciu Dan14 min read
Lire l'article
En-têtes de réponse HTTP dans cURL : Tous les drapeaux, techniques et recettes de script
Les techniques de web scraping

En-têtes de réponse HTTP dans cURL : Tous les drapeaux, techniques et recettes de script

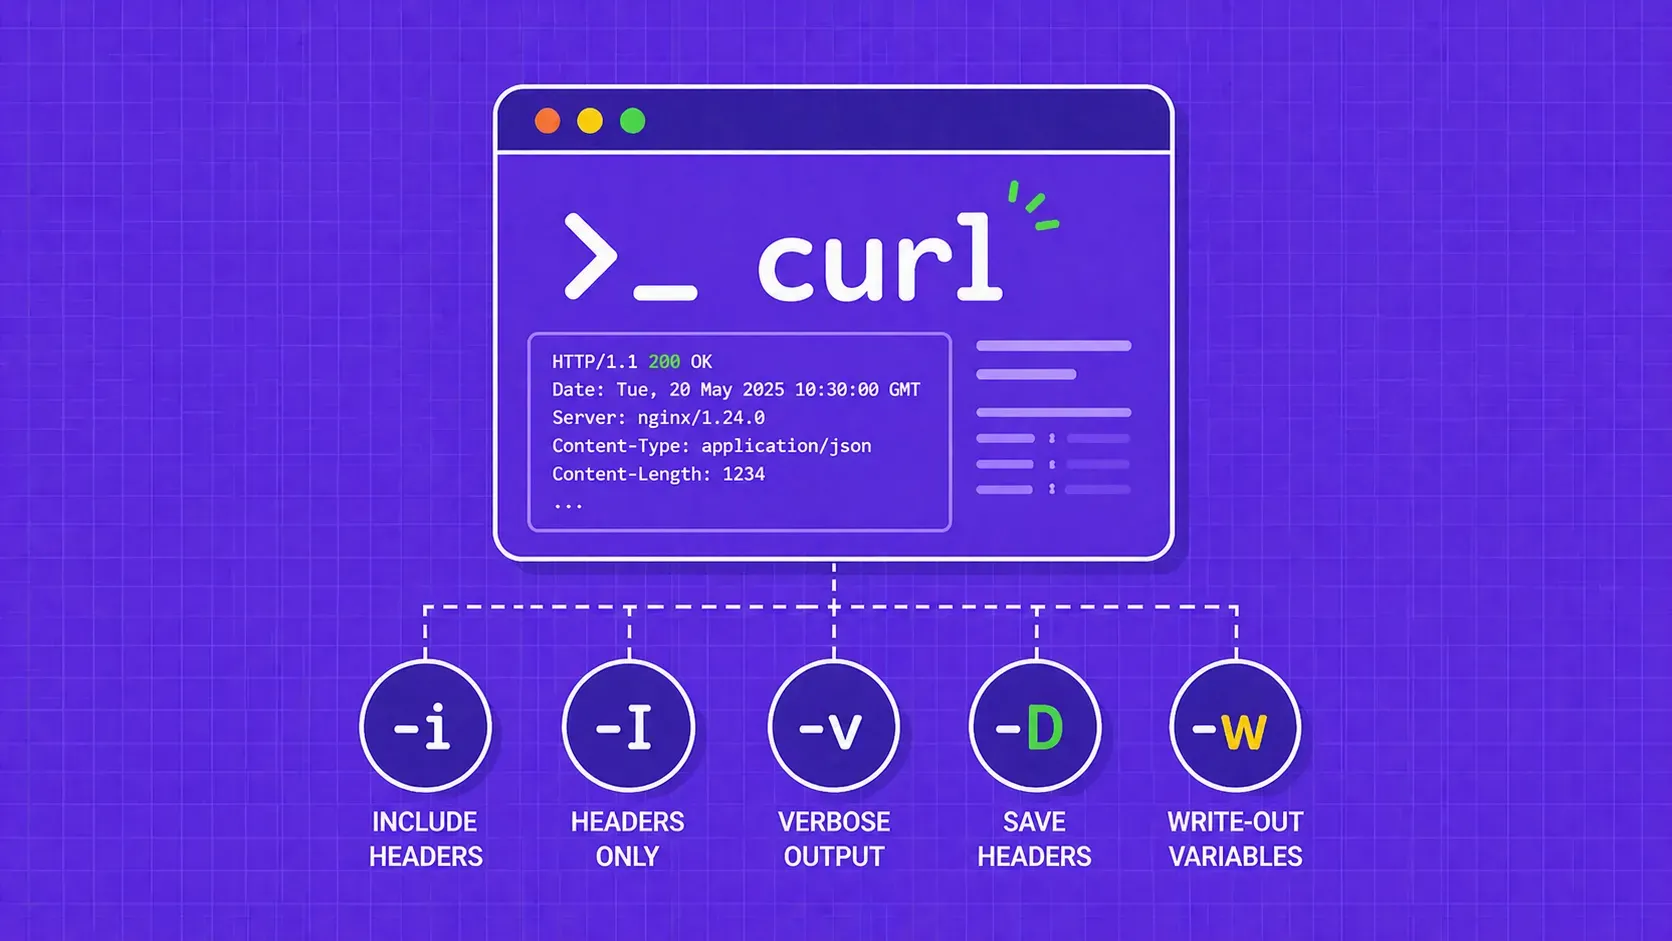
TL;DR: cURL cache les en-têtes de réponse par défaut. Utilisez -i pour voir les en-têtes avec le corps, -I pour une requête HEAD qui ne renvoie que les en-têtes, -v pour un débogage complet de la requête/réponse, et -D pour enregistrer les en-têtes dans un fichier. Pour les scripts modernes, cURL 7.83+ vous permet d'extraire des en-têtes individuels ou de les récupérer tous en JSON avec l'option -w write-out.

Suciu Dan13 min read
Lire l'article
Qu'est-ce qu'un navigateur sans tête ? Architecture, cas d'utilisation et principaux outils
Les techniques de web scraping

Qu'est-ce qu'un navigateur sans tête ? Architecture, cas d'utilisation et principaux outils

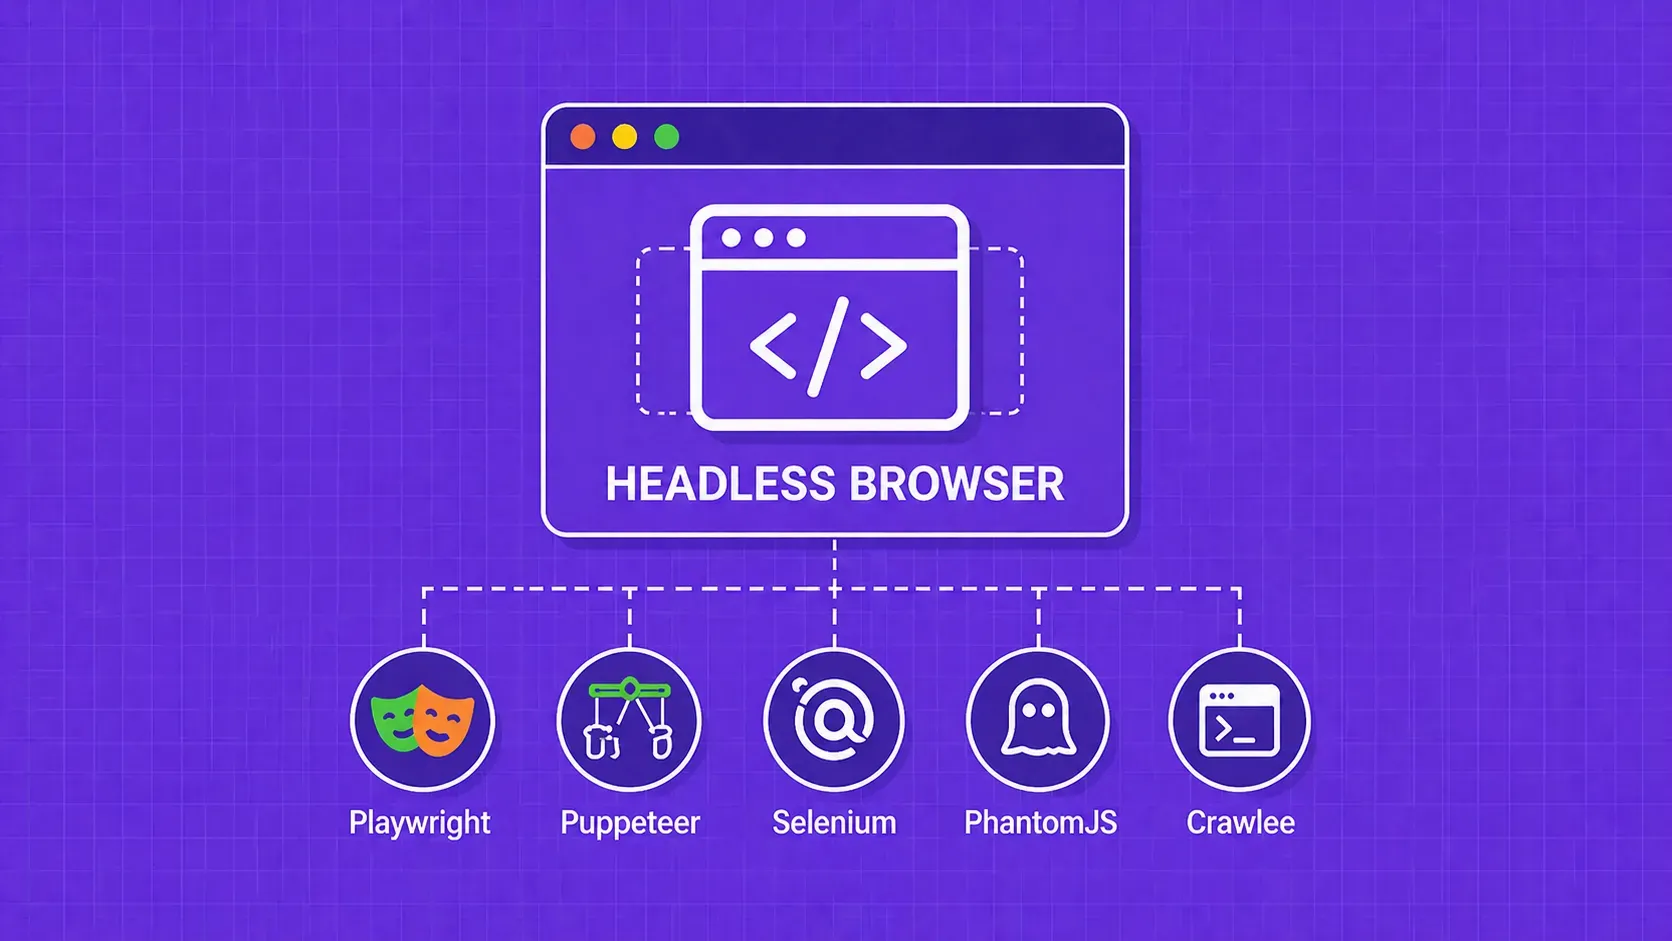
TL;DR: Un navigateur sans tête est un navigateur web qui fonctionne sans interface graphique visible, entièrement contrôlé par du code ou des instructions en ligne de commande. Les développeurs utilisent les navigateurs headless pour les tests automatisés, le web scraping, le contrôle des performances et, de plus en plus, pour alimenter les agents d'intelligence artificielle. Ce guide explique comment ils fonctionnent en interne, quand les choisir plutôt qu'un navigateur classique, et quels sont les frameworks qui valent la peine d'être utilisés.

Suciu Dan16 min read
Lire l'article
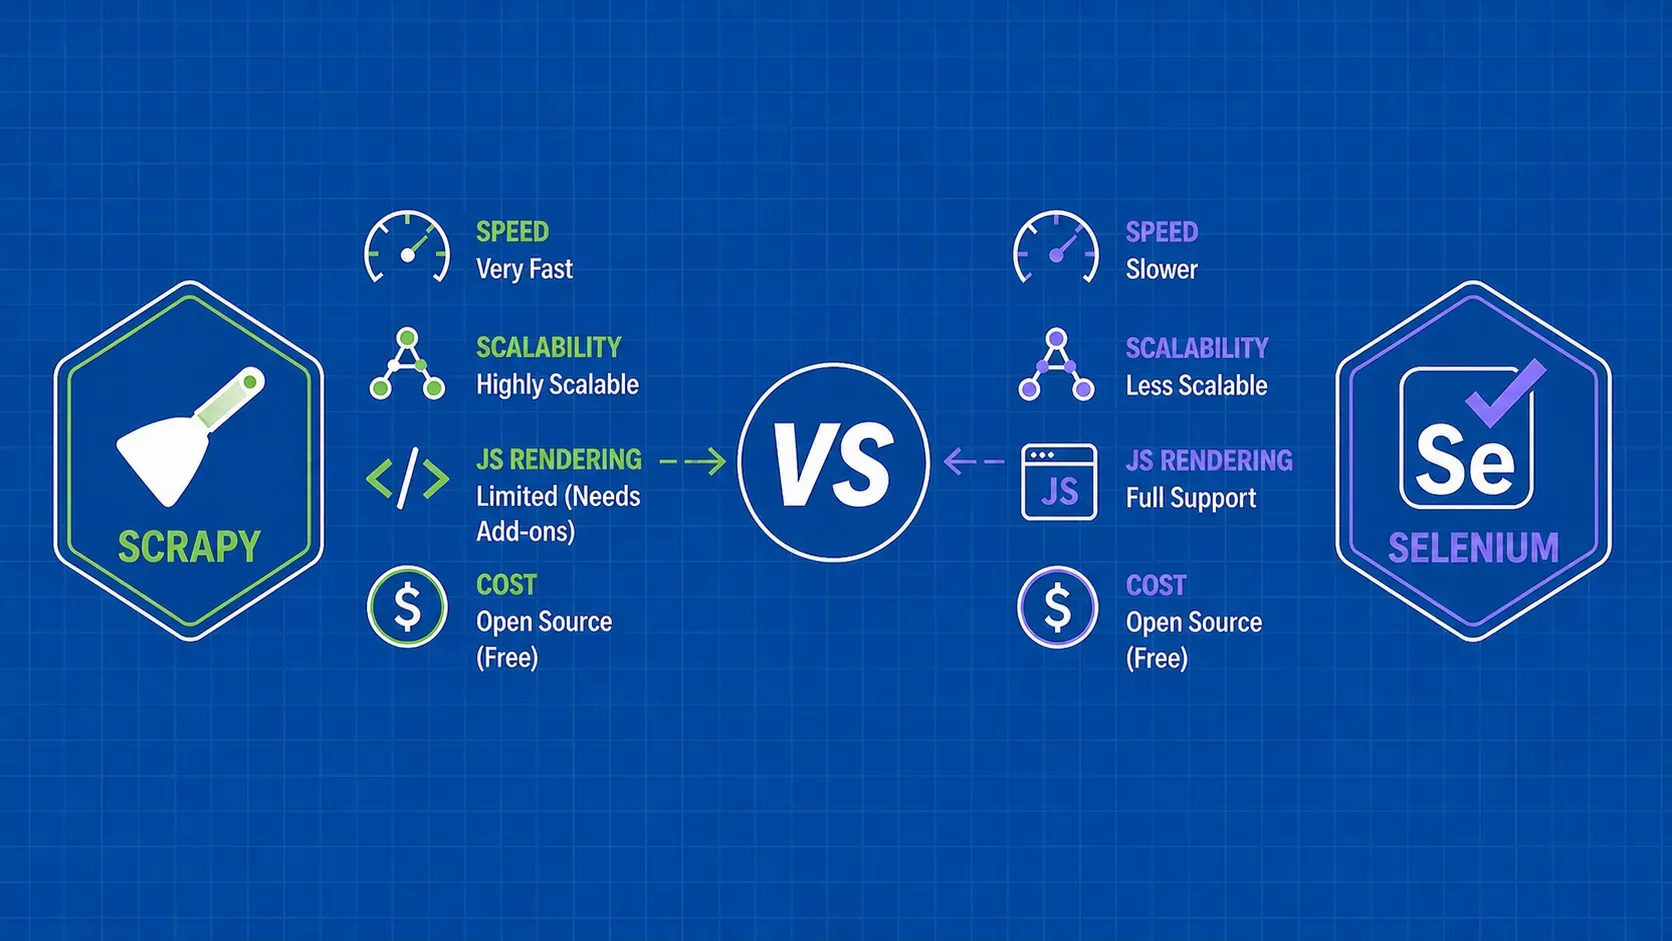
Scrapy vs Selenium : Qui gagne ?
Les techniques de web scraping

Scrapy vs Selenium : Qui gagne ?

TL;DR: Scrapy est un cadre de crawling asynchrone à grande vitesse conçu pour extraire des données structurées à partir de pages statiques à grande échelle. Selenium automatise les navigateurs réels et gère les sites à forte composante JavaScript, mais à un coût en ressources beaucoup plus élevé. La plupart des projets de scraping en production gagnent à savoir quand utiliser l'un ou l'autre, ou quand les combiner.

Gabriel Cioci11 min read
Lire l'article
L'analyse de données expliquée : Outils, techniques et code (2026)
Les techniques de web scraping

L'analyse de données expliquée : Outils, techniques et code (2026)

TL;DR: L'analyse syntaxique des données convertit le contenu brut (HTML, JSON, XML, PDF) en champs structurés que votre code peut réellement utiliser. Ce guide explique étape par étape le fonctionnement de l'analyse de données, compare les principales techniques et bibliothèques, et vous donne un cadre pratique pour décider de construire ou d'acheter votre couche d'analyse.

Suciu Dan18 min read
Lire l'article
Qu'est-ce que l'automatisation des navigateurs ? Un guide pratique
Les techniques de web scraping

Qu'est-ce que l'automatisation des navigateurs ? Un guide pratique

TL;DR: L'automatisation du navigateur est la pratique qui consiste à piloter un navigateur web réel ou sans tête à partir du code afin qu'il clique, tape, navigue et lise des pages en votre nom. Ce guide explique ce qu'est l'automatisation de navigateur sous le capot, compare Selenium, Playwright, Puppeteer et Cypress, et montre quand il n'est pas nécessaire d'utiliser un navigateur complet.

Ștefan Răcilă13 min read
Lire l'article
Web Scraping vs Data Mining : Différences, pipelines, et quand utiliser l'un ou l'autre
Les techniques de web scraping

Web Scraping vs Data Mining : Différences, pipelines, et quand utiliser l'un ou l'autre

TL;DR: Le web scraping collecte des données brutes à partir de pages web publiques. Le data mining analyse les données structurées pour mettre en évidence des modèles, des prédictions et des segments. Il s'agit de différentes étapes du même cycle de vie, et la plupart des systèmes de production les combinent dans un pipeline "scrape-then-normalize-then-mine".

Ștefan Răcilă17 min read
Lire l'article
Les meilleurs cours de web scraping pour développeurs
Les techniques de web scraping

Les meilleurs cours de web scraping pour développeurs

TL;DR: Les meilleurs cours de web scraping dépendent de votre langue, de votre niveau et de votre cas d'utilisation. Ce guide compare cinq choix payants parmi Udemy, Coursera, DataCamp et Packt, indique les compléments gratuits comme les documents officiels, et montre comment passer de la fin d'un cours à l'exécution de scrapers de production.

Ștefan Răcilă13 min read
Lire l'article
10 questions sur le scraping auxquelles toute équipe de données devrait répondre avant d'écrire un scraper
Les techniques de web scraping

10 questions sur le scraping auxquelles toute équipe de données devrait répondre avant d'écrire un scraper

TL;DR: Un projet de web scraping échoue au niveau de la planification bien avant d'échouer au niveau du code. Ces dix questions sur le scraping vous guident à travers la légalité, les alternatives d'API, les défenses anti-bots, le coût, la cadence de rafraîchissement, la qualité des données et la gouvernance, afin que vous puissiez évaluer le travail, choisir la bonne stack et éviter les modes d'échec qui tuent discrètement les scrappeurs en production.

Mihai Maxim13 min read
Lire l'article
15 Meilleurs navigateurs anti-détection en 2026 : Comparaison honnête pour les marketeurs, les scrappeurs et les gestionnaires de comptes multiples
Les techniques de web scraping

15 Meilleurs navigateurs anti-détection en 2026 : Comparaison honnête pour les marketeurs, les scrappeurs et les gestionnaires de comptes multiples

TL;DR: Les navigateurs antidétection vous permettent d'exécuter plusieurs profils de navigateur isolés, chacun avec une empreinte digitale unique, de sorte que les plateformes ne peuvent pas relier vos comptes. Ce guide classe les 15 meilleurs navigateurs antidétection de 2026 en fonction de la qualité de l'empreinte, de la prise en charge de l'automatisation, du prix et de l'intégration du proxy. Nous expliquons également comment ces outils fonctionnent réellement, quand une API de scraping est le meilleur choix, et quel type de proxy associer à chaque cas d'utilisation.

Mihnea-Octavian Manolache34 min read
Lire l'article
Qu'est-ce qu'un proxy ISP ? Guide pour le Web Scraping et l'automatisation
Les techniques de web scraping

Qu'est-ce qu'un proxy ISP ? Guide pour le Web Scraping et l'automatisation

TL;DR: Que sont les proxys des FAI ? Il s'agit d'IP résidentielles statiques hébergées dans un centre de données. Les systèmes de détection voient un ASN résidentiel ; vous obtenez le débit d'un centre de données. C'est le bon choix lorsque les sessions, la liaison de compte et la tarification prévisible par IP sont plus importantes que la portée géographique brute.

Mihnea-Octavian Manolache12 min read
Lire l'article
En-têtes HTTP Web Scraping : Ne plus être bloqué
Les techniques de web scraping

En-têtes HTTP Web Scraping : Ne plus être bloqué

TL;DR: Les en-têtes HTTP sont généralement la raison pour laquelle votre scraper obtient un 403 alors que votre navigateur charge la même URL sans problème. Ce guide montre quels en-têtes les systèmes anti-bots inspectent réellement, comment capturer le jeu d'en-têtes d'un vrai navigateur à partir de DevTools, comment les envoyer et les faire pivoter correctement en Python et Node.js, et quand le réglage manuel cesse d'être payant et qu'une API de scraping gérée est la meilleure solution.

Raluca Penciuc15 min read
Lire l'article
Meilleurs Proxies Résidentiels Rotatifs en 2026 pour le Web Scraping
Les techniques de web scraping

Meilleurs Proxies Résidentiels Rotatifs en 2026 pour le Web Scraping

TL;DR: Les meilleurs proxys résidentiels tournants en 2026 ne sont pas ceux qui ont le plus grand pool de panneaux d'affichage. Ce sont ceux dont le contrôle de session, le géo-ciblage, le sourcing éthique et l'économie par Go correspondent réellement aux cibles que vous scrapez. Ce guide vous propose un cadre d'évaluation neutre, un tableau comparatif de 12 fournisseurs et une carte des cas d'utilisation afin que vous puissiez en présélectionner deux ou trois avant même d'utiliser votre carte de crédit.

Anda Miuțescu48 min read
Lire l'article
Node Unblocker pour le web scraping
Les techniques de web scraping

Node Unblocker pour le web scraping

TL;DR: Node-unblocker transforme une application Express en un proxy HTTP à préfixe d'URL que vous pouvez pirater. Ce guide de node-unblocker pour le web scraping explique comment l'installer, configurer des middlewares de requête et de réponse, faire tourner les instances, les déployer sur Docker ou Heroku, et reconnaître le moment où une API de scraping gérée est la solution la plus saine.

Sorin-Gabriel Marica13 min read
Lire l'article
Qu'est-ce qu'un proxy rotatif ? Guide de la rotation d'IP pour le Web Scraping
Les techniques de web scraping

Qu'est-ce qu'un proxy rotatif ? Guide de la rotation d'IP pour le Web Scraping

TL;DR: Qu'est-ce qu'un serveur mandataire rotatif ? Ce sont des serveurs proxy qui assignent une IP différente à chaque requête provenant d'un pool géré, ce qui permet aux scrapers de passer outre les limites de taux par IP, les CAPTCHA et les géo-filtres. Ce guide explique le fonctionnement de la rotation, les quatre types de pools, le code d'installation en trois langues et la manière de choisir un fournisseur.

Raluca Penciuc13 min read
Lire l'article
Aide-mémoire des sélecteurs CSS pour le web scraping
Les techniques de web scraping

Aide-mémoire des sélecteurs CSS pour le web scraping

TL;DR: Utilisez cet aide-mémoire des sélecteurs CSS lorsque vous souhaitez extraire des données du Web comme un pro

Ștefan Răcilă7 min read
Lire l'article
Comment construire un crawler web en Python : Du début à la fin
Les techniques de web scraping

Comment construire un crawler web en Python : Du début à la fin

TL;DR: Un crawler web python automatise le travail fastidieux qui consiste à suivre des liens sur un site web pour découvrir et collecter du contenu. Ce guide vous accompagne dans la construction d'un crawler à partir de zéro avec des requêtes et BeautifulSoup, puis en passant à Scrapy pour le crawling concurrent, les pipelines d'éléments et l'exportation de données structurées. Vous apprendrez également à crawler de manière responsable, à faire pivoter les proxies pour éviter les blocages, et à gérer les pages rendues en JavaScript.

Suciu Dan34 min read
Lire l'article
Liste des proxys haut de gamme 2026 : classement des 9 meilleurs services de proxys payants
Les techniques de web scraping

Liste des proxys haut de gamme 2026 : classement des 9 meilleurs services de proxys payants

TL;DR: En bref : Pour la plupart des équipes de scraping, Oxylabs et Decodo sont les services de proxys premium les plus solides et polyvalents, Bright Data convient aux budgets d'entreprise, et Webshare est le moyen le moins cher de démarrer avec une liste statique. Choisissez une liste statique si vous voulez des IP qui restent les vôtres pendant la durée de location, et une passerelle rotative si chaque requête ou session doit sortir par une IP différente.

Gabriel Cioci30 min read
Lire l'article
Styles d'API : comparaison de cinq modèles d'intégration concrets
Les techniques de web scraping

Styles d'API : comparaison de cinq modèles d'intégration concrets

TL;DR: Distinguez cinq approches courantes en matière d'API sans confondre architecture, protocoles et modèles de mise à disposition. Comparez leurs contrats à l'aide d'un scénario pratique tiré d'un catalogue.

Robert Munceanu16 min read
Lire l'article
Classement des meilleures listes de proxys gratuits pour le web scraping (2026)
Les techniques de web scraping

Classement des meilleures listes de proxys gratuits pour le web scraping (2026)

TL;DR: En bref : Les meilleures listes de proxys gratuits pour le web scraping sont celle de ProxyScrape pour les scripts, celle de Geonode pour la disponibilité et les filtres ASN, et monosans/proxy-list sur GitHub pour alimenter des pipelines en texte brut. Traitez chaque liste comme un vivier de candidats, car seule une petite part des proxys listés fonctionne un jour donné, et ne faites jamais passer de connexions ou de pages de paiement par un proxy gratuit.

Robert Munceanu29 min read
Lire l'article
Les meilleurs proxys de centre de données partagés et dédiés en 2026
Les techniques de web scraping

Les meilleurs proxys de centre de données partagés et dédiés en 2026

TL;DR: Les proxys de centre de données partagés, semi-dédiés et dédiés présentent des tarifs et des modalités de facturation tellement différents que le prix affiché le plus bas est souvent celui qui revient le plus cher. Ce guide compare 11 fournisseurs sur la base de leurs prix catalogue actuels, en sélectionne un pour chaque type de tâche, explique les différences entre la facturation par adresse IP et par Go ainsi que les conditions d'utilisation équitable, et inclut des scripts Python permettant d'estimer les coûts et de vérifier si vos adresses IP sont réellement dédiées.

Anda Miuțescu28 min read
Lire l'article
Web scraping ou web crawling : guide pour débutants
Les techniques de web scraping

Web scraping ou web crawling : guide pour débutants

TL;DR: Découvrez comment les robots d'indexation trouvent les pages et comment les outils de scraping extraient des données utiles. Prenez l'exemple d'une librairie, comparez leurs résultats et choisissez le workflow le mieux adapté à votre premier projet.

Anda Miuțescu14 min read
Lire l'article
Meilleurs proxys mobiles pour le web scraping en 2026 : 9 fournisseurs classés
Les techniques de web scraping

Meilleurs proxys mobiles pour le web scraping en 2026 : 9 fournisseurs classés

TL;DR: Comparez 9 fournisseurs de proxys mobiles pour le scraping : prix au Go ou par port, ciblage opérateur et ASN, 5G, sessions persistantes et essais, en octobre 2026.

Sergiu Inizian27 min read
Lire l'article
Bonnes pratiques en matière de web scraping : un guide complet couvrant l'ensemble du cycle de vie, avec des conseils et du code fonctionnel
Les techniques de web scraping

Bonnes pratiques en matière de web scraping : un guide complet couvrant l'ensemble du cycle de vie, avec des conseils et du code fonctionnel

TL;DR: Bonnes pratiques en matière de web scraping pour chaque étape du cycle de vie d'un scraper : planifier les données, respecter le fichier robots.txt tel que défini par la norme RFC 9309, limiter la fréquence d'accès à chaque hôte et respecter l'en-tête Retry-After, effectuer un analyse défensive, valider chaque enregistrement, surveiller les exécutions, vérifier la progression et suivre le coût par enregistrement valide. Chaque étape est accompagnée d'un court extrait de code Python fonctionnel.

Anda Miuțescu36 min read
Lire l'article
Web scraping sans être bloqué : le guide 2026
Les techniques de web scraping

Web scraping sans être bloqué : le guide 2026

TL;DR: Les blocages modernes se produisent sur quatre couches : le réseau, la signature de la requête, le navigateur et le comportement. Diagnostiquez d'abord la couche à l'aide des codes d'état et des pages de défi, puis corrigez-la avec la bonne combinaison de proxies résidentiels rotatifs, d'en-têtes de qualité navigateur, d'usurpation d'identité TLS, de navigateurs furtifs et d'une synchronisation de type humain. Lorsque le volume ou la sophistication de la lutte contre les robots rend le bricolage peu rentable, déchargez la couche de demande vers une API gérée.

Sergiu Inizian40 min read
Lire l'article
Extraction de données sur le Web : blocs d'adresses IP. Effectuez un diagnostic avant de réessayer
Les techniques de web scraping

Extraction de données sur le Web : blocs d'adresses IP. Effectuez un diagnostic avant de réessayer

TL;DR: Identifiez les causes d'un échec de scraping avant de conclure à un blocage d'adresse IP. Diagnostiquez les limitations de débit, les problèmes de session et les refus d'accès, puis vérifiez que le système a bien été rétabli.

Anda Miuțescu16 min read
Lire l'article
Avantages de l'API de web scraping : ce que vous externalisez réellement
Les techniques de web scraping

Avantages de l'API de web scraping : ce que vous externalisez réellement

TL;DR: Découvrez quelles responsabilités une API de scraping peut prendre en charge et lesquelles restent à votre charge. Évaluez le rendu, le format structuré des données, la récupération et le coût par enregistrement exploitable.

Anda Miuțescu16 min read
Lire l'article
Les meilleurs types de proxy pour le scraping web en 2026
Les techniques de web scraping

Les meilleurs types de proxy pour le scraping web en 2026

TL;DR: Les proxys de web scraping s'interposent entre votre scraper et le site cible, masquent votre IP et vous permettent de survivre aux limites de débit, aux géo-walls et aux défenses anti-bots. Le bon type (centre de données, résidentiel, FAI ou mobile) et le bon protocole (HTTP/HTTPS ou SOCKS5, IPv4 ou IPv6) dépendent des défenses de la cible, de vos besoins géographiques et du poids de chaque page. Ce guide présente les compromis et se termine par une liste de contrôle indépendante des fournisseurs.

Raluca Penciuc16 min read
Lire l'article
Gestion des serveurs proxy pour le web scraping : une approche pratique
Les techniques de web scraping

Gestion des serveurs proxy pour le web scraping : une approche pratique

TL;DR: Concevez l'attribution des proxys en fonction des besoins opérationnels, des durées de validité des sessions, de la santé des couches et des limites à l'échelle de la source. Mesurez le nombre d'enregistrements acceptés plutôt que les rotations d'adresses.

Raluca Penciuc16 min read
Lire l'article
Les meilleurs serveurs proxy pour le web scraping en 2026 : sélection en fonction de l'usage et du coût
Les techniques de web scraping

Les meilleurs serveurs proxy pour le web scraping en 2026 : sélection en fonction de l'usage et du coût

TL;DR: En bref : Les meilleurs proxys pour le web scraping sont les moins chers que votre cible accepte. Utilisez des proxys datacenter pour les sites ouverts en volume, FAI pour garder une IP pendant des parcours connectés ou en plusieurs étapes, résidentiels pour les sites plus stricts et le ciblage par ville, et mobiles pour les cibles mobile-first. Choisissez d'abord le type selon la tâche, puis comparez les fournisseurs sur le coût par requête réussie, pas sur le prix par Go.

Robert Munceanu29 min read
Lire l'article
Scraper personnalisé ou outils d'extraction de données : développer ou acheter ?
Les techniques de web scraping

Scraper personnalisé ou outils d'extraction de données : développer ou acheter ?

TL;DR: Déterminez s'il convient de développer, d'acheter ou de combiner des outils d'extraction de données en vous appuyant sur un contrat de données, une comparaison des modes de propriété, un modèle de coût global et un projet pilote concret.

Sergiu Inizian17 min read
Lire l'article
Les meilleurs outils de scraping web de 2026
Les techniques de web scraping

Les meilleurs outils de scraping web de 2026

TL;DR: Les meilleurs outils de web scraping de 2026 se répartissent en trois catégories : les API gérées qui cachent les proxies, les navigateurs sans tête et les CAPTCHA derrière un appel HTTP ; les frameworks open-source comme Scrapy et Crawlee qui vous donnent un contrôle total si vous pouvez les héberger ; et les scrapers visuels sans code pour les non-développeurs. Il n'y a pas de gagnant unique. Nous comparons plus de 22 options en fonction des modèles de tarification, du rendu JavaScript, de la puissance anti-bot et des cas d'utilisation idéaux, afin que vous puissiez en sélectionner deux ou trois à tester sur vos sites cibles réels.

Gabriel Cioci61 min read
Lire l'article
Qu'est-ce que le Web Scraping ? Un guide pratique pour les développeurs
Les techniques de web scraping

Qu'est-ce que le Web Scraping ? Un guide pratique pour les développeurs

TL;DR: Le web scraping est l'extraction automatisée de données web publiques dans un format structuré utilisable, tel que JSON ou une feuille de calcul. Ce guide traite de la définition du web scraping, du pipeline de requêtes et d'analyse qui le sous-tend, des équipes qui le mettent en œuvre, de la gamme d'outils allant de l'absence de code aux API gérées, et de la manière de rester du bon côté des défenses anti-bots et de la loi.

Sergiu Inizian22 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.