Aller au contenu
Retour au blog

Comment gérer les URL de redirection Google /goto et les jetons CAES dans un outil de collecte de données SERP

Suciu DanDernière mise à jour le 14 min read
Comment gérer les URL de redirection Google /goto et les jetons CAES dans un outil de collecte de données SERP
En bref : Les URL Google /goto avec un jeton CAES, ainsi que les anciens wrappers /url, sont des couches de redirection, pas des destinations : un scraper de SERP qui traite chaque href comme final fausse le suivi de positions et les bases de liens. Préférez une API SERP structurée lorsqu'elle renvoie les liens de destination. Si vous devez analyser le HTML, classez chaque href, dédoublonnez les redirections et résolvez-les avec un simple GET. Ne déchiffrez pas CAES.

La recherche Google peut insérer une redirection opaque entre un résultat de la page de résultats (SERP) et la page de destination. Au lieu de https://example.com/page dans la href, vous verrez peut-être https://www.google.com/goto?url=CAES...— ou un ancien /url conteneur contenant le même type de jeton. Pour les utilisateurs, un clic mène toujours au bon site. Pour un robot de scraping qui traite chaque href comme une page finale, cela perturbe le suivi des classements, les bases de données de liens sortants et les explorations en aval.

Il s’agit d’un pipeline d’URL en production, et non d’un article sur la cryptographie. Privilégiez une API structurée de Google Search (SERP) lorsqu’elle renvoie des liens de destination. Lorsque vous devez analyser du code HTML, classez chaque href, dédupliquez les redirections, résolvez-les à l’aide d’un simple GETet gérez les échecs. Ne déchiffrez pas CAES.

Points clés à retenir

  • Traitez /goto?url=CAES... et /url?... comme des couches de redirection, et non comme des destinations.
  • Ne pas déchiffrer CAES. Résolvez avec GET et allow_redirects=False, puis lisez Location.
  • Privilégier le chemin A : JSON structuré de l’API WebScrapingAPI SERP lorsque les link sont des destinations.
  • Utilisez la méthode B : API Scraper ou API Browser (HTML uniquement) lorsque vous avez besoin du balisage brut — puis classez → dédupliquez → résolvez.
  • HTTP 200 ne constitue pas une SERP exploitable. Validez les conteneurs de résultats avant l’analyse.
  • Dédupliquez les /goto au sein d’une même page ; réutilisez les connexions ; limitez la concurrence.
  • Enregistrez une empreinte de la requête (requête, gl, hl, device, domaine, heure) avec chaque observation.
  • Le format des liens de Google n’est pas immuable. Privilégiez les URL directes, /goto, et /url.

Ce qu’est Google /goto est (et en quoi il diffère de /url )

/goto est (et en quoi il diffère de /url)

Historiquement, les robots de collecte lisaient souvent la destination directement à partir du lien ancré organique. Aujourd’hui, le même résultat conceptuel peut se présenter sous plusieurs formes :

Forme

Exemple de modèle

Que faire

Destination directe

https://example.com/page

Utiliser tel quel

/goto + CAES

https://www.google.com/goto?url=CAES...

Résoudre via GET → Location

/url un wrapper

https://www.google.com/url?...&url=CAES... ou des url= / q= variantes

Classer séparément ; résoudre ou analyser les paramètres avec soin

Autres hôtes/chemins d'accès Google

Maps, comptes, Chrome interne

Ignorer ou traiter en dehors du pipeline organique

/goto est un point de redirection hébergé par Google. La url valeur de la requête commence souvent par CAES— non pas parce que « CAES » est un nom de produit, mais parce que c’est ainsi qu’apparaît une enveloppe binaire courante après encodage Base64URL. L’ouverture du lien demande à Google une redirection vers la destination réelle.

/url Il s’agit d’un ancien chemin de redirection Google (encore utilisé). Certains clients recevraient apparemment /url un CAES charge utile au lieu d’une destination en texte clair. La règle de scraping reste la même dans les deux cas : classez le lien, puis conservez la destination directe ou résolvez l’enveloppe. Ne partez pas du principe que les jetons opaques n’apparaissent que sur /goto.

Google a décrit les couches de redirection comme faisant partie des mesures techniques visant à lutter contre l’évolution des abus sur la Recherche. La logique exacte de déploiement n’est pas un engagement public. Prévoyez plusieurs formats.

Avez-vous vraiment besoin de scraper du code HTML ?

La plupart des tâches de suivi de classement et de surveillance des SERP en production nécessitent les URL de destination + les titres + les extraits + les classements, et non le code HTML de présentation de Google. Choisissez d’abord le chemin d’accès au produit.

Piste A — API SERP (à privilégier lorsque les destinations sont au format JSON)

Envoyez une requête Google contextuelle au point de terminaison SERP de WebScrapingAPI et lisez les collections analysées :

  • Point de terminaison : https://serpapi.webscrapingapi.com/v2
  • Obligatoire : api_key, engine=google, q
  • Commandes facultatives courantes : device, domain, uule, hl, gl, start, num, tbm, ibp
  • Alternative asynchrone : engine=google_async, puis récupérez les résultats via l’API Snapshot

Pages produit : API SERP · API
de recherche Google Documentation : Accéder à l'API · Moteur de recherche Google

Ce que montrent aujourd’hui les documents publics : les exemples de résultats naturels utilisent link des champs qui ressemblent à des URL de destination finales (par exemple https://www.history.com/ ou https://en.wikipedia.org/wiki/History), et non des google.com/goto des conteneurs. La documentation relative aux champs décrit link comme étant l’URL de destination.

Vérifiez le link champ sur votre propre réponse en production :

  • Avant de vous fier uniquement au chemin A, examinez les link provenant d’un appel SERP daté sur votre compte.
  • La documentation publique présente des link ; seul votre propre échantillon peut vous indiquer si vos réponses en production en temps réel encadrent certains résultats dans /goto est une question que seul votre propre échantillon peut trancher — ne tirez aucune conclusion dans un sens ou dans l’autre à partir de cet article.

Notez également une double nomenclature dans le schéma de documentation : certaines pages affichent un organic tableau (link, display_link, rank), tandis que la documentation sur les résultats organiques indique organic_results (link, displayed_link, position). Les deux indiquent link comme destination. Effectuez une analyse prudente pour les deux formats et validez le résultat par rapport à une réponse réelle.

Piste B — API de scraping / API de navigateur HTML (lorsque vous devez analyser la page)

Utilisez le HTML lorsque vous avez besoin de sélecteurs personnalisés, d’une analyse de la mise en page ou d’un workflow que le moteur SERP structuré ne prend pas en charge :

  • API Scraper : https://api.webscrapingapi.com/v2 avec api_key + url
  • Set render_js=1 lorsque la cible nécessite du JavaScript côté client avant que vous ne receviez le corps de la page
  • API du navigateur : lorsque vous avez besoin de délais d’attente documentés, d’interactions ou de contrôles de l’état du navigateur

Vérifiez que la page de résultats de recherche (SERP) est exploitable. Une requête HTTP 200 peut toujours correspondre à une page interstitielle, une fenêtre de consentement, un CAPTCHA ou une invite « Activer JavaScript ». Avant d’extraire les liens, vérifiez qu’il existe des conteneurs de résultats identifiables (par exemple des ancres sous #rso / #searchou des marqueurs équivalents que vous utilisez). Si la validation échoue, réessayez avec le rendu, ajustez le contexte régional/appareil ou revenez à la solution A — ne stockez pas silencieusement des classements vides.

Après avoir extrait les /goto URL du code HTML, résolvez-les via HTTP standard (voir ci-dessous). En général, vous n’avez pas besoin d’un crédit de scraping supplémentaire par lien organique.

Comment résoudre /goto (code précoce)

/goto (code précoce)

La résolution est au cœur de la voie B — et constitue un filet de sécurité si un wrapper venait à apparaître dans la sortie structurée.

import requests

def resolve_google_goto(url: str, timeout: float = 10.0) -> str:
    """Resolve a Google /goto (or similar) redirect without following to the destination site."""
    response = requests.get(
        url,
        allow_redirects=False,
        timeout=timeout,
        headers={"User-Agent": "Mozilla/5.0"},
    )
    if response.status_code != 302:
        raise RuntimeError(f"Expected 302, got {response.status_code} for {url[:80]}...")
    location = response.headers.get("Location")
    if not location:
        raise RuntimeError("Redirect response has no Location header")
    return location  # keep full value, including #:~:text= fragments when present

Règles importantes en production :

  1. allow_redirects=False — vous voulez l’URL de Google Location, et non un deuxième saut vers l’éditeur.
  2. Préférez GET à HEAD. Des articles publiés indiquent que HEAD peut renvoyer 200 sans Location en-tête, tandis que GET renvoie 302 avec la destination. Considérez cela comme une recommandation générale ; vérifiez le comportement de HEAD par rapport à GET sur un /goto provenant de votre propre pipeline avant de coder en dur la méthode.
  3. Conservez Location tel quel. Google peut renvoyer des fragments de texte tels que #:~:text=.... Ne les supprimez que si votre produit nécessite explicitement des URL canoniques.
  4. Effectuez la résolution en dehors de l’API de scraping lorsque le jeton est portable : collectez les données via le HTML du scraper/navigateur, puis effectuez la résolution avec une session client normale.

Modèle cURL minimal :

curl -sS -o /dev/null -D - \
  "https://www.google.com/goto?url=CAES..." \
  | grep -i '^location:'

N’utilisez pas -L si vous n’avez besoin que de la cible de redirection.

Classez chaque href

href

Ne construisez jamais l’analyseur autour de la sous-chaîne CAES seule. Classez d'abord l'URL absolue :

from urllib.parse import parse_qs, urljoin, urlparse

GOOGLE_BASE_URL = "https://www.google.com/"

def is_google_host(host: str) -> bool:
    host = (host or "").lower()
    return host == "google.com" or host.endswith(".google.com")

def classify_google_link(href: str) -> tuple[str, str]:
    absolute = urljoin(GOOGLE_BASE_URL, href)
    parsed = urlparse(absolute)
    host = parsed.hostname or ""

    if is_google_host(host) and parsed.path == "/goto":
        token = parse_qs(parsed.query).get("url", [""])[0]
        if token.startswith("CAES"):
            return "goto", absolute
        return "goto", absolute  # still a /goto wrapper even if token shape changes

    if is_google_host(host) and parsed.path == "/url":
        return "google_url", absolute

    if parsed.scheme in {"http", "https"} and not is_google_host(host):
        return "direct", absolute

    return "other", absolute

Traitement suggéré :

Type

Action

direct

Conserver

goto

Dédupliquer → résoudre → conserver Location

google_url

Résoudre ou analyser les clés de requête connues ; ne pas supposer qu’il s’agit de texte en clair

other

Supprimer les sources organiques (ou les rediriger vers un gestionnaire distinct)

Pipeline de production : déduplication, concurrence, erreurs, empreinte

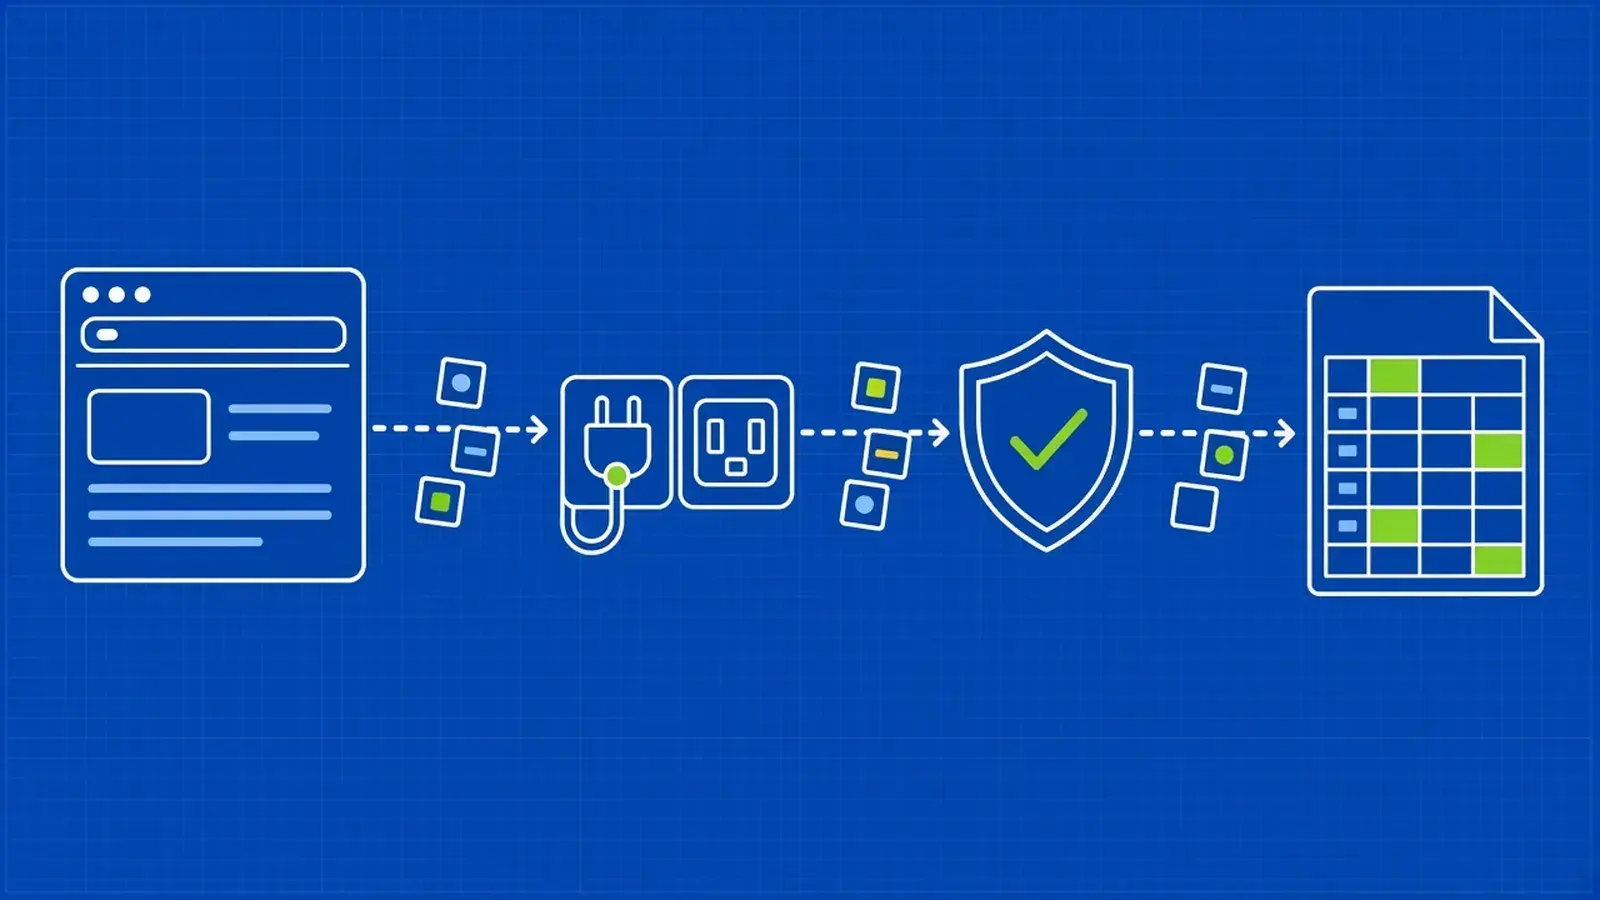
Pipeline HTML → URL :

SERP fetch (SERP API JSON or Scraper/Browser HTML)
        ↓
validate usable payload (JSON modules or SERP DOM)
        ↓
extract candidate hrefs / link fields
        ↓
classify → direct | goto | google_url | other
        ↓
dedupe wrappers (same token often repeats in one SERP)
        ↓
resolve with GET, bounded concurrency, connection reuse
        ↓
merge destinations + store request fingerprint + outcome codes

Dédupliquer avant la résolution

Une page de résultats de recherche (SERP) répète souvent le même /goto dans le titre et les ancres des liens vers le site. Résoudre chaque ancre gaspille des requêtes. Préserver l’ordre tout en garantissant l’unicité :

unique_goto_urls = list(dict.fromkeys(goto_urls))

Concurrence limitée et réutilisation des connexions

Utilisez un petit pool de workers et un seul requests.Session par worker afin de pouvoir réutiliser les connexions TCP/TLS. Le nombre exact de workers dépend de l’environnement : ajustez-le en fonction de votre latence et de vos taux d’erreur plutôt que de copier les chiffres de référence d’un autre fournisseur.

Taxonomie des erreurs (mettez-les en place)

Code / classe

Signification

Traitement recommandé

http_non_302

Statut inattendu provenant de /goto

Compteur ; URL d'exemple ; reculer si 429/5xx

missing_location

302 en l'absence de Location

Échec de ce résultat ; ne pas inventer d’URL

timeout / réseau

Transitoire

Réessayer avec un délai de réessai aléatoire

invalid_token

Échec persistant pour un jeton

Marquer comme échoué ; ne pas réessayer indéfiniment

serp_unusable

200 Le corps n'est pas un SERP

Corriger le chemin de récupération (render_js, choix de produit) avant l’analyse

wrapper_unresolved

/url chemin que vous ne gérez pas encore

Mettre en file d’attente pour révision ; ne pas supprimer silencieusement les classements sans indicateur

Enregistrer une empreinte de l’observation

Les données SERP comparables nécessitent un contexte en plus des URL :

  • q, gl, hl, device, domain, uule (le cas échéant), start, num, tbm/ibp
  • horodatage de l’observation et version du schéma
  • Chemin d’accès (serp_api par opposition à scraper_html vs browser_html)
  • Nombre : direct / goto / google_url / résolu / échec

Cela s’inscrit dans la lignée des recommandations de WebScrapingAPI en matière de données web responsables : préserver le contexte d’observation afin que les équipes en aval puissent interpréter chaque enregistrement.

Quand Google renvoie-t-il /goto ?

/goto?

Réponse courte : considérez cela comme une condition et non comme une règle fixe.

Des analyses de tiers (notamment l’étude approfondie de ScrapingBee de septembre 2026) ont signalé /goto dans Chrome et Edge utilisés manuellement, dans des sessions Playwright et dans du code HTML récupéré via des API de scraping, tandis que certains navigateurs axés sur la confidentialité affichaient toujours les destinations directes et que Safari les affichait parfois /url avec CAES. Il s’agit d’observations rapportées par des concurrents, et non de tests refaits par WebScrapingAPI, et elles ne constituent pas un engagement de la part de Google. Les changements d’adresse IP ou de pays seuls ont été jugés insuffisants pour forcer l’affichage de liens directs lors de ces tests — encore une fois, relativisez et ne tirez pas de conclusions hâtives.

Hypothèses de production sûres :

  • L’automatisation n’est pas le seul facteur déclencheur.
  • Le moteur de navigation à lui seul ne constitue pas un critère fiable.
  • La géolocalisation à elle seule n’est pas un critère fiable.
  • Votre scraper doit accepter les liens directs, /gotoet /url au fil du temps.

Si vous avez besoin d’une matrice de navigateurs pour vos propres besoins de conformité, effectuez un petit test interne sommaire et datez-le — ne publiez pas de règles non vérifiées comme s’il s’agissait de faits avérés.

Que contient un CAES jeton ? (courte annexe)

CAES jeton ? (courte annexe)

Cette section n’est pas indispensable pour livrer un scraper fonctionnel. Elle a pour but d’éviter que les équipes ne perdent du temps dans des impasses.

D’un point de vue général, les analyses du secteur décrivent :

  1. le décodage Base64URL du CAES... paramètre → binaire
  2. Une enveloppe compacte de type Protobuf (généralement un champ constant suivi d’un blob délimité par sa longueur)
  3. Une charge utile protégée dont les octets externes ressemblent au préfixe de sortie d’une bibliothèque cryptographique
  4. Aucune destination en texte clair récupérable à des fins pratiques de scraping

Politique de « résolution d’abord » : décodez par curiosité ou pour la recherche sur les logiciels malveillants si vous y tenez ; pour les produits SERP, appelez /goto et lisez Location. Tenter de décomposer le blob protégé revient à s’attaquer au mauvais problème.

Parcours de bout en bout A — API SERP

Python :

import os
import requests

api_key = os.environ["WSA_API_KEY"]

response = requests.get(
    "https://serpapi.webscrapingapi.com/v2",
    params={
        "api_key": api_key,
        "engine": "google",
        "q": "best trail shoes",
        "gl": "us",
        "hl": "en",
        "device": "mobile",
    },
    timeout=120,
)
response.raise_for_status()
payload = response.json()

# Docs may use organic or organic_results — support both.
organic = payload.get("organic") or payload.get("organic_results") or []

for row in organic:
    link = row.get("link")
    title = row.get("title")
    # Check link on your live response; if it looks like google.com/goto or /url, classify + resolve.
    print(title, "→", link)

Node.js :

const apiKey = process.env.WSA_API_KEY;
if (!apiKey) throw new Error("WSA_API_KEY is required");

const parameters = new URLSearchParams({
  api_key: apiKey,
  engine: "google",
  q: "best trail shoes",
  gl: "us",
  hl: "en",
  device: "mobile",
});

const response = await fetch(
  "https://serpapi.webscrapingapi.com/v2?" + parameters,
  { signal: AbortSignal.timeout(120_000) }
);
if (!response.ok) {
  throw new Error("Google Search API status " + response.status);
}
const payload = await response.json();
const organic = payload.organic || payload.organic_results || [];
for (const row of organic) {
  console.log(row.title, "→", row.link);
}

cURL :

: "${WSA_API_KEY:?WSA_API_KEY is required}"
curl --get --fail-with-body --max-time 120 \
  "https://serpapi.webscrapingapi.com/v2" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "engine=google" \
  --data-urlencode "q=best trail shoes" \
  --data-urlencode "gl=us" \
  --data-urlencode "hl=en" \
  --data-urlencode "device=mobile"

Pour les charges de travail mises en file d’attente, utilisez engine=google_async et le flux de récupération des instantanés documenté au lieu de bloquer le moteur synchrone.

Parcours de bout en bout B — HTML → classification → résolution

from __future__ import annotations

import os
import threading
from concurrent.futures import ThreadPoolExecutor
from urllib.parse import urlencode

import requests
from bs4 import BeautifulSoup

# reuse classify_google_link + resolve_google_goto from earlier sections

SCRAPER_API = "https://api.webscrapingapi.com/v2"
GOOGLE_SEARCH = "https://www.google.com/search"
_thread_local = threading.local()


def fetch_google_html(query: str, api_key: str) -> str:
    target = GOOGLE_SEARCH + "?" + urlencode({"q": query, "hl": "en"})
    response = requests.get(
        SCRAPER_API,
        params={
            "api_key": api_key,
            "url": target,
            "render_js": "1",  # enable when Google returns a JS shell instead of a SERP
        },
        timeout=120,
    )
    response.raise_for_status()
    return response.text


def assert_usable_serp(html: str) -> None:
    soup = BeautifulSoup(html, "html.parser")
    if not soup.select("#rso a[href], #search a[href]"):
        raise RuntimeError("No recognizable Google search results found (unusable SERP body)")


def extract_links(html: str) -> tuple[list[str], list[str], list[str]]:
    soup = BeautifulSoup(html, "html.parser")
    direct, goto, google_url = [], [], []
    for anchor in soup.select("#rso a[href], #search a[href]"):
        href = anchor.get("href") or ""
        kind, url = classify_google_link(href)
        if kind == "direct":
            direct.append(url)
        elif kind == "goto":
            goto.append(url)
        elif kind == "google_url":
            google_url.append(url)
    return direct, goto, google_url


def get_worker_session() -> requests.Session:
    session = getattr(_thread_local, "session", None)
    if session is None:
        session = requests.Session()
        _thread_local.session = session
    return session


def resolve_goto(url: str) -> tuple[str, str | None]:
    session = get_worker_session()
    try:
        response = session.get(url, allow_redirects=False, timeout=10)
    except requests.RequestException:
        return url, None
    if response.status_code != 302:
        return url, None
    return url, response.headers.get("Location")


def resolve_many(urls: list[str], workers: int = 5) -> dict[str, str]:
    unique_urls = list(dict.fromkeys(urls))
    with ThreadPoolExecutor(max_workers=workers) as executor:
        results = executor.map(resolve_goto, unique_urls)
    return {src: dest for src, dest in results if dest}


def main() -> None:
    api_key = os.environ["WSA_API_KEY"]
    html = fetch_google_html("best trail shoes", api_key)
    assert_usable_serp(html)

    direct, goto, google_url = extract_links(html)
    direct = list(dict.fromkeys(direct))
    goto = list(dict.fromkeys(goto))

    resolved = resolve_many(goto, workers=5)
    # Optionally add handlers for google_url wrappers here.

    destinations = list(dict.fromkeys(direct + list(resolved.values())))
    for url in destinations:
        print(url)

    # Persist fingerprint + counts in your store:
    # path=scraper_html, q, hl, render_js=1, n_direct, n_goto, n_resolved, n_failed


if __name__ == "__main__":
    main()

Installation : pip install requests beautifulsoup4. Conservez WSA_API_KEY dans l’environnement — ne le codez jamais en dur.

Utilisation responsable

Les URL publiques des SERP restent des données Web. Avant de lancer la collecte à grande échelle :

  1. Précisez l’objectif commercial (suivi du classement, visibilité des concurrents, recherche).
  2. Définissez le périmètre des sources publiques (domaines Google, marchés, appareils, exclusions).
  3. Conservez un minimum d’informations utiles — pas tous les champs affichés par Google.
  4. Désignez des responsables en aval pour la gestion des accès, la conservation des données et la prise de décisions.
  5. Préservez le contexte d’observation afin que les résultats restent interprétables.

Consultez la note opérationnelle de WebScrapingAPI : « Données Web responsables ». Votre équipe est responsable de l’objectif, de la portée des sources et de l’utilisation en aval ; WebScrapingAPI gère le chemin d’accès API sélectionné. Cet article ne constitue pas un avis juridique ni un guide visant à contourner les contrôles de sécurité : il s’agit d’un pipeline pratique de traitement des URL destiné à l’observation légitime des recherches publiques.

FAQ

Dois-je déchiffrer les CAES les jetons ?

CAES les jetons ?

Non. Pour le scraping et le suivi de classement, GET l’ /goto URL dont les redirections sont désactivées et lue Location. Le décodage local de Base64URL/protobuf ne donne pas de destination en texte clair exploitable.

Dois-je utiliser HEAD pour résoudre /goto ?

HEAD pour résoudre /goto?

Préférez-vous GET. Selon des rapports publics, HEAD peut renvoyer 200 sans Location alors que GET renvoie 302 avec la destination. Vérifiez la différence entre HEAD et GET sur un /goto provenant de votre propre pipeline avant de définir le comportement du client.

Quelle est la différence entre /goto et /url ?

/goto et /url?

Les deux sont des points de redirection Google pouvant s’intercaler entre la page de résultats de recherche (SERP) et la destination. /goto comporte généralement un CAES... url paramètre. /url est un wrapper de l'ancienne génération qui peut encore apparaître (parfois avec des jetons opaques). Classez les deux ; traitez ce que vous ne pouvez pas analyser comme une destination directe.

Dois-je utiliser l’API SERP ou extraire le code HTML de Google ?

Privilégiez l’API SERP de Google Search lorsque les résultats organiques structurés correspondent à votre schéma : moins de fragilité du code HTML, empreinte de requête plus claire. Utilisez l’API Scraper ou l’API Browser lorsque vous avez besoin d’un balisage brut ou d’une interaction personnalisée. Les exemples de la documentation présentent des link ; vérifiez le link champ de votre propre réponse en temps réel et notez la date avant de supposer que ce format fait partie du /goto déploiement de Google.

Les CAES les jetons ont-ils une date d’expiration ?

CAES les jetons ont-ils une date d’expiration ?

Des rapports de tiers suggèrent que les jetons peuvent rester valides pendant plus d’une journée et fonctionner au-delà de la session de navigation initiale. Leur durée de vie maximale est inconnue. Considérez-les comme des redirections temporaires opaques, et non comme des identifiants permanents. (Informations rapportées par des concurrents ; non vérifiées ici.)

Playwright (ou l’automatisation) est-il /goto ?

/goto?

Pas de manière fiable en tant que cause unique. Des tests signalés par un concurrent ont constaté /goto aussi bien dans Chrome en mode manuel que dans Chromium en mode automatisé. N’intégrez pas la règle « Playwright = /goto, Brave = direct » dans la logique de production.

Les jetons sont-ils liés aux cookies, à l’adresse IP ou à la session de scraping ?

Des rapports du secteur décrivent des jetons pouvant être collectés dans un environnement et résolus ultérieurement à l’aide d’un simple client HTTP. Utile pour séparer la récupération HTML de la résolution des redirections, mais cela ne constitue pas une garantie pour toutes les variantes futures de jetons. Mesurez les échecs.

Pourquoi Google utilise-t-il /goto ?

/goto?

Google a présenté les mesures relatives aux redirections comme faisant partie de la protection de son moteur de recherche contre l’évolution des abus. La logique exacte de sélection n’est pas entièrement publique. Du point de vue d’un scraper, les destinations ne sont plus toujours en texte clair dans le code HTML.

Que se passe-t-il si la réponse de mon API de scraper est 200 mais ne contient aucun lien organique ?

200 mais ne contient aucun lien organique ?

Considérez-la comme un corps de SERP inutilisable. Activez render_js=1 le cas échéant, vérifiez l’URL cible et les paramètres régionaux, ou passez à l’API SERP structurée. Ne vous fiez jamais aux codes d’état seuls.

Comment dois-je stocker les résultats pour pouvoir comparer les classements ?

Enregistrez les destinations avec l’empreinte de la requête (q, gl, hl, device, le domaine, les décalages, le chemin de récupération, l’horodatage). Cela correspond aux bonnes pratiques d’observation et évite les faux « changements de classement » causés par un mélange de paramètres régionaux ou d’appareils.

Étapes suivantes

  1. Appelez le moteur Google synchrone sur https://serpapi.webscrapingapi.com/v2 avec api_key, engine=google, puis q.
  2. Inspectez les link à partir d'une réponse en temps réel de votre compte et notez la date.
  3. Si vous restez en HTML, effectuez les étapes suivantes : classification → déduplication → résolution avant d’augmenter le volume de mots-clés.
  4. Passez en revue les données Web pertinentes avec vos responsables des données.

Commencez par l’API de recherche Google, comparez les moteurs de l’API SERP ou récupérez le code HTML des pages via l’API Scraper / l’API Browser lorsque les résultats structurés ne suffisent pas.

À propos de l'auteur

Suciu Dan, cofondateur @ WebScrapingAPI

Suciu Dan

cofondateur

Suciu Dan est le cofondateur de WebScrapingAPI et rédige des guides pratiques destinés aux développeurs sur le web scraping avec Python et Ruby, ainsi que sur les infrastructures de proxy.

Tutoriel Python Nodriver : extraction de données de navigateur en mode furtif, du premier script à la mise en production
Les techniques de web scraping

Tutoriel Python Nodriver : extraction de données de navigateur en mode furtif, du premier script à la mise en production

TL;DR: En bref : Nodriver est une bibliothèque Python asynchrone qui pilote Chromium via le Chrome DevTools Protocol, sans Selenium ni binaire chromedriver. Utilisez-la lorsqu'un navigateur furtif auto-hébergé, plus proche d'une vraie session Chrome, convient mieux qu'une pile WebDriver, mais sachez qu'elle ne supprime pas à elle seule les risques liés à l'IP, au TLS ou au comportement. Ce tutoriel va d'un premier script à la production en conteneur et à une Browser API hébergée.

Suciu Dan16 min read
Lire l'article
En-têtes de réponse HTTP dans cURL : Tous les drapeaux, techniques et recettes de script
Les techniques de web scraping

En-têtes de réponse HTTP dans cURL : Tous les drapeaux, techniques et recettes de script

TL;DR: cURL cache les en-têtes de réponse par défaut. Utilisez -i pour voir les en-têtes avec le corps, -I pour une requête HEAD qui ne renvoie que les en-têtes, -v pour un débogage complet de la requête/réponse, et -D pour enregistrer les en-têtes dans un fichier. Pour les scripts modernes, cURL 7.83+ vous permet d'extraire des en-têtes individuels ou de les récupérer tous en JSON avec l'option -w write-out.

Suciu Dan13 min read
Lire l'article
Qu'est-ce qu'un navigateur sans tête ? Architecture, cas d'utilisation et principaux outils
Les techniques de web scraping

Qu'est-ce qu'un navigateur sans tête ? Architecture, cas d'utilisation et principaux outils

TL;DR: Un navigateur sans tête est un navigateur web qui fonctionne sans interface graphique visible, entièrement contrôlé par du code ou des instructions en ligne de commande. Les développeurs utilisent les navigateurs headless pour les tests automatisés, le web scraping, le contrôle des performances et, de plus en plus, pour alimenter les agents d'intelligence artificielle. Ce guide explique comment ils fonctionnent en interne, quand les choisir plutôt qu'un navigateur classique, et quels sont les frameworks qui valent la peine d'être utilisés.

Suciu Dan16 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.