Aller au contenu
Retour au blog

Avantages de l'API de web scraping : ce que vous externalisez réellement

Anda MiuțescuDernière mise à jour le 16 min read
Avantages de l'API de web scraping : ce que vous externalisez réellement
En bref : une API de web scraping permet, selon le service, de décharger votre application de tâches telles que la récupération de données, la gestion des proxys ou l'exécution dans un navigateur. L'extraction structurée est une fonctionnalité distincte, et ni une requête aboutie ni un JSON valide ne garantissent que les données seront exploitables. Évaluez les responsabilités que vous délestez, les enregistrements que vous acceptez et les tâches de récupération qui vous incombent toujours.

Une API de web scraping est une interface de service par laquelle votre application demande le contenu d’une page web ou des données extraites. Son principal avantage réside dans un transfert de responsabilité opérationnelle : votre équipe peut utiliser un service défini au lieu de gérer chaque composant chargé de récupérer la page.

Prenons l’exemple d’une tâche quotidienne de catalogage. Hier, elle récupérait toutes les pages, mais aujourd’hui, elle passe son temps à redémarrer les navigateurs. L’achat d’un service d’extraction pourrait aider, mais uniquement s’il prend en charge la responsabilité défaillante. Un service qui renvoie du HTML brut vous laisse toujours la charge d’extraire les champs. Une réponse structurée nécessite toujours des vérifications pour s’assurer de l’exactitude du produit, de la devise et de l’heure d’observation.

Ce guide explique les avantages des API de web scraping sans considérer une API comme une plateforme de données à part entière. Vous découvrirez quelles tâches peuvent être confiées à un fournisseur, lesquelles restent du ressort de votre application, et comment évaluer si ce changement en vaut la peine. Les exemples fournis constituent des conseils d’architecture et ne constituent ni des comparatifs entre fournisseurs, ni une affirmation selon laquelle tous les services offrent les mêmes fonctionnalités.

Mettre en correspondance les avantages des API de web scraping et les responsabilités

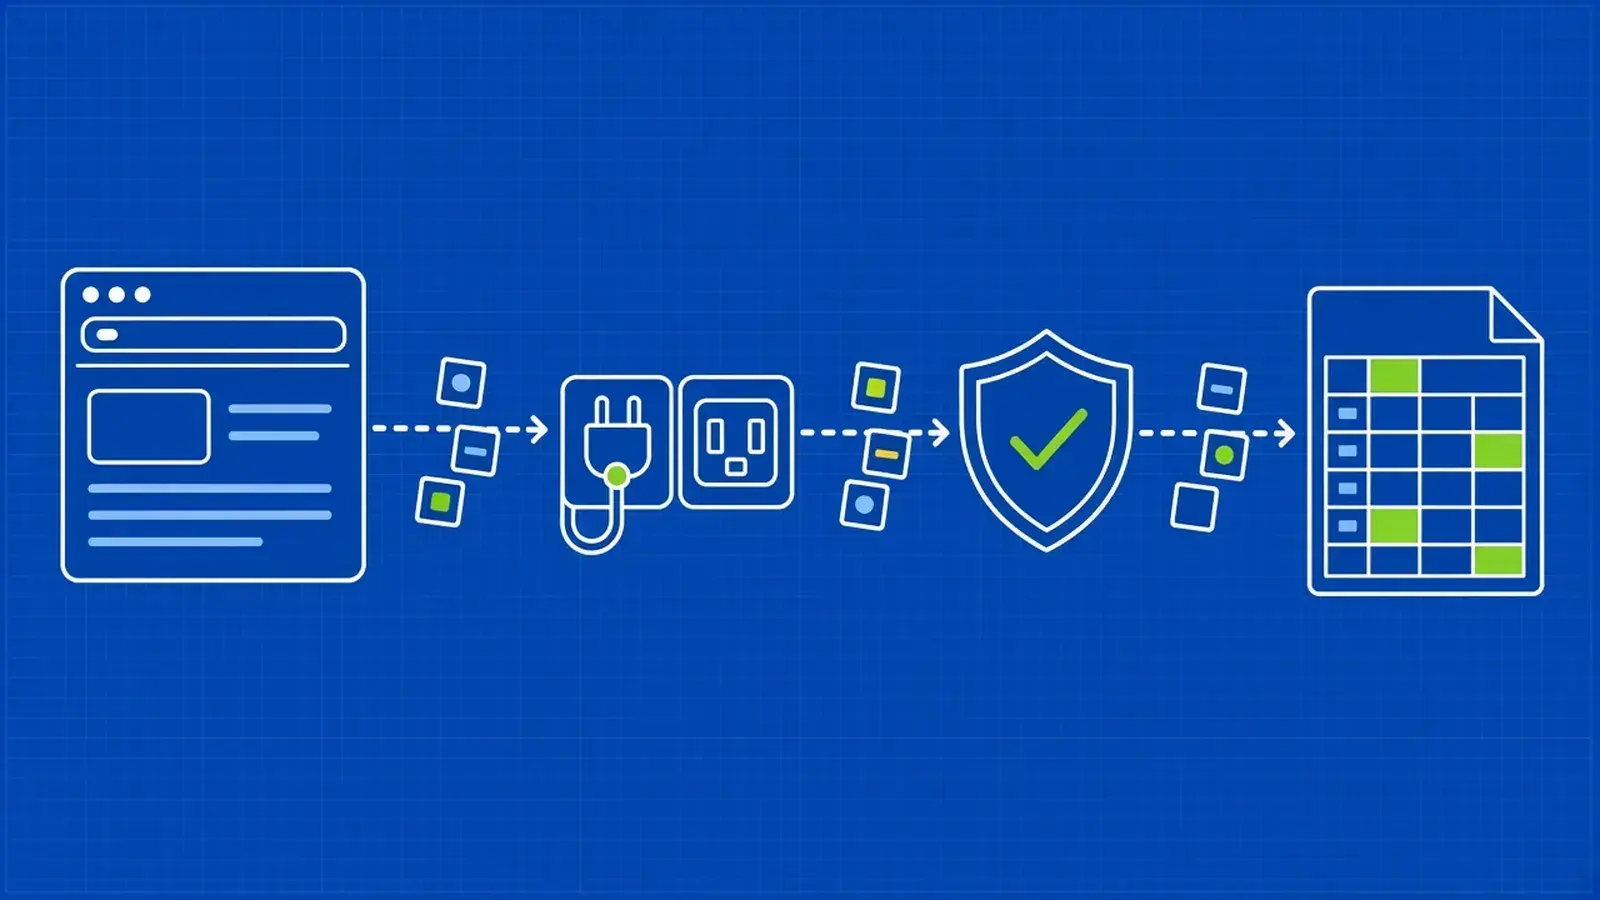
Commencez par définir clairement ce que le service promet réellement. La récupération (fetching) consiste à extraire une représentation d’une page. Le rendu (rendering) consiste à exécuter un environnement de navigateur pour obtenir le contenu affecté par les scripts et les interactions. L’extraction transforme le contenu source en champs. Un pipeline de production planifie le travail, valide les résultats, gère l’état et fournit les enregistrements aux consommateurs.

Ces responsabilités peuvent être regroupées, mais elles ne sont pas synonymes. Un point de terminaison de requête géré peut renvoyer du code HTML sans extraire de champs. Un service de navigateur peut vous permettre d’exécuter des interactions sans déterminer quels éléments doivent figurer dans votre jeu de données. Une API d’extraction peut reconnaître un type d’enregistrement pris en charge sans mettre en œuvre vos règles d’acceptation métier.

Responsabilité

Avantage potentiel de l’API

Responsabilité de vérification ou de conservation

Récupération HTTP

Infrastructure de requêtes gérée

Cibles approuvées et validation des réponses

Exécution dans le navigateur

Réduction des tâches liées à l’hébergement et au cycle de vie des navigateurs

Interactions requises et critères de réussite

Extraction de champs

Sortie structurée prise en charge

Signification, exhaustivité et compatibilité avec le schéma

Récupération

Erreurs documentées ou nouvelles tentatives côté service

Délais d'exécution des tâches, déduplication, politique de relecture

Livraison

Exportations facultatives ou intégrations de stockage

Contrats clients et politique de conservation

Utilisez ce tableau comme liste de contrôle pour vos achats. Indiquez pour chaque fonctionnalité si elle est incluse, facultative, non prise en charge ou inconnue. Attribuez ensuite un responsable à chaque tâche restante. Il vaut mieux indiquer explicitement ce que l’on ignore plutôt que de se baser sur un schéma qui suppose tacitement que le fournisseur gère tout, de l’URL au tableau de bord.

Cette délimitation garantit également l’honnêteté d’une période d’essai. Comparez un outil de collecte géré au travail de collecte qu’il remplace, et non à une plateforme d’analyse complète gérée manuellement. Comparez une plateforme plus complète à l’ensemble de ses responsabilités, y compris les nouvelles contraintes qu’elle introduit.

Réduisez les opérations de récupération et de navigation là où elles constituent un frein

Le premier avantage pratique réside dans la réduction du nombre de composants que votre équipe doit gérer. Selon le produit, un fournisseur peut gérer le routage des requêtes, la capacité du navigateur ou l’environnement qui exécute les interactions avec les pages. Votre application fait appel à une frontière de service au lieu de devoir provisionner et diagnostiquer elle-même chaque composant sous-jacent.

Le rendu en est un bon exemple. La documentation sur l’automatisation du navigateur d’un service géré décrit les requêtes et actions spécifiques au navigateur séparément de la récupération HTTP classique. Cette distinction est importante, car récupérer le corps d’une réponse et observer une page après l’exécution de scripts sont des opérations différentes. La prise en charge du navigateur par un fournisseur doit être évaluée par rapport à vos interactions réelles, et non déduite d’une simple affirmation selon laquelle il gère JavaScript.

Identifiez la condition d’achèvement pour chaque type de page. L’apparition du titre d’un produit peut suffire à un collecteur ; un autre devra attendre une interaction autorisée avec un filtre et le remplissage d’un tableau. Une mise en veille arbitrairement longue ne constitue pas un contrat d’acceptation. Vérifiez si le service est capable d’exprimer et de signaler la condition requise par votre flux de travail.

Veillez à ce que les pages légères restent légères. Si le contenu nécessaire figure déjà dans la réponse initiale, l’exécution dans le navigateur peut ajouter une charge de travail sans apporter d’informations supplémentaires. Notre comparaison des clients HTTP Python pour le web scraping est utile lorsqu’un client classique reste suffisant pour une partie de la charge de travail.

Les opérations gérées sont particulièrement utiles lorsqu’elles éliminent une charge récurrente que vous pouvez identifier. Notez cette charge avant la phase d’essai : échecs de lancement du navigateur, maintenance de l’infrastructure ou incidents de routage des requêtes. Par la suite, vérifiez si elle a réellement diminué ou si elle s’est simplement déplacée vers des tickets d’assistance moins visibles.

Obtenez un résultat structuré sans le confondre avec la réalité

Une API d’extraction structurée peut réduire la quantité d’analyse spécifique à chaque site que vous devez gérer. C’est un réel avantage lorsque les types d’enregistrements pris en charge correspondent à votre tâche. Par exemple, la documentation relative à l’extraction automatique décrit des types structurés pour les produits, les articles et les offres d’emploi, avec des contrôles sur la source utilisée pour l’extraction. Il s’agit d’une fonctionnalité documentée du produit, et non d’une garantie d’exactitude pour chaque page.

Définissez votre propre schéma d’acceptation avant d’en tester un. Pour une observation de catalogue, exigez un identifiant de source, une URL de source canonique, un horodatage d’observation, une devise et les champs nécessaires au calcul en aval. Déterminez quelles valeurs manquantes sont acceptables et lesquelles doivent entraîner la mise en quarantaine de l’enregistrement. Un objet syntaxiquement valide peut tout de même décrire la mauvaise variante.

Faites la distinction entre les observations brutes et les valeurs métier normalisées. Un prix affiché peut inclure une fourchette, une remise ou un format décimal dépendant des paramètres régionaux. Si vous le normalisez, conservez suffisamment d’informations sur la provenance pour expliquer la transformation. Ne remplacez pas tacitement un prix absent par zéro ni une mention de disponibilité manquante par une affirmation positive.

Le même principe s’applique si vous conservez votre propre analyseur syntaxique. La documentation de Scrapy sur le pipeline d’éléments traite la validation, le nettoyage et la persistance comme des responsabilités explicites du traitement. Le fait de confier la récupération à une API ne fait pas disparaître ces responsabilités ; cela modifie simplement la provenance de leurs données d’entrée.

Ajoutez des tests de régression pour les variations importantes des pages. Lorsque la sortie change, déterminez si la source a changé, si le fournisseur a modifié son comportement d’extraction ou si c’est votre propre normalisation qui a changé. La séparation de ces couches permet d’enquêter sans déclarer l’ensemble du pipeline non fiable ni accepter une erreur de données subtile sous prétexte que la réponse semblait bien formée.

Utilisez les erreurs de service pour mettre en place une récupération délimitée

Un contrat d’erreur documenté peut être plus facile à intégrer qu’un ensemble d’exceptions de bas niveau, mais vous avez tout de même besoin d’une politique de récupération. Distinguez les entrées non valides, les échecs d’authentification, la limitation du débit par le fournisseur, les réponses de la source et les échecs d’extraction. Chacun de ces cas nécessite des actions différentes. Répéter une requête non valide avec la même charge utile n’est pas de la résilience.

Les API gérées peuvent exposer leur propre état et décrire également le résultat attendu. Consultez ces deux niveaux lorsqu’ils sont disponibles. Notre guide de dépannage des erreurs de proxy explique le problème général consistant à attribuer un échec à l’étape correcte. La même rigueur s’applique lorsque l’intermédiaire est une API plutôt qu’un proxy configuré.

La documentation du fournisseur doit préciser quelles erreurs peuvent faire l’objet d’une nouvelle tentative. Par exemple, le guide de gestion des erreurs d’un service géré distingue la limitation de débit des requêtes infructueuses et documente le comportement de recul (backoff). Votre application doit néanmoins imposer un délai métier et des limites de dépenses pour l’ensemble de la tâche. Une requête qui pourrait finalement aboutir peut perdre toute valeur une fois son délai d’exécution écoulé.

Conservez l’état d’avancement du travail indépendamment du processus qui l’exécute. Enregistrez les résultats suivants : en file d’attente, tenté, accepté, mis en quarantaine et échec définitif. Utilisez des identifiants de travail stables afin que la relecture puisse mettre à jour ou dédupliquer les enregistrements plutôt que d’ajouter des doublons. Une réponse d’API ne prouve pas que l’écriture dans votre base de données s’est achevée avant le plantage d’un worker.

Testez la récupération de manière ciblée à l’aide de fixtures ou d’un environnement de test contrôlé. Interrompez un worker après réception d’une réponse, mais avant d’accuser réception de la tâche. Vérifiez que la nouvelle tentative aboutit à un résultat métier accepté. L’avantage opérationnel ne réside pas dans la disparition des échecs, mais dans le fait que la délimitation du service offre à votre équipe un ensemble plus restreint et documenté d’échecs à gérer.

Évoluez dans des limites définies plutôt que de partir du principe d’un débit illimité

Un service peut réduire la charge de travail liée à la gestion de la capacité sans pour autant fournir une capacité illimitée. Vérifiez les limites de débit, les limites de tâches simultanées, les limites de taille de réponse, les délais de requête et toutes les restrictions qui varient selon la cible ou la fonctionnalité. Ces limites affectent à la fois le débit et le comportement de votre planificateur.

Par exemple, la documentation sur les limites de débit d’un service décrit des limites liées aux comptes et aux sites web. Cela illustre pourquoi la limite par compte n’est pas la seule contrainte qui compte. Ne généralisez pas les unités ou les limites d’un seul fournisseur à toutes les API.

Utilisez une file d’attente pour lisser les pics de trafic et un pool de travailleurs limité pour empêcher votre propre système de lancer des tâches ingérables. Séparez les sources ayant des budgets différents afin qu’une source lente ne monopolise pas tous les travailleurs. Propagez la contre-pression provenant du stockage et de la validation plutôt que de continuer à récupérer des données qui ne peuvent pas être acceptées.

Mesurez le délai jusqu’à l’acceptation des données, et pas seulement la latence des requêtes. Une réponse rapide suivie d’un long retard de validation entraîne le même dépassement de délai qu’une réponse lente. Surveillez la tâche en attente la plus ancienne et l’ancienneté des observations acceptées. Ces indicateurs relient le comportement de l’infrastructure à l’objectif réel de la tâche de collecte.

Notre guide sur le web scraping automatisé traite des tâches récupérables comme un flux de travail complet. Une API peut simplifier une étape de ce flux de travail. Elle ne remplace toutefois pas la nécessité de planifier correctement, de respecter les restrictions des sources ou d’arrêter la collecte lorsque le consommateur en aval n’est pas disponible.

Comparez les aspects économiques à l’aide des enregistrements acceptés

Les avantages d’une API de scraping Web incluent souvent une charge de maintenance réduite, mais il s’agit d’une hypothèse à vérifier plutôt que d’une économie automatique. Un petit collecteur ciblant des pages stables et autorisées peut rester moins coûteux et plus simple à gérer avec un client classique. En revanche, une charge de travail impliquant une maintenance récurrente du navigateur peut tirer un bien plus grand profit d’une exécution gérée.

Choisissez une période de référence et définissez ce qu’est un enregistrement valide : unique, conforme au schéma, correct d’un point de vue contextuel et livré avant la date limite. Comparez ensuite la facture du fournisseur, l’infrastructure restante et le travail d’ingénierie supplémentaire au nombre d’enregistrements valides. Utilisez la même définition pour votre système actuel et pour la période d’essai.

Prenez en compte les effets des nouvelles tentatives, du rendu optionnel, de l’extraction structurée, des travaux en double et des engagements minimaux dans le cadre des conditions commerciales actuelles. Un prix unitaire de requête bas n’a pas de sens si les fonctionnalités dont vous avez besoin utilisent une unité de facturation différente. À l’inverse, un prix unitaire de requête plus élevé peut être raisonnable s’il permet d’éliminer une charge de travail opérationnelle importante.

N’attribuez pas de valeurs monétaires fictives à chaque inconvénient. Suivez, dans la mesure du possible, le temps réel consacré aux tâches récurrentes et indiquez clairement qu’il s’agit d’estimations. Distinguez les travaux de migration ponctuels des opérations récurrentes afin que l’évaluation ne masque pas l’investissement initial ou ne le facture pas indéfiniment.

Privilégiez un résultat au niveau de la charge de travail plutôt qu’une moyenne globale. Les pages statiques, les pages interactives et les formats non pris en charge peuvent donner des résultats différents. Une architecture hybride peut s’avérer la solution la plus judicieuse : des clients classiques pour les sources simples et un service géré pour le sous-ensemble qui en tire avantage. La complexité supplémentaire liée au routage et à l’assistance doit également être prise en compte dans cette comparaison.

Précisez clairement la gouvernance des données et la responsabilité de leur diffusion

Une API ajoute une organisation supplémentaire au chemin d’accès aux données. Vérifiez ce que vous envoyez : URL, en-têtes, cookies, corps de requêtes et tout contenu source soumis en vue d’une extraction. Utilisez des identifiants de service côté serveur et ne les conservez pas dans des référentiels publics, des paquets de navigateur ni des captures d’écran de diagnostic.

Renseignez-vous sur la durée de conservation, les contrôles d’accès, les lieux de traitement et les sous-traitants pour le produit sélectionné. Si le flux de travail inclut des données privées ou réglementées, faites intervenir les responsables internes compétents avant toute phase d’essai. Commencez par des données non sensibles lorsque cela est possible. Évitez de supposer qu’une intégration technique réussie vaut à elle seule validation par l’organisation.

L’autorisation de collecte reste de votre responsabilité. Privilégiez une API source autorisée ou un flux sous licence lorsque cela répond aux exigences. Respectez les instructions publiées relatives aux robots d’indexation et le périmètre d’accès convenu. Le protocole d’exclusion des robots (Robots Exclusion Protocol) stipule que les règles relatives aux robots d’indexation ne constituent pas une autorisation d’accès ; la gestion des robots ne doit donc pas être considérée comme une décision d’autorisation complète.

Les fonctionnalités de livraison doivent également être examinées. Une plateforme peut proposer un ensemble de données ou une interface d’exportation ; par exemple, la documentation relative à l’ensemble de données décrit le stockage des enregistrements structurés et les moyens de les récupérer. Cela ne définit pas pour autant votre politique de conservation, votre schéma de consommation ni vos garanties de récupération. Vérifiez le comportement d’exportation, les autorisations d’accès et la procédure de transfert des données avant d’intégrer ce service au cœur de votre pipeline.

Désignez un responsable pour la suppression, le traitement des réclamations et la révocation des identifiants. Ces éléments apparaissent rarement dans un exemple de démarrage rapide, mais une tâche de production automatisée en a autant besoin qu’elle a besoin d’une fonction de requête.

Menez un projet pilote avec un contrat de sortie

Choisissez une charge de travail représentative et une période d’évaluation courte et convenue. Enregistrez la charge de maintenance du système existant et le résultat des enregistrements acceptés en utilisant les mêmes mesures que celles que vous appliquerez à l’API. Maintenez le budget des requêtes source fixe afin que le projet pilote ne génère pas de charge supplémentaire involontaire.

Créez un adaptateur spécifique entre votre application et le service. Mappez la réponse du fournisseur dans votre format d’observation interne avant la validation métier. Conservez les métadonnées du fournisseur à des fins de diagnostic, mais ne faites pas en sorte que chaque consommateur dépende de champs de réponse accessoires. Gérez les versions du mappage afin que les modifications puissent être vérifiées.

Déterminez ce qui se passera si le service devient indisponible ou n’est plus adapté. Votre contrat de sortie doit identifier les enregistrements exportables, la configuration conservée, les règles d’extraction portables le cas échéant, ainsi que le travail qui devra être refait. Toutes les fonctionnalités ne sont pas portables ; consignez par écrit la partie non portable au lieu de la dissimuler derrière une abstraction.

À la fin de la phase pilote, examinez les enregistrements rejetés avec autant de soin que ceux qui ont été acceptés. Un fournisseur qui élimine discrètement les pages difficiles peut paraître excellent si le dénominateur ne comprend que les résultats renvoyés. Comptez le travail initialement prévu et expliquez chaque catégorie de résultats.

Ne préconisez l’intégration que si les avantages opérationnels, la qualité des données et les conditions commerciales répondent aux critères prédéfinis. Dans le cas contraire, conservez les preuves et réajustez les limites que vous envisagez. Une phase pilote bien menée qui rejette un service inadapté a tout de même permis d’éviter une décision architecturale coûteuse.

Points clés à retenir

  • Considérez la récupération, l’exécution dans le navigateur, l’extraction et les opérations de pipeline comme des responsabilités distinctes.
  • Vérifiez la pertinence et l’actualité des enregistrements, même lorsqu’une API renvoie correctement des données structurées.
  • Prévoyez dans le contrat d’application la persistance de l’état de travail, une récupération limitée et la déduplication.
  • Évaluez le coût par enregistrement accepté, ainsi que l’effort de maintenance et les délais de livraison.
  • Examinez le chemin des données et testez un plan de sortie avant de faire d’un fournisseur une dépendance en production.

FAQ

Une API de scraping peut-elle être utilisée depuis un workflow de feuille de calcul ?

Oui, si l’intégration environnante est capable d’effectuer des requêtes authentifiées et de transformer la réponse en lignes requises. Conservez les identifiants dans un connecteur approuvé ou un composant côté serveur plutôt que de les diffuser dans une feuille partagée. Déterminez comment les mises à jour identifient les lignes existantes, car l’ajout répété de la même observation peut générer des totaux trompeurs, même si chaque requête aboutit.

Des champs manquants doivent-ils bloquer l’ensemble du jeu de données ?

Pas nécessairement. Classez les champs en fonction des exigences de l’application consommatrice. Une description facultative manquante peut être acceptable, tandis qu’un identifiant manquant peut empêcher une déduplication sûre. Séparez les enregistrements rejetés ou incomplets en indiquant explicitement les raisons. Évitez d’établir une règle générale qui écarterait des observations utiles ou intégrerait des enregistrements incomplets dans des calculs supposant que tous les champs sont présents.

Les pages sources historiques peuvent-elles être reconstituées à partir des résultats actuels de l’API ?

En général, pas à partir des seuls résultats actuels. Une nouvelle récupération décrit ce qui était observable à ce moment-là, et non tous les états antérieurs de la page. Si des comparaisons historiques sont nécessaires, définissez une stratégie d’observation et de conservation autorisées avant le début de la collecte. Stockez les horodatages et la provenance avec les enregistrements, et évitez de présenter des observations ultérieures comme preuve de ce qu’une source affichait auparavant.

Conclusion

Les principaux avantages des API de web scraping proviennent du transfert d’une charge opérationnelle clairement définie vers un service qui la gère efficacement pour votre charge de travail. La récupération gérée peut réduire la charge réseau. Les navigateurs gérés peuvent réduire la maintenance liée à l’exécution. L’extraction structurée peut réduire le travail d’analyse syntaxique. Il s’agit là d’avantages distincts, et chacun mérite son propre test d’acceptation.

Gardez les responsabilités restantes bien en vue. Votre application doit toujours savoir ce qu’elle avait l’intention de collecter, quels résultats sont valides, à quel moment les données deviennent obsolètes et comment le travail inachevé est récupéré. La gouvernance, les contrats avec les utilisateurs et une stratégie de sortie doivent être intégrés à la conception dès le départ, et non après la première requête réussie.

Menez un projet pilote restreint avec des pages représentatives, un budget limité et une définition commune des données acceptées. Utilisez les résultats pour décider s’il faut externaliser davantage, conserver un client léger ou combiner les deux approches. Si la récupération gérée correspond à la responsabilité que vous souhaitez déléguer, évaluez l’API Scraper de WebScrapingAPI par rapport à ce même contrat avant d’étendre l’intégration.

À propos de l'auteur

Anda Miuțescu, Rédacteur de contenu technique @ WebScrapingAPI

Anda Miuțescu

Rédacteur de contenu technique

Anda Miuțescu est rédactrice de contenu technique chez WebScrapingAPI ; elle rédige des articles clairs et utiles qui aident les développeurs à comprendre le produit et ses fonctionnalités.

Tutoriel Python Nodriver : extraction de données de navigateur en mode furtif, du premier script à la mise en production
Les techniques de web scraping

Tutoriel Python Nodriver : extraction de données de navigateur en mode furtif, du premier script à la mise en production

TL;DR: En bref : Nodriver est une bibliothèque Python asynchrone qui pilote Chromium via le Chrome DevTools Protocol, sans Selenium ni binaire chromedriver. Utilisez-la lorsqu'un navigateur furtif auto-hébergé, plus proche d'une vraie session Chrome, convient mieux qu'une pile WebDriver, mais sachez qu'elle ne supprime pas à elle seule les risques liés à l'IP, au TLS ou au comportement. Ce tutoriel va d'un premier script à la production en conteneur et à une Browser API hébergée.

Suciu Dan16 min read
Lire l'article
Comment gérer les URL de redirection Google /goto et les jetons CAES dans un outil de collecte de données SERP
Les techniques de web scraping

Comment gérer les URL de redirection Google /goto et les jetons CAES dans un outil de collecte de données SERP

TL;DR: En bref : Les URL Google /goto avec un jeton CAES, ainsi que les anciens wrappers /url, sont des couches de redirection, pas des destinations : un scraper de SERP qui traite chaque href comme final fausse le suivi de positions et les bases de liens. Préférez une API SERP structurée lorsqu'elle renvoie les liens de destination. Si vous devez analyser le HTML, classez chaque href, dédoublonnez les redirections et résolvez-les avec un simple GET. Ne déchiffrez pas CAES.

Suciu Dan14 min read
Lire l'article
En-têtes de réponse HTTP dans cURL : Tous les drapeaux, techniques et recettes de script
Les techniques de web scraping

En-têtes de réponse HTTP dans cURL : Tous les drapeaux, techniques et recettes de script

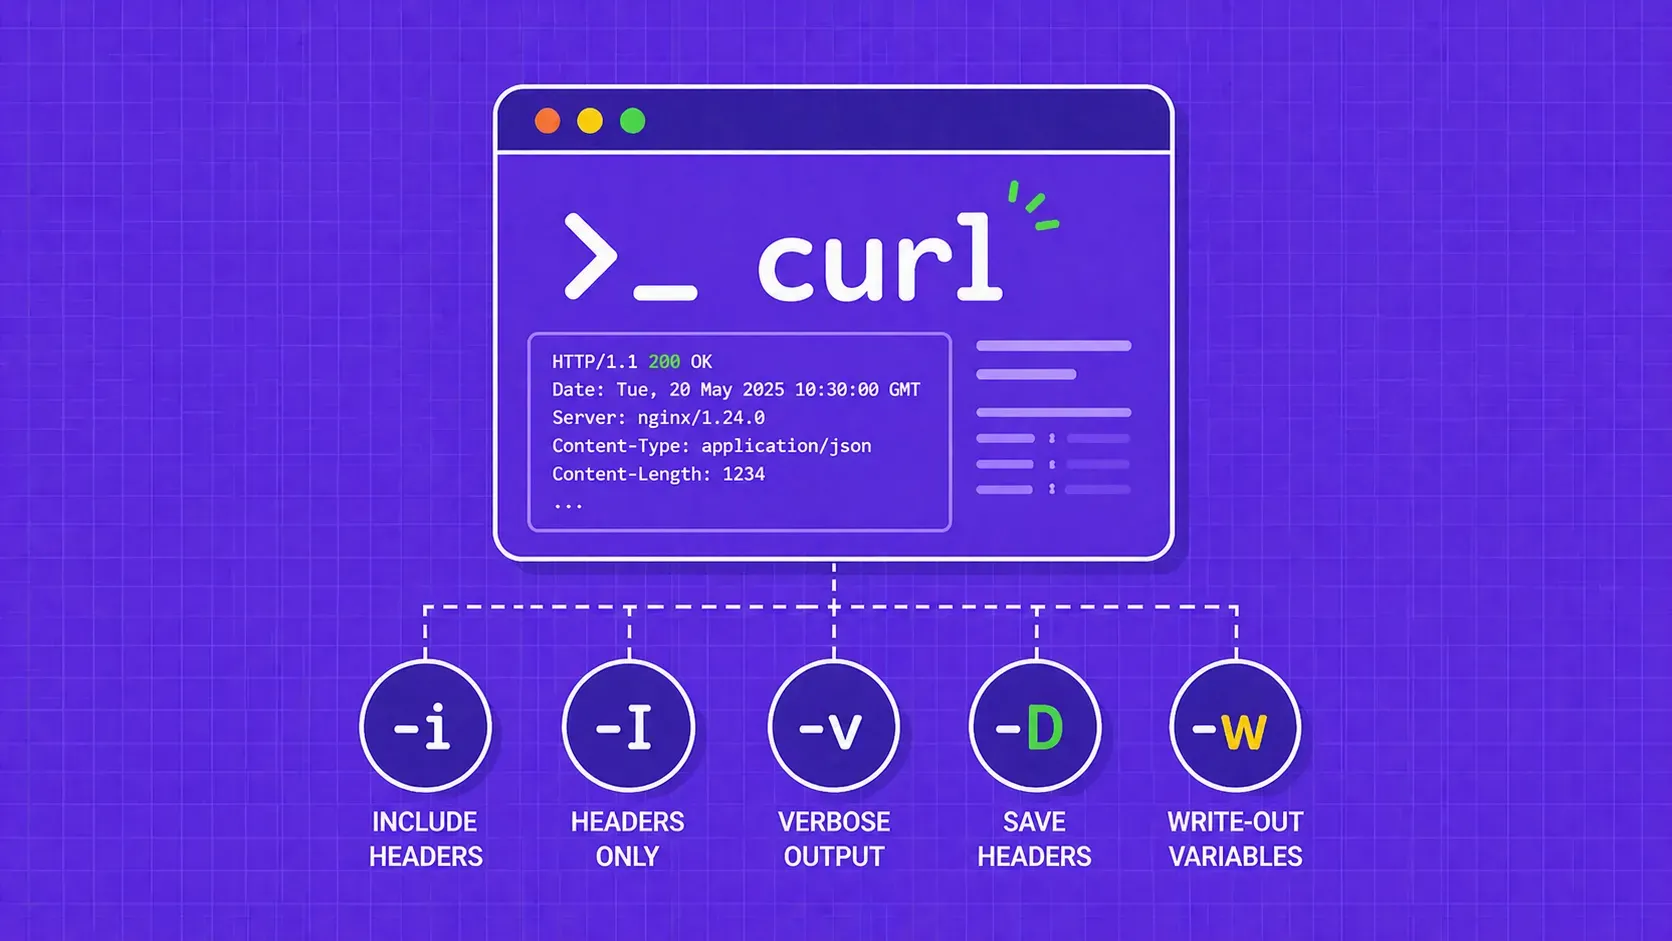
TL;DR: cURL cache les en-têtes de réponse par défaut. Utilisez -i pour voir les en-têtes avec le corps, -I pour une requête HEAD qui ne renvoie que les en-têtes, -v pour un débogage complet de la requête/réponse, et -D pour enregistrer les en-têtes dans un fichier. Pour les scripts modernes, cURL 7.83+ vous permet d'extraire des en-têtes individuels ou de les récupérer tous en JSON avec l'option -w write-out.

Suciu Dan13 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.