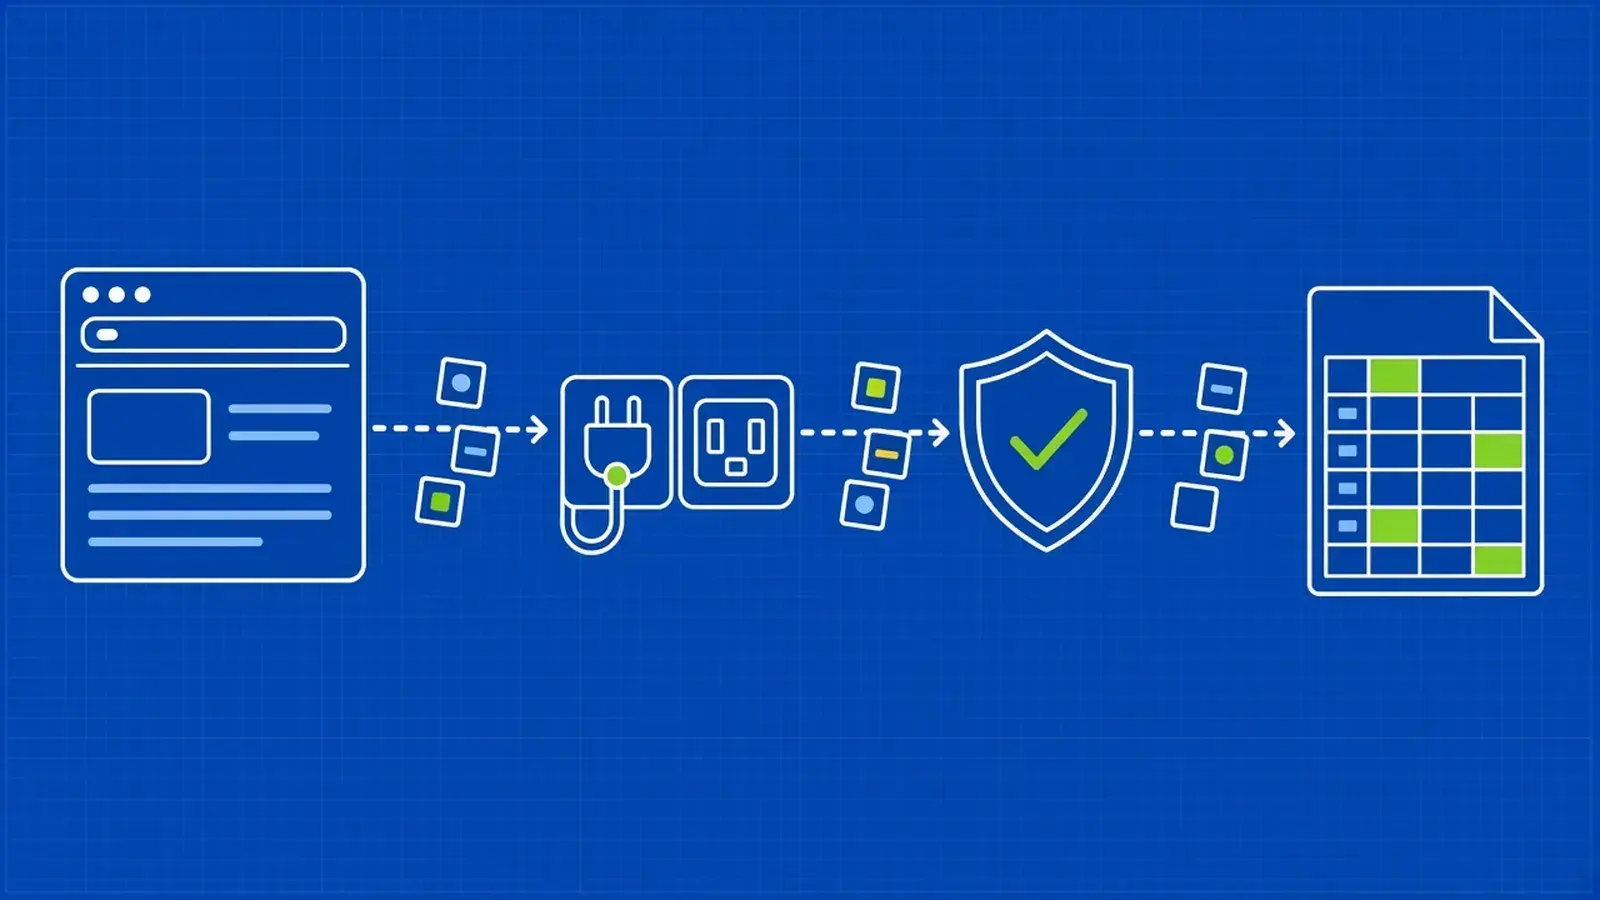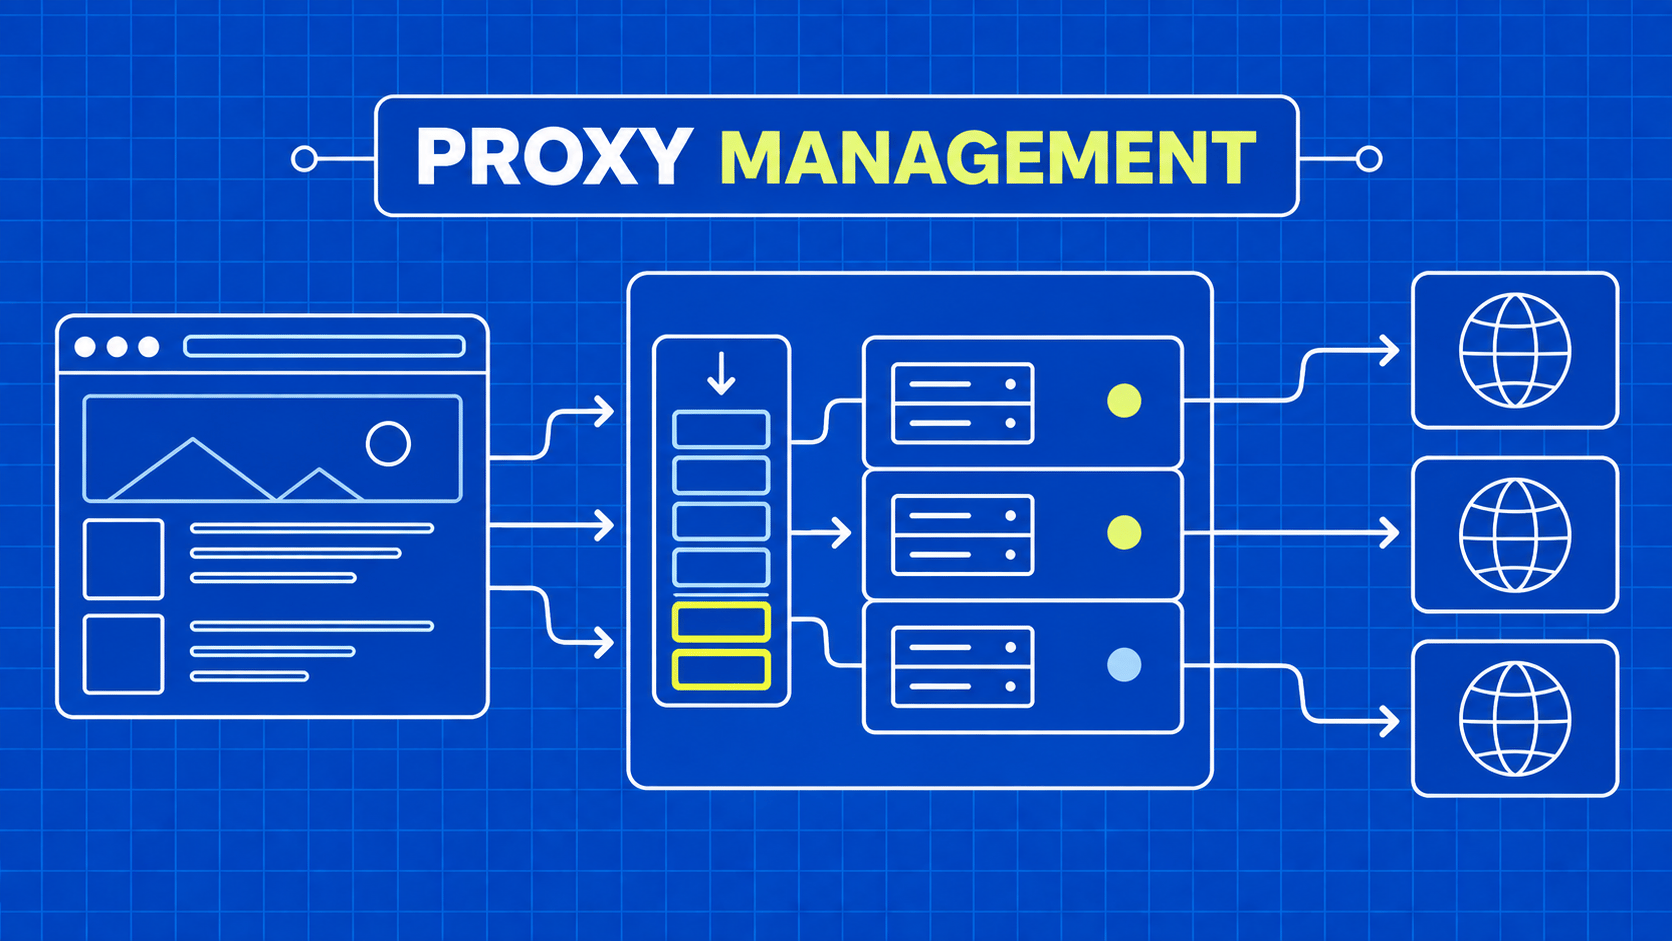
En bref : la gestion des proxys pour le web scraping constitue la couche de politique qui attribue les tâches autorisées aux routes réseau appropriées et suit ce qui se passe par la suite. Il convient de séparer l’état de la session, l’intégrité de la route et les budgets de requêtes source. Une route doit être alternée ou retirée pour une raison opérationnelle documentée, et non en réponse automatique à chaque page inaccessible.
Un worker reçoit une page produit vide et marque son proxy comme inactif. Un autre worker emprunte immédiatement un nouvel itinéraire et réitère la requête. Après plusieurs tentatives, le pool semble défaillant, mais la véritable cause de l’échec est un analyseur syntaxique qui s’attend à un élément que la source a supprimé.
Il s’agit d’un problème de gestion avant d’être un problème de réseau. Le système a pris une décision de routage en s’appuyant sur des informations provenant de la mauvaise couche. Ajouter davantage d’adresses ne ferait qu’aggraver l’erreur, et non la corriger.
Un gestionnaire de proxys efficace ne se contente pas de choisir le prochain point de terminaison. Il sait quelles tâches nécessitent une continuité, quels itinéraires respectent les exigences d’emplacement approuvées, quel volume de trafic la source peut recevoir et à quel moment un opérateur doit examiner une défaillance. Son succès se mesure à l’aune d’observations valides fournies dans le respect de la politique de collecte, et non à la fréquence à laquelle il change d’adresse.
Ce guide décrit cette conception à l’intention des développeurs exploitant des collecteurs autorisés. Les exemples présentés constituent des recommandations architecturales originales et ne constituent pas une référence par rapport à un fournisseur. Vous pouvez appliquer les mêmes contraintes à un petit worker basé sur une configuration ou à un service de collecte partagé de plus grande envergure.