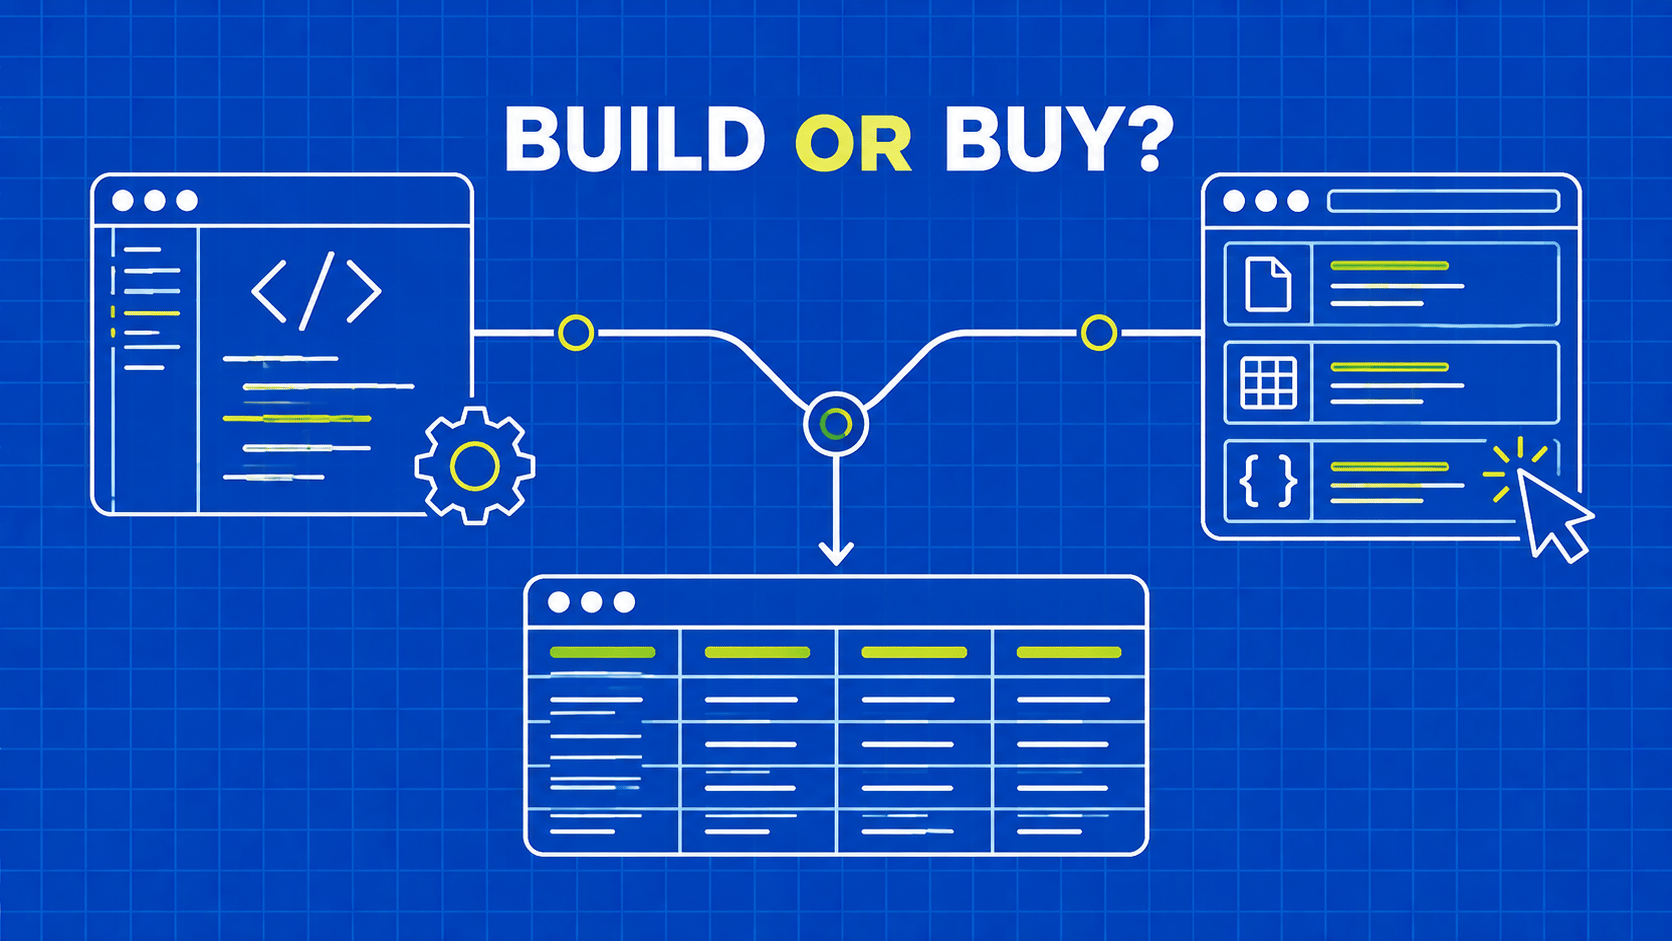
En bref : Développez un scraper sur mesure lorsque votre logique d’extraction, vos contraintes de déploiement ou la couverture de vos sources nécessitent un niveau de contrôle qu’aucun outil ne peut vous offrir. Achetez les fonctionnalités de collecte qui ne constituent pas un élément différenciateur de votre produit, puis comparez les deux approches en termes de fraîcheur et de validité des enregistrements fournis, de maintenance technique et de possibilité de changer de solution ultérieurement.
Un scraper personnalisé est un logiciel conçu et maintenu par votre équipe pour collecter des données sur des sites web en vue de répondre à un besoin spécifique. Les outils d’extraction de données offrent une partie de ces fonctionnalités via une interface visuelle, une API hébergée ou un service de livraison géré. Le choix entre un scraper personnalisé et des outils d’extraction de données est donc une question de responsabilité : quelles parties du pipeline de collecte vos développeurs doivent-ils prendre en charge ?
Imaginez une équipe produit qui a besoin des prix quotidiens issus des catalogues publics des fournisseurs. Un script qui extrait un prix d’une page prouve que le champ est accessible. Il ne prouve pas que l’équipe peut collecter toutes les variantes requises, distinguer une promotion d’un simple changement de mise en forme, ou récupérer une livraison manquée avant la prochaine génération de rapports.
Une comparaison pertinente doit partir de cette exigence de livraison. Une implémentation sur mesure pourrait bien y répondre. Un service hébergé pourrait éliminer les tâches opérationnelles les plus fastidieuses. Une combinaison des deux pourrait vous permettre de conserver votre logique produit tout en externalisant la récupération des pages. Ce guide vous propose une matrice de décision, un modèle de coûts et un plan pilote pour choisir entre ces options sans vous fier aux benchmarks des fournisseurs ni partir du principe que le temps d’ingénierie est gratuit.