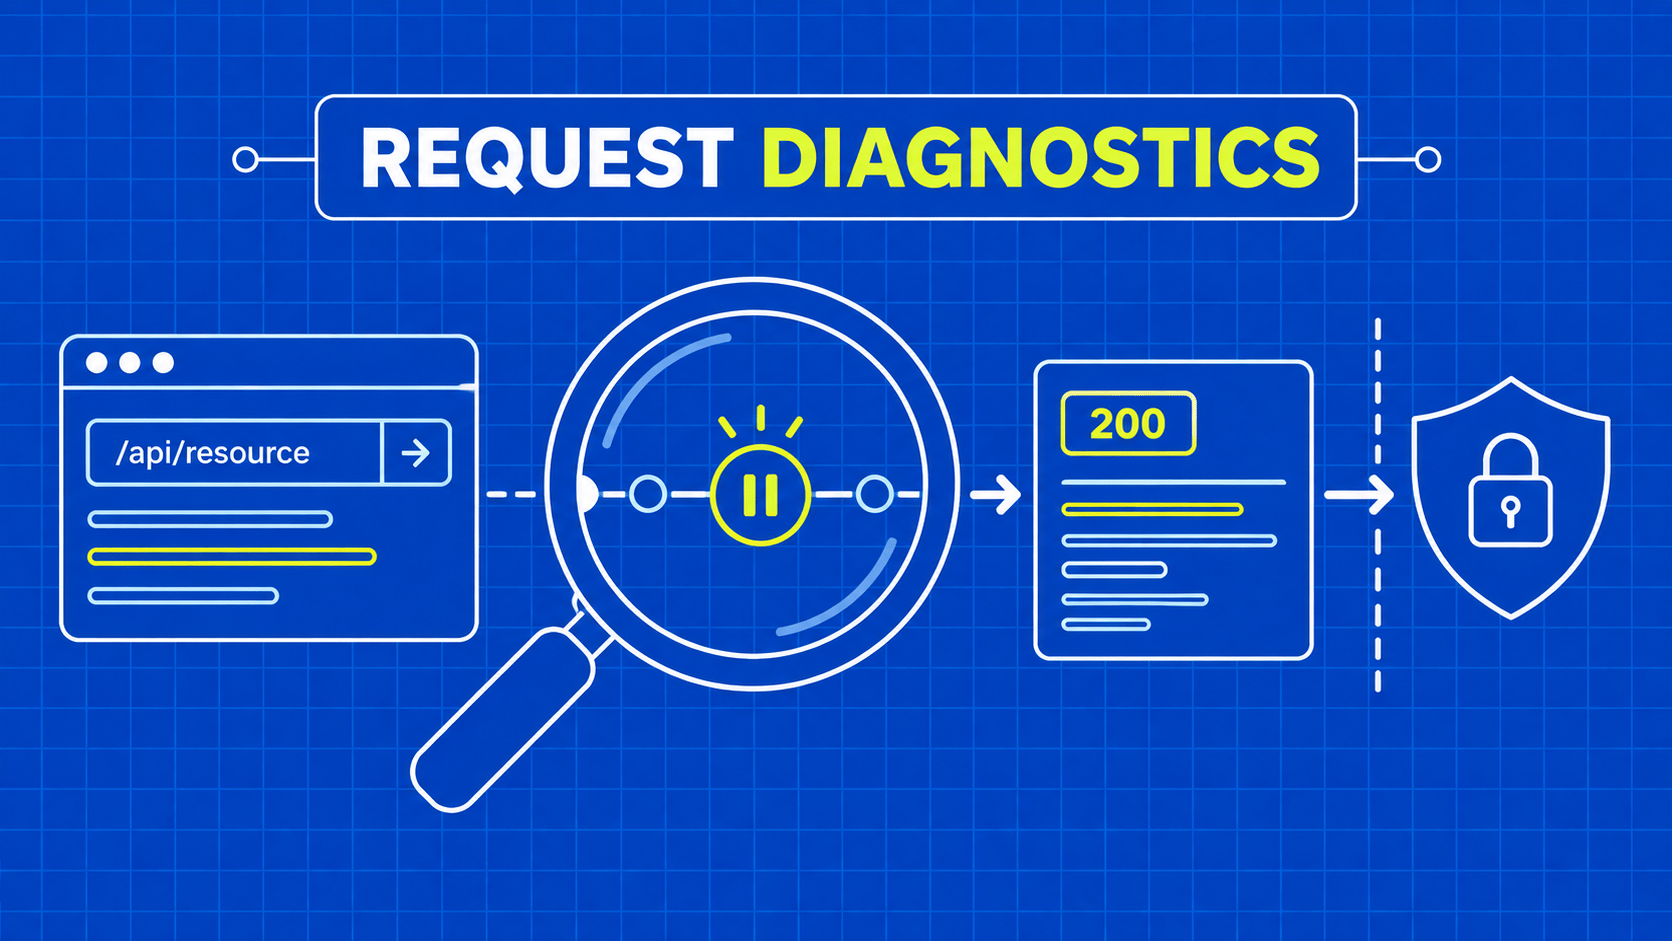
En bref : un scraping infructueux ne prouve pas qu’il y ait eu blocage d’adresse IP. Déterminez si l’échec est dû au transport, à l’authentification du proxy, à la limitation de débit, à l’accès à la source ou à un contenu de page invalide avant de modifier quoi que ce soit. Suspendez toute tentative en cas de restrictions d’accès, respectez les limites imposées par la source et ne reprenez que lorsqu’un test contrôlé produit le résultat autorisé attendu.
Un blocage d’IP lors d’un scraping Web est une restriction associée à l’adresse réseau d’une requête, mais cette expression est souvent utilisée pour désigner des échecs qui n’ont absolument rien à voir avec une adresse IP. Un délai d’expiration, une réponse 403 et une page de connexion renvoyée avec le statut 200 sont des phénomènes distincts.
Imaginez un collecteur de catalogues qui fonctionne dans un navigateur manuel mais qui échoue lors de sa tâche planifiée. Le navigateur dispose d’une session authentifiée, ce qui n’est pas le cas de la tâche, et les deux utilisent le même réseau. Qualifier cela de « blocage d’adresse IP » oriente l’enquête vers le mauvais composant.
La première tâche ne consiste pas à faire tourner les adresses. Il s’agit de déterminer ce qui a changé, quelle couche a généré la réponse et si la collecte demandée reste autorisée. Ce n’est qu’alors que vous pourrez choisir une mesure de rétablissement proportionnée.
Ce guide fournit aux développeurs un processus de diagnostic et de rétablissement pour la collecte autorisée. Il ne promet pas une immunité permanente contre les blocages ni n’enseigne comment contourner les contrôles d’accès. L’objectif est de mettre en place une tâche fiable et explicitable, capable de distinguer une défaillance technique réparable d’une requête qui doit être suspendue pour examen.