
Aller au contenu
Retour au blog

Extraction de données à partir de plans de site : découvrez des URL en respectant des limites de sécurité

Robert MunceanuDernière mise à jour le 16 min read
Extraction de données à partir de plans de site : découvrez des URL en respectant des limites de sécurité
En bref : un plan du site est une source d’exploration, et non un ensemble de données complet ni une autorisation d’extraire toutes les URL répertoriées. Il convient de distinguer les ensembles d’URL des index, d’analyser les espaces de noms avec rigueur, de considérer les métadonnées de fraîcheur comme une affirmation de la source, et d’appliquer des limites de récupération avant d’ajouter des cibles à une file d’attente de collecte.

Une catégorie de produits affiche vingt liens, mais son plan de site répertorie des milliers d’adresses de produits. L’exploration de plans de site peut vous aider à découvrir cet ensemble plus vaste de candidats sans avoir à parcourir chaque menu. La distinction importante est qu’un plan de site fournit des emplacements et des métadonnées limitées ; il ne fournit pas les fiches produits elles-mêmes ni ne garantit que chaque page répertoriée est disponible.

La découverte basée sur les plans de site modifie également la limite de confiance. Les fichiers XML et les URL qu’ils contiennent constituent des données d’entrée externes. Un analyseur syntaxique peut reconnaître correctement un document alors que l’adresse résultante se trouve en dehors de votre périmètre de collecte. Un index peut pointer vers de nombreux documents, et les fichiers compressés peuvent, une fois décompressés, dépasser largement leur taille de transfert.

Ce guide distingue la découverte, la validation et la collecte. Vous examinerez les deux principaux formats XML, exécuterez un script Python local, définirez des limites de parcours et déciderez comment utiliser lastmod sans les considérer comme une preuve de modification. L’exercice utilise des documents fictifs conservés en mémoire et n’effectue aucune requête réseau. Appliquez le même raisonnement à un site approuvé avant d’ajouter ses pages découvertes à une véritable file d’attente de récupération.

Utilisez les plans de site issus du web scraping comme données d’entrée pour la découverte

Commencez par l’objectif de collecte. Si vous avez besoin de détails sur les produits, une liste d’URL de pages constitue un résultat intermédiaire. Il vous reste à identifier quelles adresses correspondent à des produits, à récupérer les pages appropriées, à extraire les champs et à valider les enregistrements obtenus.

Un plan du site peut être déclaré par le site lui-même ou fourni directement par son propriétaire. Un nom de fichier conventionnel est un candidat utile, mais cela ne garantit pas que tous les sites l’utilisent. Considérez la découverte de l’adresse du plan du site et l’autorisation de collecter son contenu comme deux questions distinctes.

Pour l’exploration de plans de site, conservez une file d’attente de candidats plutôt que d’aller immédiatement chercher chaque emplacement. Enregistrez où chaque URL a été découverte et quelle règle l’a admise dans la file d’attente des pages. Cela facilite l’analyse ultérieure d’un index étendu ou d’un document inattendu.

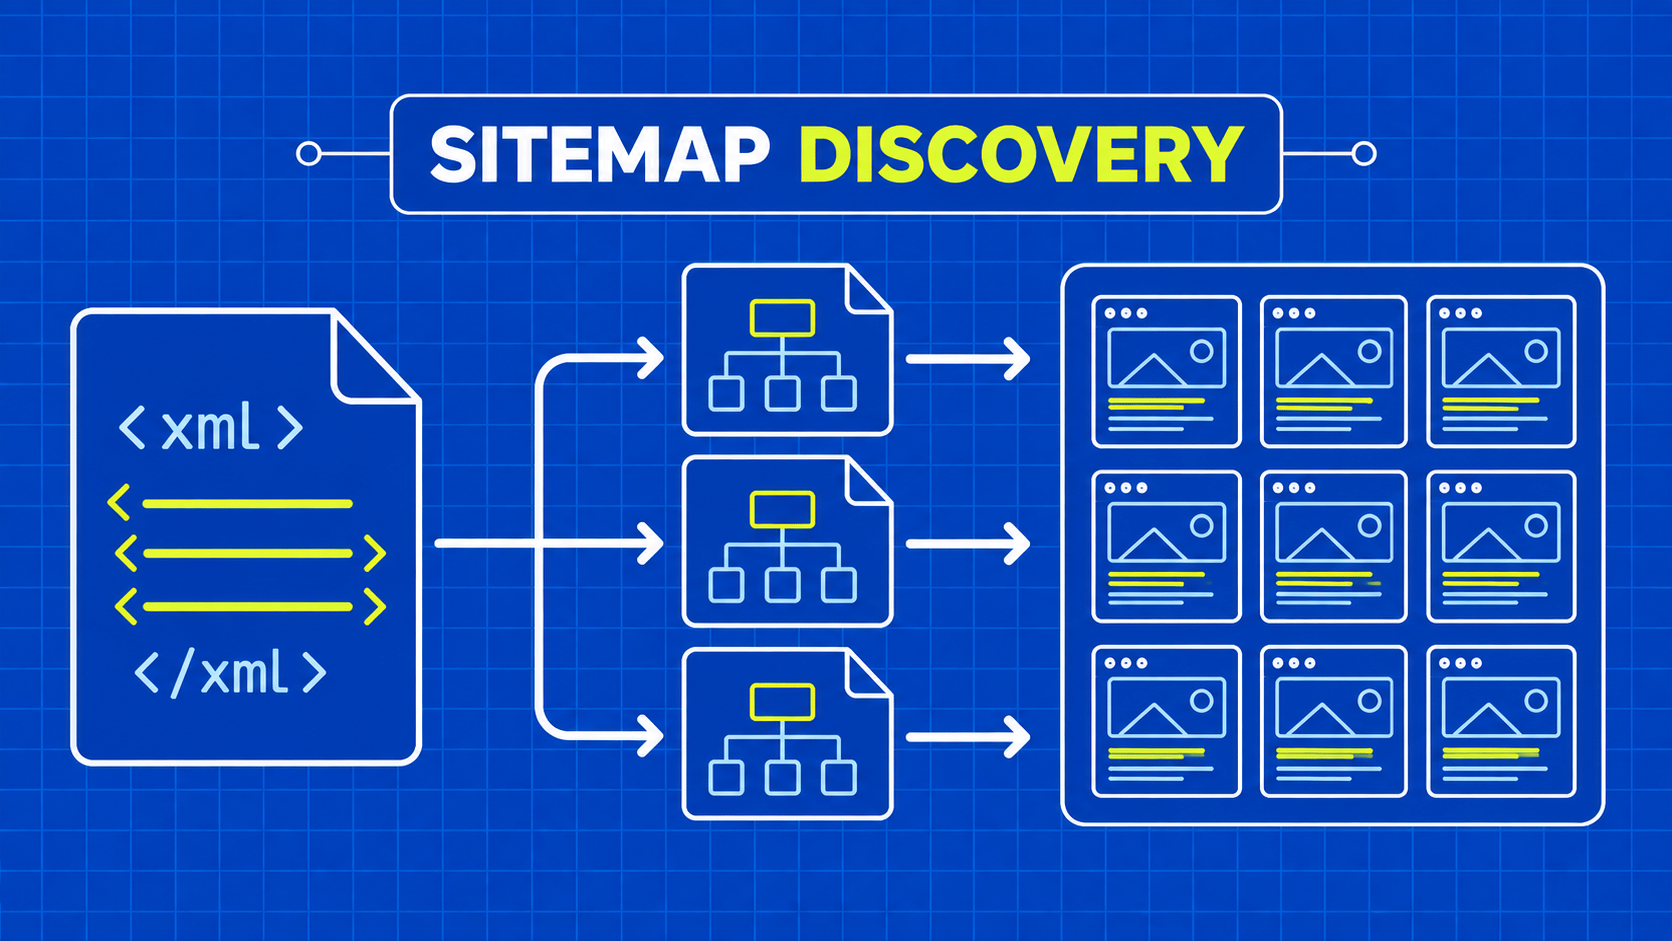
Couche

Entrée

Sortie utile

Découverte du plan du site

Site approuvé et emplacements connus des plans de site

Liste de travail des documents de plan de site

Interprétation XML

Contenu des plans de site délimité

Emplacements classifiés des plans de site enfants ou des pages

Validation de la portée

URL candidates analysées

Cibles autorisées et motifs de rejet des cibles

Collecte de pages

File d'attente des pages approuvées

Représentations récupérées

Extraction des enregistrements

Règles relatives au contenu des pages et aux champs

Enregistrements métier validés

Il ne faut pas confondre l’intention de publication avec l’exhaustivité. Un site peut omettre des pages, publier des entrées obsolètes ou gérer plusieurs collections de plans de site pour différents contenus. Votre rapport d’exploration doit décrire ce que contenaient les documents inspectés, et non affirmer qu’aucune autre page n’existe.

Distinguez également un échec de récupération d’une page supprimée. Une erreur temporaire de passerelle lors de la découverte ne permet pas de déterminer de manière concluante si le contenu répertorié existe toujours. Le guide de diagnostic de l’état du proxy explique pourquoi les catégories de réponses nécessitent des preuves avant de pouvoir être considérées comme des conclusions concernant la source.

Limitez suffisamment la portée initiale pour pouvoir l’inspecter manuellement. Un seul plan de site approuvé et quelques types de pages représentatifs peuvent révéler si cette méthode de découverte est adaptée à la tâche avant qu’un parcours à grande échelle ne masque d’éventuelles incohérences.

Distinguez les ensembles d’URL, les index et les données d’extension

La racine XML vous indique ce que contient le document. Un urlset contient des entrées de page ; un sitemapindex contient des entrées pointant vers des documents de plan de site. Les deux utilisent l'espace de noms Sitemaps, et leurs éléments loc ont des rôles différents. Le protocole Sitemaps définit ces structures.

Document ou élément

Signification pour le collecteur

Traitement

urlset contenant url/loc

Pages candidates

Valider et ajouter au résultat de la découverte de pages

sitemapindex contenant sitemap/loc

Candidats au document de plan du site

Valider et ajouter au parcours du plan du site

Entrée de page lastmod

Valeur de modification de la page par l’éditeur

Conserver en tant que métadonnées avec sa source

Entrée d’index lastmod

Valeur de modification du plan du site par l'éditeur

À ne pas confondre avec l'actualité de la page

Éléments de l'espace de noms de l'extension

Métadonnées supplémentaires spécifiques au domaine

À interpréter uniquement dans le cadre d’un contrat d’extension explicite

Les espaces de noms XML ont leur importance même lorsque la balise visible semble simple. Avec un espace de noms par défaut, un analyseur XML identifie l’élément en utilisant à la fois l’URI de l’espace de noms et le nom local. La recherche d’éléments url peut donc ne renvoyer aucun résultat à partir d’un plan de site par ailleurs valide.

Lors de l’exploration de plans de site, sélectionnez le chemin structurel spécifique dont vous avez besoin. Une recherche large portant sur tous les éléments nommés loc peut mélanger les emplacements de pages avec des références de plan de site ou des métadonnées d’extension. Distinguez l’espace de noms principal des extensions d’image, de vidéo, d’actualités ou autres, plutôt que de supprimer tous les espaces de noms sans distinction.

Laissez l'analyseur XML se charger de l'échappement des entités. Une URL contenant un séparateur de requête peut apparaître avec & dans le XML et produire & dans le texte analysé. Ne remplacez pas de chaînes arbitraires avant l’analyse et ne décodez pas les URL à plusieurs reprises jusqu’à ce qu’elles vous semblent convenir.

Conservez l’adresse d’origine découverte parallèlement à toute normalisation que vous appliquez. La normalisation doit mettre en œuvre des règles d’identité connues, et non supposer que différents chemins ou chaînes de requête sont équivalents. Une liste d’URL ne devient une entrée utile que lorsque son interprétation reste cohérente avec le contrat source et la portée de votre collection.

Analysez un modèle de plan de site tenant compte des espaces de noms locaux

Enregistrez cet exercice sous le nom sitemap_fixture.py et exécutez-le avec Python 3. Il utilise uniquement la bibliothèque standard, analyse des chaînes Unicode fixes en mémoire et n’effectue aucune récupération sur le réseau. Le fixture classe un index et un ensemble d’URL, puis vérifie qu’un hôte non associé est rejeté.

from urllib.parse import urlsplit
from xml.etree import ElementTree as ET

NS = "http://www.sitemaps.org/schemas/sitemap/0.9"
INDEX = f'''<sitemapindex xmlns="{NS}">
  <sitemap><loc>https://catalog.example/products.xml</loc></sitemap>
</sitemapindex>'''
URLS = f'''<urlset xmlns="{NS}">
  <url><loc>https://catalog.example/products/lamp</loc>
    <lastmod>2026-09-01</lastmod></url>
  <url><loc>https://catalog.example/products/book?lang=en&amp;view=full</loc></url>
</urlset>'''

def allowed_url(value):
    if not value or any(ord(char) <= 32 for char in value):
        raise ValueError("missing URL or control/space character")
    parts = urlsplit(value)
    if (parts.scheme != "https" or parts.netloc != "catalog.example"
            or parts.fragment):
        raise ValueError("URL outside fixture scope")
    return value

def parse_fixture(text):
    if len(text.encode("utf-8")) > 10_000:
        raise ValueError("fixture byte budget exceeded")
    upper = text.upper()
    if "<!DOCTYPE" in upper or "<!ENTITY" in upper:
        raise ValueError("declarations not accepted in this fixture")
    root = ET.fromstring(text)
    shapes = {
        f"{{{NS}}}urlset": ("pages", "url"),
        f"{{{NS}}}sitemapindex": ("sitemaps", "sitemap"),
    }
    if root.tag not in shapes:
        raise ValueError("unsupported root or namespace")
    kind, child = shapes[root.tag]
    entries = root.findall(f"{{{NS}}}{child}")
    if len(entries) > 10:
        raise ValueError("fixture entry budget exceeded")
    result = []
    for entry in entries:
        locations = entry.findall(f"{{{NS}}}loc")
        if len(locations) != 1:
            raise ValueError("expected exactly one location")
        location = allowed_url((locations[0].text or "").strip())
        modified = entry.findtext(f"{{{NS}}}lastmod")
        result = [*result, {"url": location, "lastmod_raw": modified}]
    return kind, result

kind, children = parse_fixture(INDEX)
assert kind == "sitemaps" and len(children) == 1
documents = {"https://catalog.example/products.xml": URLS}
kind, pages = parse_fixture(documents[children[0]["url"]])
assert kind == "pages" and len(pages) == 2
assert pages[0]["lastmod_raw"] == "2026-09-01"
assert pages[1]["url"].endswith("?lang=en&view=full")
for invalid in [
    URLS.replace("catalog.example", "other.example"),
    '<!DOCTYPE urlset><urlset/>',
    '<urlset><url><loc>https://catalog.example/x</loc></url></urlset>',
]:
    try:
        parse_fixture(invalid)
    except ValueError:
        pass
    else:
        raise AssertionError("invalid fixture accepted")
print("index classified; 2 page URLs parsed; rejection checks passed")

Le test autorise délibérément une seule autorité HTTPS exacte. Il ne suit pas les redirections, ne résout pas les noms de domaine, ne décompresse pas les données et ne prétend pas que les vérifications d’URL au niveau des chaînes de caractères empêchent la falsification de requêtes côté serveur. Ces contrôles relèvent d’une couche de récupération en production.

La vérification de la déclaration se limite également aux chaînes déjà décodées par le test. Il ne s’agit pas d’un pare-feu XML général destiné à des encodages distants arbitraires. Utilisez un analyseur syntaxique correctement configuré et des limites de récupération pour les entrées non fiables, plutôt que de reproduire cette vérification comme solution de défense complète.

Remarquez comment lastmod est conservé sous forme de métadonnées brutes de la source. L’exercice ne le convertit pas en preuve que la page a changé ni en commande de planification. La deuxième page ne présente aucune valeur de modification, ce qui la distingue d’un horodatage ancien connu.

Ce petit test couvre les limites d’interprétation dans le scraping de plans de site : classification racine, chemins tenant compte des espaces de noms, décodage d’entités, un seul hôte autorisé et rejet des structures mal formées. Conservez ces tests lors de l’ajout du transport, puis ajoutez des tests distincts pour les règles de redirection, de taille et de destination du transport.

Parcourez les index avec des budgets et un ensemble de pages visitées

Utilisez des files d’attente distinctes pour les documents de plan de site et les pages candidates. Lancez la file d’attente des documents avec l’index approuvé, récupérez et classez un document délimité, puis placez les emplacements de ses plans de site enfants ou de ses pages dans la destination appropriée. Ne placez pas une page dans la file d’attente en tant qu’autre plan de site simplement parce que les deux contiennent des URL.

Gérez un ensemble des emplacements de documents déjà visités afin que les références répétées n’entraînent pas un travail répétitif à l’infini. Si un fournisseur publie un imbrication d’index inattendue, déterminez si votre collecteur doit la rejeter ou prendre en charge un parcours délimité. Ne partez pas du principe qu’une imbrication arbitraire est une garantie du protocole portable.

Les limites du protocole et les budgets opérationnels sont deux choses différentes. Un plan de site standard autorise au maximum 50 000 URL et 50 Mo, soit précisément 52 428 800 octets, une fois décompressé. Les index de plans de site sont également soumis à des limites de nombre d’entrées et de taille. La compression réduit la taille des transferts sans supprimer la limite de taille non compressée. Votre tâche peut nécessiter des limites inférieures pour s’adapter à sa mémoire, à son temps d’exécution et à son périmètre approuvé.

Pour le web scraping de plans de site à grande échelle, limitez les octets transférés, les octets décompressés, les documents, les entrées, le temps écoulé et la profondeur de parcours, le cas échéant. Une petite réponse compressée peut tout de même produire un corps de données volumineux après décompression. Appliquez ces limites lors de la lecture et de la décompression, et pas seulement après l’allocation du document décompressé complet.

Enregistrez les références rejetées et ignorées. « Déjà visité » est différent de « hôte non autorisé », « document trop volumineux » ou « XML impossible à analyser ». Ces catégories expliquent pourquoi le nombre de pages découvertes diffère du nombre d’entrées initialement rencontrées.

Effectuez un point de contrôle après l’enregistrement d’une sortie durable. Si les résultats de la découverte sont stockés séparément de l’état de la traversée, concevez un comportement de redémarrage permettant de rejouer un document en toute sécurité. La déduplication doit empêcher les entrées en double dans la file d’attente sans masquer les modifications apportées aux métadonnées importantes pour la tâche.

Enfin, conservez l’heure de récupération du document et son emplacement final approuvé. Sans cela, une redirection ou un document modifié pourrait faire apparaître deux exécutions comme identiques alors qu’elles ont en réalité inspecté des entrées différentes.

Traitez « lastmod » et les autres métadonnées comme des déclarations de la source

Le champ au niveau de la page lastmod représente la dernière modification de cette page telle que déclarée par l’éditeur. Elle n’est pas censée correspondre à l’heure d’exécution du générateur de plan du site. Une valeur de modification au niveau de l’index fait plutôt référence au document du plan du site. Confondre ces significations peut déclencher des actualisations de pages inutiles ou en omettre des pertinentes.

Pour l’exploration de plans de site, conservez la valeur brute et ne l’analysez que dans le cadre d’une politique de date explicite. Une date sans heure est moins précise qu’un horodatage. Une valeur manquante ou mal formée doit rester inconnue ; elle ne doit pas être remplacée par la date du jour ni par une valeur par défaut impliquant une certitude.

Considérez cette valeur comme une indication de priorité jusqu’à ce que la source ait démontré une précision suffisante pour votre tâche. Comparez un échantillon des modifications annoncées avec les observations réelles des pages. Un horodatage fiable pour du contenu éditorial peut s’avérer trop approximatif pour des cours boursiers qui évoluent fréquemment.

Les recommandations de Google concernant les sitemaps expliquent l’utilisation de lastmod et précisent qu’il ignore priority et changefreq. Cela décrit le comportement de Google, et non une exigence imposant à votre collecteur de reproduire sa politique de planification. Ne transformez pas les métadonnées facultatives des éditeurs en une instruction universelle de récupération.

La validation HTTP est à nouveau distincte. L’entité tag d’un serveur ou l’en-tête de réponse « Last-Modified » peuvent intervenir dans la récupération conditionnelle selon les règles HTTP. La date d’un plan de site ne remplace pas ces validateurs et ne garantit pas une 304 réponse. La RFC 9111 définit la fraîcheur du cache et le comportement de validation.

Pour le rapport de collecte, conservez séparément les métadonnées de modification de la source, l’heure de découverte et l’heure d’observation de la page. Elles indiquent quand l’éditeur signale un changement, quand vous avez trouvé l’adresse et quand vous avez observé la représentation effective.

Tenez compte de cette distinction lors de la planification. Donner la priorité aux modifications récemment annoncées peut optimiser l’ordre des tâches, tandis qu’un rapprochement périodique permet de pallier les dates manquantes ou peu fiables. Documentez cette politique afin que les utilisateurs comprennent ce que signifie réellement « récemment actualisé ».

Limitez la récupération avant de faire confiance aux URL découvertes

L’analyse XML et l’analyse d’URL ne donnent pas l’autorisation d’effectuer une requête réseau. Une adresse peut pointer vers l’extérieur du site approuvé, contenir des identifiants, utiliser un schéma inattendu ou mener à une adresse qui ne devrait pas être accessible depuis le collecteur. Traitez chaque adresse découverte comme une entrée non fiable soumise à un contrôle d’admission distinct.

La documentation de Python sur l’analyse des URL avertit explicitement que les fonctions d’analyse ne valident pas les entrées. Une séparation réussie entre le schéma et le nom d’hôte ne constitue donc pas une décision de sécurité. Appliquez une politique explicite concernant les schémas, les hôtes, les ports, les informations utilisateur et la portée.

La falsification de requêtes côté serveur devient un risque lorsque un service automatisé récupère des destinations influencées par des entrées externes. Maintenez les contrôles de destination à la limite réelle du réseau, y compris les redirections et les adresses résolues. Une liste blanche de noms d’hôtes ne couvre pas à elle seule tous les scénarios DNS ou de redirection, et la validation d’un saut n’autorise pas le suivant.

Lors du scraping de plans de site, évitez de transmettre les identifiants de la requête d’origine à un hôte nouvellement découvert. Certains éditeurs utilisent des accords d’hébergement intersites pris en charge, mais votre collecteur ne doit activer que les accords qu’il a explicitement approuvés. Une référence externe ne constitue pas une instruction visant à étendre automatiquement la portée de la collecte.

Un XML non fiable ajoute une autre limite. L’expansion des entités, l’accès aux ressources externes et le comportement face aux tokens volumineux dépendent de l’analyseur et de sa configuration. La documentation sur la sécurité XML en Python résume les risques et souligne l’importance de la version de l’analyseur sous-jacent. Ne partez pas du principe que toutes les bibliothèques XML partagent les mêmes paramètres par défaut.

Utilisez des mesures de protection actuelles et adaptées pour l’analyseur, associées à des limites de taille et d’exécution. Rejetez les fonctionnalités de document non prises en charge plutôt que d’activer la résolution d’entités externes pour permettre l’analyse d’un fichier. Considérez un plan de site mal formé comme un échec de découverte, accompagné d’un diagnostic épuré aidant le propriétaire de la source à mener son enquête.

Ces contrôles sont complémentaires. L'analyse tenant compte des espaces de noms évite toute confusion structurelle ; la politique relative aux URL contrôle les destinations ; l’application des règles réseau vérifie la connexion ; et les budgets alloués aux ressources limitent le travail. Aucun ne peut se substituer en toute sécurité à tous les autres.

Mesurez la couverture de la découverte avant de procéder au scraping des pages

À la fin de la traversée, indiquez ce qui a été inspecté et pourquoi le traitement s’est arrêté. Incluez le nombre de documents, les pages candidates acceptées, les doublons, les destinations rejetées, les échecs d’analyse et les arrêts liés aux budgets. Un nombre élevé d’URL ne suffit pas à lui seul à prouver que la découverte est complète ou correcte.

Vérifiez un échantillon des URL admises par rapport à votre schéma cible. Les pages de produits, de catégories, de recherche et éditoriales peuvent coexister dans un même ensemble de plans de site. Définissez une règle de routage pour chaque type pertinent et excluez les types non pertinents de la file d’attente d’extraction, plutôt que de laisser leurs champs manquants fausser les indicateurs de validation des enregistrements.

Le scraping de plans de site résout la découverte des adresses, pas le rendu des pages. Si les pages sélectionnées n’exposent les données qu’après l’exécution dans le navigateur, le guide de scraping d’écran explique comment choisir une condition de disponibilité et extraire les champs rendus. Ne partez pas du principe qu’un plan de site garantit un contenu HTML statique.

Préservez la provenance tout au long de ce transfert. Un enregistrement de page doit conserver l’URL découverte, la source du plan du site, l’heure d’observation et la version d’extraction, le cas échéant. Les adresses redirigées ou canonisées nécessitent une politique d’identité explicite plutôt qu’un remplacement non documenté.

Le guide du workflow de collecte automatisée relie la découverte au traitement durable, aux tentatives de réessai et à la livraison. Veillez à ce que ces étapes restent observables afin qu’une interruption de la récupération ne donne pas l’impression que l’analyseur de plan du site a renvoyé moins d’entrées.

Avant de passer à l’échelle, testez une référence de document en double, une URL rejetée, un fichier XML mal formé et un budget épuisé. Le résultat utile ne se limite pas au simple arrêt du script. Celui-ci doit s’arrêter en fournissant une classification expliquant quelle partie du périmètre de découverte prévu reste non résolue.

Points clés à retenir

  • Utilisez le scraping de plans de site pour constituer une file d’attente de candidats, puis validez les destinations et extrayez les enregistrements de pages en étapes distinctes.
  • Analysez la racine et l’espace de noms de manière méthodique afin que les références du plan du site, les emplacements des pages et les données d’extension ne soient pas mélangés.
  • Appliquez des contrôles de taille tenant compte du protocole, parallèlement à des budgets opérationnels plus stricts, incluant les octets décompressés et le travail total de traversée.
  • Conservez lastmod en tant que métadonnées d’éditeur ; distinguez-les du moment de la découverte, du moment de l’observation et des validateurs HTTP.
  • Veillez à ce que l’admission des URL, les contrôles des destinations réseau, les protections XML et les rapports d’exhaustivité puissent être testés indépendamment.

FAQ

Un site peut-il avoir plusieurs index de plan de site ?

Oui. Le protocole autorise plusieurs index de plans de site. Pour les plans de site issus du web scraping, identifiez ou recevez l’ensemble approuvé plutôt que de supposer qu’un seul index recense tous les plans de site. Conservez la provenance de chaque document de départ et précisez si leurs résultats sont regroupés dans une seule portée de collecte ou rapportés séparément.

Faut-il supprimer les paramètres de requête des URL de plan de site ?

Pas systématiquement. Les paramètres de requête peuvent identifier la langue, le contenu ou une autre variante significative. Ne les supprimez que si une règle d’identité vérifiée s’applique à cette source. Conservez l’URL découverte afin qu’une correction ultérieure reste possible, et vérifiez que toute normalisation ne fusionne pas des enregistrements distincts ni ne modifie la représentation récupérée.

Les entrées de plan de site prouvent-elles qu’une page est indexable ?

Non. Une adresse répertoriée est un signal de découverte, et non la preuve qu’un moteur de recherche peut l’indexer ou le fera. D’autres conditions relatives à la page et à l’accès s’appliquent toujours. Pour la collecte de données, vérifiez la réponse effective et le contenu requis plutôt que d’interpréter la présence dans le plan du site comme une garantie de disponibilité ou d’adéquation.

Conclusion

Le scraping de plans de site fonctionne mieux lorsque la découverte reste une étape distincte et mesurable. Classez le document, analysez l’espace de noms approprié, conservez les métadonnées de la source et n’acceptez que les cibles conformes à la politique de collecte. Signalez ensuite à la fois les candidats découverts et les raisons pour lesquelles certaines parties du parcours sont restées incomplètes.

Commencez par l’environnement local et étendez les limites une par une. Ajoutez une récupération limitée avant les fichiers volumineux, une validation de la destination avant les références externes et une progression durable avant un parcours de longue durée. Conservez les cas de test qui montrent un échec clair lorsque ces limites sont dépassées.

Lorsque la file d’attente des pages approuvées est prête, évaluez l’API Scraper de WebScrapingAPI pour l’étape de récupération. Conservez votre propre traçabilité de découverte et vos contrôles d’enregistrement afin que l’ensemble de données résultant explique à la fois d’où proviennent ses URL et ce qui a été réellement observé.

À propos de l'auteur

Robert Munceanu, Développeur full-stack @ WebScrapingAPI

Robert Munceanu

Développeur full-stack

Robert Munceanu est développeur Full Stack chez WebScrapingAPI ; il participe à l'ensemble du produit et contribue à la création d'outils et de fonctionnalités fiables qui soutiennent la plateforme.

Web scraping avec AWS Lambda : guide pour Python et Java 2026
Guides

Web scraping avec AWS Lambda : guide pour Python et Java 2026

TL;DR: En bref : le web scraping avec AWS Lambda fonctionne mieux lorsque chaque invocation est courte, bien délimitée et peut faire l'objet d'une nouvelle tentative de manière indépendante. Commencez par utiliser les requêtes HTTP directes, AWS SAM et S3, puis ajoutez SQS, des conteneurs, le rendu dans un navigateur, des proxys ou une couche de récupération gérée uniquement lorsque la charge de travail démontre qu'elle en a besoin.

Suciu Dan33 min read
Lire l'article
Comment utiliser GoSpider : exploration, nettoyage des URL et extraction de données
Guides

Comment utiliser GoSpider : exploration, nettoyage des URL et extraction de données

TL;DR: En bref : GoSpider est un robot d'exploration en ligne de commande destiné à découvrir des URL, et non un outil complet de collecte de données structurées. Ce guide d'utilisation de GoSpider présente comment effectuer une exploration limitée, gérer correctement les résultats, transférer les données de Colly vers un fichier CSV, ainsi qu'une procédure de diagnostic pour les réponses 403 ou les pages nécessitant un rendu JavaScript.

Suciu Dan24 min read
Lire l'article
Comment récupérer les données de Redfin : Guide Python des données immobilières
Guides

Comment récupérer les données de Redfin : Guide Python des données immobilières

TL;DR: Redfin expose des points d'extrémité d'API cachés qui renvoient du JSON structuré pour les listes de propriétés, ce qui permet d'ignorer complètement l'analyse HTML fragile. Ce guide vous accompagne dans la construction d'un scraper Python qui extrait les données de location et de vente, effectue des recherches par emplacement, surveille les nouvelles inscriptions via des sitemaps XML et exporte des résultats propres au format CSV ou JSON.

Suciu Dan15 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.