
Aller au contenu
Retour au blog

Alternatives à l'API Yahoo Finance : guide à l'intention des développeurs

Raluca PenciucDernière mise à jour le 16 min read
Alternatives à l'API Yahoo Finance : guide à l'intention des développeurs
En bref : Commencez par Alpha Vantage pour les données de recherche basées sur les points de terminaison, Twelve Data pour une évaluation de séries chronologiques sur plusieurs marchés, ou Alpaca pour une application nécessitant des données de marché historiques et en temps réel. Faites votre choix en fonction de vos instruments, flux de données, règles d’ajustement et utilisation autorisée ; le simple fait de faire correspondre un code boursier et un champ nommé close ne rend pas deux ensembles de données interchangeables.

Les alternatives à l’API Yahoo Finance sont des services de données de marché documentés que vous pouvez évaluer lorsqu’un workflow dépendant de Yahoo ne répond plus aux exigences de votre application. La décision de remplacement porte sur la sémantique des données, leur diffusion et les droits d’utilisation, et pas seulement sur la requête HTTP qui renvoie un cours.

Prenons l’exemple d’un graphique qui change après la migration d’un fournisseur. La nouvelle courbe est peut-être correcte, mais elle peut reposer sur une politique d’ajustement, une session de négociation ou un flux différents. Une importation réussie n’explique pas cette différence. En l’absence de contrat de données, les développeurs peuvent passer des jours à déboguer des chiffres qui décrivent des réalités différentes.

Ce guide compare trois points de départ concrets à l’aide de leur documentation officielle, puis montre comment les évaluer sans partir du principe qu’un compte gratuit inclut tous les ensembles de données. Ces sélections constituent des recommandations basées sur des cas d’utilisation, et non un classement par performances ni une affirmation selon laquelle un service a été comparé à un autre. Les formules exactes, les autorisations d’échange et les conditions commerciales doivent être confirmées pour l’application que vous comptez exploiter.

L’objectif est une intégration fiable des données. Vous définirez les enregistrements requis, vérifierez la couverture du fournisseur et effectuerez la migration en disposant de suffisamment d’éléments pour expliquer ce qui a changé et pourquoi.
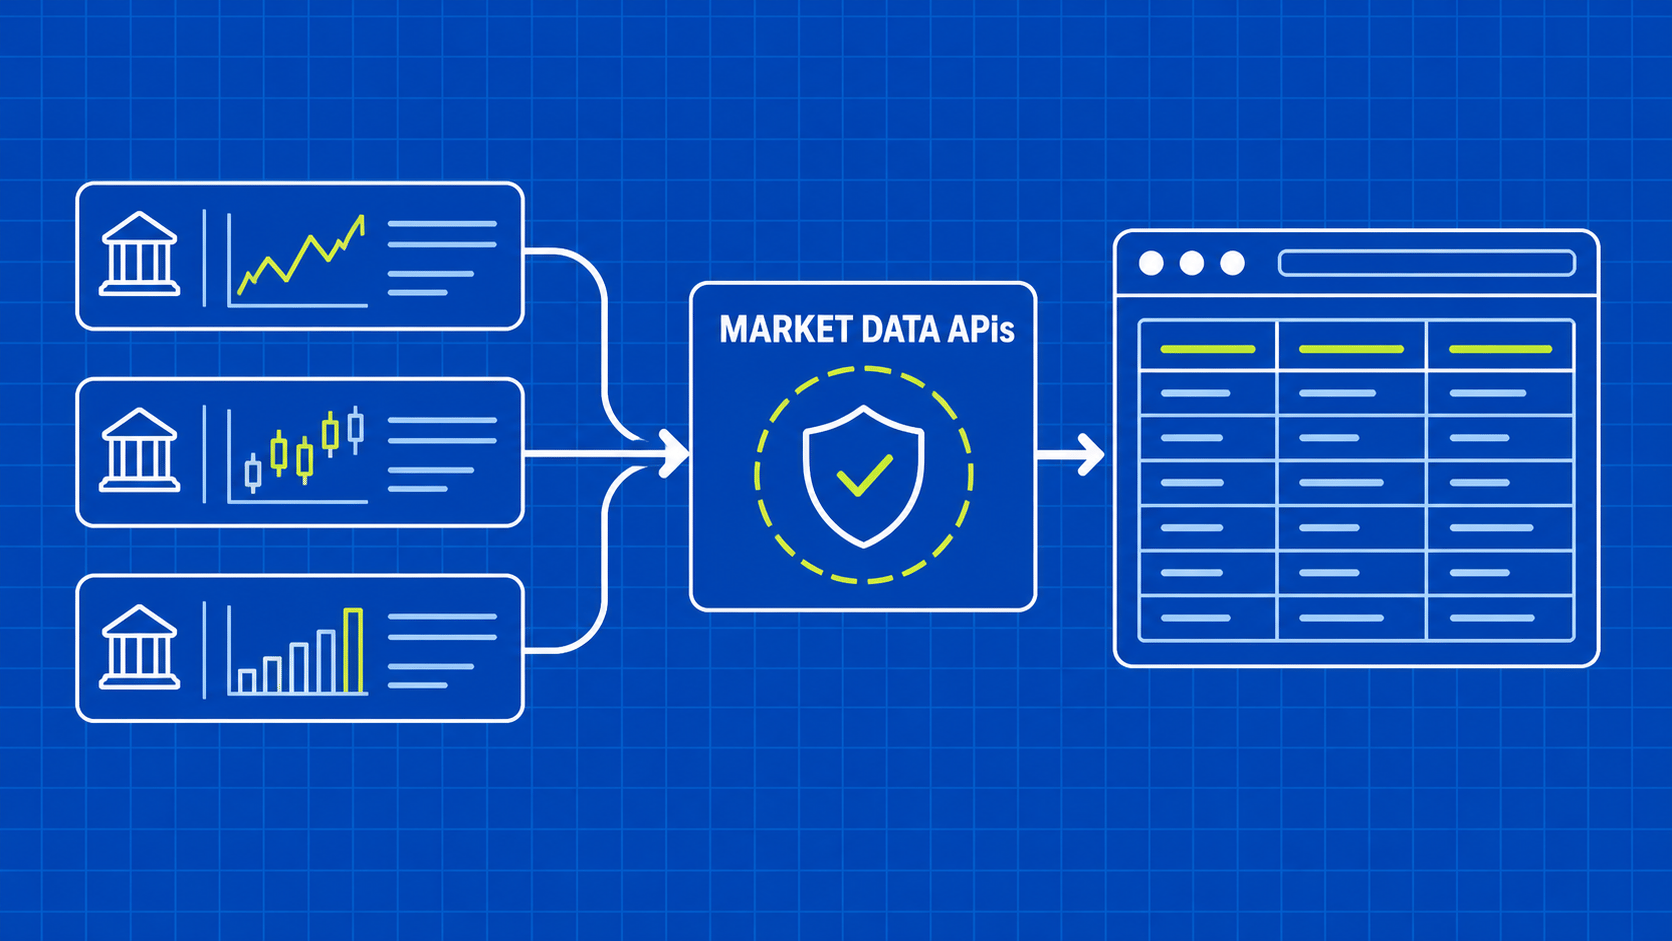
Comparez les alternatives à l’API Yahoo Finance en fonction du contrat de données

Commencez par recenser ce que votre application consomme réellement. Un graphique des cours de clôture quotidiens, un widget de cotations en temps réel et une comparaison de comptes annuels nécessitent des enregistrements différents. L'achat d'un catalogue de points de terminaison plus vaste n'est d'aucune utilité si les instruments spécifiques ou les périodes historiques manquent.

Candidat

Un point de départ utile pour l’évaluation

Éléments à vérifier avant l’adoption

Alpha Vantage

Séries chronologiques, indicateurs et workflows de points de terminaison axés sur la recherche

Droits d’accès aux critères d’évaluation, comportement d’ajustement, calendrier de mise à jour, utilisation commerciale

Twelve Data

Séries chronologiques couvrant un ensemble requis de marchés ou de types d’actifs

Prise en charge précise des bourses et des instruments, gestion des fuseaux horaires, droits d’utilisation

Données de marché Alpaca

Flux historiques et en temps réel pour l’intégration dans les applications

Sélection des flux, modèle de compte, droits d’accès, couverture historique

API SEC EDGAR

Documents déposés par les sociétés cotées et données XBRL extraites

Concepts de dépôt, unités, périodes, modifications ; ne remplace pas un flux de cotations

Les trois premiers sont des fournisseurs de données de marché à retenir. Le quatrième est une source primaire pour une autre partie d’une application financière : les déclarations. Il peut compléter le service de cotations que vous avez choisi, mais il ne doit pas être présenté comme une API de cotations.

Définissez le résultat attendu indépendamment de tout fournisseur. Pour un graphique journalier, enregistrez l’identifiant de l’instrument, la bourse, la date de la séance, la devise, le cours d’ouverture, le plus haut, le plus bas, le cours de clôture, le volume et la base d’ajustement. Pour une cotation, précisez si vous avez besoin du dernier cours, du cours acheteur et du cours vendeur, ou d’une autre valeur. Un champ générique price masque trop de différences.

Intégrez les attentes en matière de livraison dans le contrat. Précisez le délai de périmé d’un résultat, si des corrections peuvent être apportées ultérieurement, et ce que les utilisateurs doivent afficher lorsque la source n’est pas disponible. Si l’application nécessite un flux consolidé, un flux plus restreint ne constitue pas un substitut équivalent simplement parce que les deux répondent en temps réel.

Commencez par distinguer un wrapper Yahoo d’une nouvelle source de données

Changer de module Python ne modifie pas nécessairement votre dépendance en amont. Un wrapper peut améliorer la commodité tout en continuant à obtenir des données de Yahoo. Cela peut être approprié pour l’usage prévu, mais il s’agit d’un choix architectural différent du passage à un fournisseur documenté séparément.

La documentation du projet yfinance précise que celui-ci n’est ni affilié à Yahoo ni approuvé par cette société, et qu’il est destiné à la recherche et à l’enseignement. Elle renvoie les utilisateurs aux conditions d’utilisation de Yahoo concernant les droits sur les données et décrit l’API sous-jacente comme étant destinée à un usage personnel. Considérez cette déclaration du projet comme une invitation à examiner les conditions pertinentes pour votre flux de travail, et non comme un accord commercial sur les données.

Notez le problème que vous cherchez à résoudre avant de remplacer la dépendance. S’agit-il d’une couverture insuffisante, d’une instabilité des réponses, des droits de redistribution, du calendrier des mises à jour ou d’un besoin de prise en charge explicite ? Le remplacement d’un wrapper peut résoudre un problème d’interface tout en laissant toutes les autres exigences sans réponse.

Pour les développeurs travaillant directement avec HTTP, le comparatif des clients HTTP Python facilite la gestion des connexions et des requêtes. Il ne détermine pas quel flux vous êtes autorisé à utiliser ni si deux champs ont la même signification. Gardez cette distinction à l’esprit lors des revues de conception.

Alpha Vantage : évaluer les workflows de recherche basés sur les points de terminaison

La documentation officielle d’Alpha Vantage répertorie les points de terminaison de séries chronologiques, les fondamentaux des entreprises, les indicateurs techniques, les taux de change et d’autres catégories de données de recherche. Sa documentation intrajournalière distingue les données brutes des données ajustées et décrit les options d’accès en fonction de la fraîcheur des données. Certains points de terminaison sont signalés comme « premium » ; l’accès doit donc être vérifié au niveau de chaque point de terminaison.

Cela en fait un candidat raisonnable lorsque votre application effectue des requêtes explicites pour des ensembles de données connus et transforme les réponses en un modèle interne. Évaluez les fonctions exactes dont vous avez besoin plutôt que de supposer que l’accès à une série quotidienne implique l’accès à toutes les fonctionnalités intrajournalières, fondamentales ou en temps réel.

Mettez en place un projet pilote autour de cas représentatifs : un instrument classique, un instrument faisant l’objet d’une opération sur titres pertinente, ainsi que tout type de bourse ou d’actif moins courant pris en charge par votre application. Comparez les champs renvoyés avec les définitions du fournisseur avant de les intégrer dans une table existante.

Optez pour cette solution si le modèle de point de terminaison documenté correspond à votre flux de travail. Envisagez une autre option si le mode de livraison, la couverture ou le contrat requis ne conviennent pas. Il s’agit d’une décision liée aux exigences, et non d’une preuve que les données d’un fournisseur sont intrinsèquement meilleures.

Twelve Data : évaluez la couverture réelle du marché et des fuseaux horaires

La présentation de Twelve Data décrit l’accès via REST et WebSocket à travers plusieurs catégories d’actifs. C’est une option pratique lorsque l’univers des instruments s’étend sur plusieurs marchés et que vous souhaitez évaluer une interface commune. Vérifiez chaque instrument et chaque bourse requis plutôt que de considérer les déclarations générales de couverture comme une garantie pour votre liste.

Le comportement lié aux fuseaux horaires mérite un test spécifique. Twelve Data documente la gestion des fuseaux horaires des bourses, de l’UTC et des fuseaux horaires nommés, et précise que les intervalles quotidiens, hebdomadaires et mensuels utilisent l’heure locale de la bourse. Consultez ses recommandations sur les fuseaux horaires. Une date quotidienne ne correspond donc pas automatiquement à un événement à minuit UTC.

Pour la phase pilote, conservez les métadonnées de fuseau horaire du fournisseur avec chaque série normalisée. Vérifiez une période impliquant des changements d’heure d’été le cas échéant, ainsi que les jours fériés des bourses et les limites de la plage de dates demandée. Ces tests permettent de déterminer si votre importateur affecte les barres aux sessions correctes.

Cette solution mérite d’être explorée lorsqu’une interface commune pour les séries chronologiques est importante. Obtenez néanmoins des réponses explicites concernant le jeu de données, les droits d’accès et l’utilisation autorisée dont votre application a besoin ; ces questions ne peuvent être tranchées par une simple demande de démonstration réussie.

Alpaca : évaluez le flux ainsi que l’API

La documentation de l’API de données de marché d’Alpaca couvre la diffusion via HTTP et WebSocket pour les données de marché historiques et en temps réel. Elle distingue également les modèles d’abonnement « Trading API » et « Broker API ». La documentation précise les différentes couvertures de marché selon les flux et les formules, y compris la couverture des actions exclusivement sur IEX dans la formule « Basic » au moment de la révision.

Cette distinction est importante lors de la comparaison des résultats avec ceux d’un autre fournisseur. Un flux représentant une seule place de marché et un flux combinant plusieurs places de marché peuvent faire état d’une activité différente sans qu’aucune des requêtes n’échoue. Intégrez l’identité du flux dans le modèle de données au lieu de la rejeter une fois l’authentification réussie.

Pour une application combinant des lectures historiques et des mises à jour en continu, créez des prototypes pour les deux cas de figure. Testez la manière dont l’interface gère les déconnexions, la reprise après redémarrage et la transition des données historiques vers les mises à jour actuelles. Ne partez pas du principe qu’un flux reste complet simplement parce que la connexion est restée ouverte.

Privilégiez cette option lorsque son modèle de diffusion documenté et les instruments pris en charge correspondent au produit. Vérifiez le modèle de compte et les droits applicables à l’application en question, en particulier si les données doivent être accessibles à d’autres utilisateurs.

Utilisez une source principale de documents réglementaires lorsque les prix ne sont pas en jeu

Certains flux de travail dépendant de Yahoo nécessitent des états financiers d’entreprise plutôt que des cotations. Pour les données de dépôt des sociétés cotées américaines, les API EDGAR de la SEC exposent l’historique des dépôts et les données XBRL extraites, y compris les informations sur les entreprises. Cela peut constituer une source principale pour un composant de dépôts, parallèlement à un fournisseur distinct de cours de marché.

Ne traitez pas un concept financier comme une simple valeur scalaire intemporelle. Une donnée déclarée comporte une unité, une période, un contexte de dépôt et, éventuellement, un amendement ou un retraitement ultérieur. Un tableau de bord qui sélectionne la dernière valeur numérique sans vérifier ces champs peut comparer des périodes incompatibles ou modifier silencieusement les résultats historiques.

Séparez les adaptateurs de données de dépôt et de données de marché. L’adaptateur de dépôt doit préserver le numéro d’enregistrement et le contexte de déclaration ; l’adaptateur de cours doit préserver le contexte de la bourse, de la séance et du flux de données. Reliez-les via des mappages d’entités validés plutôt que de supposer que tous les identifiants externes sont interchangeables.

Optez pour cette approche lorsque les déclarations primaires répondent plus directement à l’exigence qu’un champ de synthèse précalculé. Cela peut nécessiter davantage de travail d’interprétation ; prévoyez donc le budget nécessaire à l’examen comptable et du modèle de données pour que le résultat soit pertinent.

Rendez la sémantique des prix explicite avant la migration

Les erreurs les plus coûteuses passent souvent inaperçues lors de la validation JSON. Les deux fournisseurs renvoient des chiffres, votre graphique s’affiche correctement, et l’écart n’apparaît que lorsqu’une personne compare un ancien rapport. Évitez cet échec en documentant la signification de chaque champ avant de remplir rétroactivement une nouvelle source.

Dimension

Enregistrez explicitement

Échec de prévention

Instrument

Symbole du fournisseur, bourse, identifiant interne de l’instrument

Regroupement de différentes cotations ayant des symboles similaires

Heure

Date de la séance, horodatage, fuseau horaire, intervalle

Déplacement d’une barre vers un jour de reporting erroné

Ajustement

Base brute ou ajustée et politique applicable

Raccordement de cours historiques incompatibles

Flux

Identifiant de la place de marché ou du flux, le cas échéant

Traitement à égalité de différentes couvertures de marché

Disponibilité

Heure de récupération, statut « périmé », motif des données manquantes

Présentation d’anciennes données comme une mise à jour récente

Veillez à ce que les séries brutes et ajustées restent distinctes. Si la politique du nouveau fournisseur diffère, choisissez soit de conserver des ensembles de données séparés, soit de reconstruire l’historique concerné de manière cohérente. Ne comblez pas les lacunes d’une série avec une autre simplement parce que les deux colonnes portent le même nom close.

Testez les changements de symboles et les instruments inactifs qui ont une incidence sur votre application. Une recherche de symboles actuels ne correspond pas automatiquement à un univers historique complet d’instruments. Notez ce que votre évaluation n’a pas couvert plutôt que de présenter une vérification réussie des symboles courants comme une couverture universelle.

Conservez les valeurs d’origine et les métadonnées lorsque votre contrat autorise leur conservation. Les champs dérivés doivent inclure la version de leur transformation. Cela permet à un autre développeur de remonter d’un point du graphique à sa réponse source et de comprendre si une modification provient du fournisseur, d’une politique d’ajustement ou de votre importateur.

Vérifiez à la fois les droits d’utilisation et les coûts d’exploitation

Une clé API prouve qu’une requête peut être authentifiée ; elle n’établit pas tous les droits dont votre produit a besoin. Confirmez le scénario autorisé, y compris l’analyse interne, l’affichage destiné aux utilisateurs, la redistribution, les résultats dérivés, la conservation, ainsi que le nombre ou le type d’utilisateurs le cas échéant. Demandez au fournisseur de lever toute ambiguïté avant que les décisions d’architecture ne reposent sur une hypothèse.

Évaluez la charge de travail réelle plutôt que la formule la plus petite proposée. Comptez les requêtes d’instruments, la fréquence d’actualisation, les téléchargements d’historique, les tentatives de connexion et les abonnements aux flux selon les unités de facturation du fournisseur. Un point de terminaison par lots peut avoir un mode de facturation différent de celui d’un point de terminaison à symbole unique ; utilisez donc les définitions documentées pour la formule choisie.

Distinguez le remplissage initial des opérations récurrentes. Une migration peut nécessiter beaucoup plus d’historique que ce que l’application récupère normalement en une journée. Planifiez ce travail dans les limites autorisées et estimez le temps nécessaire sans multiplier les tentatives de récupération sur plusieurs couches.

Intégrez les opérations d’ingénierie dans la comparaison : adaptation du schéma, observabilité, réconciliation et réponse aux incidents. La requête la moins chère n’est pas nécessairement le jeu de données utilisable le moins cher si l’intégration nécessite des corrections manuelles récurrentes. À l’inverse, ne payez pas pour une actualité que votre application n’utilise jamais.

Pour une décision plus globale concernant la prise en charge, le guide « Scraper personnalisé ou outils d’extraction » fournit un cadre utile pour choisir entre « construire ou acheter ». Appliquez-le ici en considérant les droits sur les données de marché et la sémantique des flux comme des exigences explicites, et non comme des considérations secondaires.

Effectuez une migration « en parallèle » à l’aide d’un rapport de réconciliation

Mettez en place un adaptateur de fournisseur qui génère le schéma convenu tout en conservant les métadonnées spécifiques à la source. Séparez-le du code consommateur afin qu’une modification de la réponse du fournisseur ne nécessite pas de réécrire chaque graphique ou rapport planifié.

Exécutez le candidat parallèlement au workflow actuel pendant une période représentative. Comparez les mêmes instruments, plages de dates, sessions, devises et bases d’ajustement. Classez les différences en catégories : différences sémantiques attendues, couverture manquante, différences de timing ou défauts présumés. Ne faites pas la moyenne des valeurs conflictuelles pour que la comparaison soit validée.

Vérifiez les règles structurelles telles que les champs obligatoires, les clés de barre en double et les relations OHLC cohérentes pour l’ensemble de données. Ces vérifications permettent de détecter les erreurs d’importation, mais une barre structurellement plausible peut tout de même être incorrecte. Comparez un ensemble sélectionné aux résultats documentés du fournisseur et au contexte source.

Testez délibérément les scénarios d’échec dans votre propre environnement de test : erreurs d’authentification, réponses de limitation de débit, charges utiles mal formées, résultats vides et transmission interrompue. Ne consignez pas les informations confidentielles dans les journaux enregistrés et évitez de consigner les URL de requêtes contenant des identifiants. Définissez dans quels cas le consommateur doit afficher des données obsolètes, un état d’indisponibilité ou une erreur pouvant faire l’objet d’une nouvelle tentative.

Avant la migration, demandez à un utilisateur de parcourir de bout en bout le jeu de données migré. Vérifiez le tri, les libellés de date, les arrondis et les valeurs manquantes dans l’application réelle. Une couche de stockage correcte peut tout de même donner lieu à un graphique trompeur si le code de présentation attribue un fuseau horaire erroné ou comble une lacune sans le signaler.

Pour le contexte issu d’un site web utilisé parallèlement à un flux de données de marché, le guide d’étude de marché sur le web scraping explique pourquoi l’heure d’observation et les limites d’échantillonnage sont importantes. Séparez ce contexte des cotations sous licence plutôt que de mélanger des sources disparates dans un seul champ de prix non explicité.

Points clés à retenir

  • Sélectionnez les fournisseurs en fonction de vos instruments, champs, fraîcheur des données et conditions d’utilisation spécifiques.
  • Faites la distinction entre un changement de « wrapper » et le passage à un autre service de données en amont.
  • Conservez les métadonnées relatives à la session, au flux, à la devise et aux ajustements lors de la normalisation.
  • Utilisez les API de dépôt de documents officiels pour les questions relatives aux dépôts, et non comme substituts aux flux de cours.
  • Effectuez une migration test et expliquez les différences avant de modifier les données fournies aux utilisateurs.

FAQ

Faut-il inclure une clé API dans le code du navigateur ?

Conservez les identifiants confidentiels sur un serveur que vous contrôlez. Exposer un secret dans le code front-end ou dans un dépôt public permet à d’autres personnes de l’utiliser et peut épuiser votre quota. Si un fournisseur propose des identifiants client explicitement publics ou restreints, respectez les consignes d’utilisation documentées. Sinon, acheminez les requêtes via un backend qui applique l’autorisation, la mise en cache et les restrictions d’utilisation des données requises.

Une feuille de calcul peut-elle rester l’interface pour la recherche ?

Oui. Une feuille de calcul peut utiliser une exportation contrôlée tandis que l’intégration stocke la provenance et applique la validation en amont. Incluez des identifiants stables et des métadonnées d’observation afin qu’un utilisateur puisse remonter jusqu’à la source d’une cellule. Définissez la fréquence d’actualisation des exportations et la manière dont les valeurs obsolètes s’affichent ; une feuille de calcul familière ne doit pas masquer les différences entre les données récupérées et les calculs modifiés manuellement.

Chaque interruption de service d’un fournisseur doit-elle déclencher un basculement automatique ?

Non. Un basculement automatique n’est approprié que lorsque l’alternative est approuvée pour le même usage et que la sémantique de ses données est compatible avec celle de l’utilisateur. Sinon, cela peut modifier silencieusement la signification du résultat lors d’un incident. Indiquer clairement un état « indisponible » ou « obsolète » peut s’avérer plus précis que de substituer un autre ensemble de données sans explication.

Conclusion

Le choix des alternatives appropriées à l’API Yahoo Finance dépend de ce que votre application doit garantir concernant ses données. Commencez par une petite liste restreinte, vérifiez le point de terminaison et le flux exacts, et notez les conditions qui rendent deux enregistrements comparables. La migration d’un fournisseur est terminée lorsque le résultat est compréhensible et autorisé pour l’usage prévu, et non lorsque la première requête aboutit.

Choisissez un ensemble d’instruments représentatif, développez un adaptateur et générez un rapport de rapprochement avant de changer de fournisseur. Ce processus met en évidence les lacunes de couverture et les différences sémantiques tant qu’il est encore temps de modifier la conception.

Si l’application a également besoin de contenu Web autorisé au-delà de son flux de données de marché, envisagez l’API Scraper de WebScrapingAPI pour cette tâche de récupération distincte. Veillez à bien délimiter les choses : l’extraction d’une page web ne confère pas les droits d’accès au flux boursier et ne remplace pas un contrat de données de marché sous licence. Votre propre schéma, votre validation et votre traçabilité doivent rester le fondement commun aux deux types d’entrées.

À propos de l'auteur

Raluca Penciuc, Développeur full-stack @ WebScrapingAPI

Raluca Penciuc

Développeur full-stack

Raluca Penciuc est développeuse Full Stack chez WebScrapingAPI ; elle conçoit des robots de collecte de données, améliore les techniques de contournement et recherche des moyens fiables de réduire le risque de détection sur les sites cibles.

Web scraping avec AWS Lambda : guide pour Python et Java 2026
Guides

Web scraping avec AWS Lambda : guide pour Python et Java 2026

TL;DR: En bref : le web scraping avec AWS Lambda fonctionne mieux lorsque chaque invocation est courte, bien délimitée et peut faire l'objet d'une nouvelle tentative de manière indépendante. Commencez par utiliser les requêtes HTTP directes, AWS SAM et S3, puis ajoutez SQS, des conteneurs, le rendu dans un navigateur, des proxys ou une couche de récupération gérée uniquement lorsque la charge de travail démontre qu'elle en a besoin.

Suciu Dan33 min read
Lire l'article
Comment utiliser GoSpider : exploration, nettoyage des URL et extraction de données
Guides

Comment utiliser GoSpider : exploration, nettoyage des URL et extraction de données

TL;DR: En bref : GoSpider est un robot d'exploration en ligne de commande destiné à découvrir des URL, et non un outil complet de collecte de données structurées. Ce guide d'utilisation de GoSpider présente comment effectuer une exploration limitée, gérer correctement les résultats, transférer les données de Colly vers un fichier CSV, ainsi qu'une procédure de diagnostic pour les réponses 403 ou les pages nécessitant un rendu JavaScript.

Suciu Dan24 min read
Lire l'article
Comment récupérer les données de Redfin : Guide Python des données immobilières
Guides

Comment récupérer les données de Redfin : Guide Python des données immobilières

TL;DR: Redfin expose des points d'extrémité d'API cachés qui renvoient du JSON structuré pour les listes de propriétés, ce qui permet d'ignorer complètement l'analyse HTML fragile. Ce guide vous accompagne dans la construction d'un scraper Python qui extrait les données de location et de vente, effectue des recherches par emplacement, surveille les nouvelles inscriptions via des sitemaps XML et exporte des résultats propres au format CSV ou JSON.

Suciu Dan15 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.