
Aller au contenu
Retour au blog

Le web scraping au service des études de marché : guide à l'intention des développeurs

Sergiu InizianDernière mise à jour le 17 min read
Le web scraping au service des études de marché : guide à l'intention des développeurs
En bref : le web scraping permet de transformer les pages publiques de produits en observations reproductibles concernant les prix, l’assortiment et la disponibilité. Une étude de marché utile nécessite un échantillon bien défini, des produits comparables, des horodatages et des contrôles de qualité ; les fiches de produits extraites ne suffisent pas à elles seules à révéler les ventes, la demande ou les parts de marché.

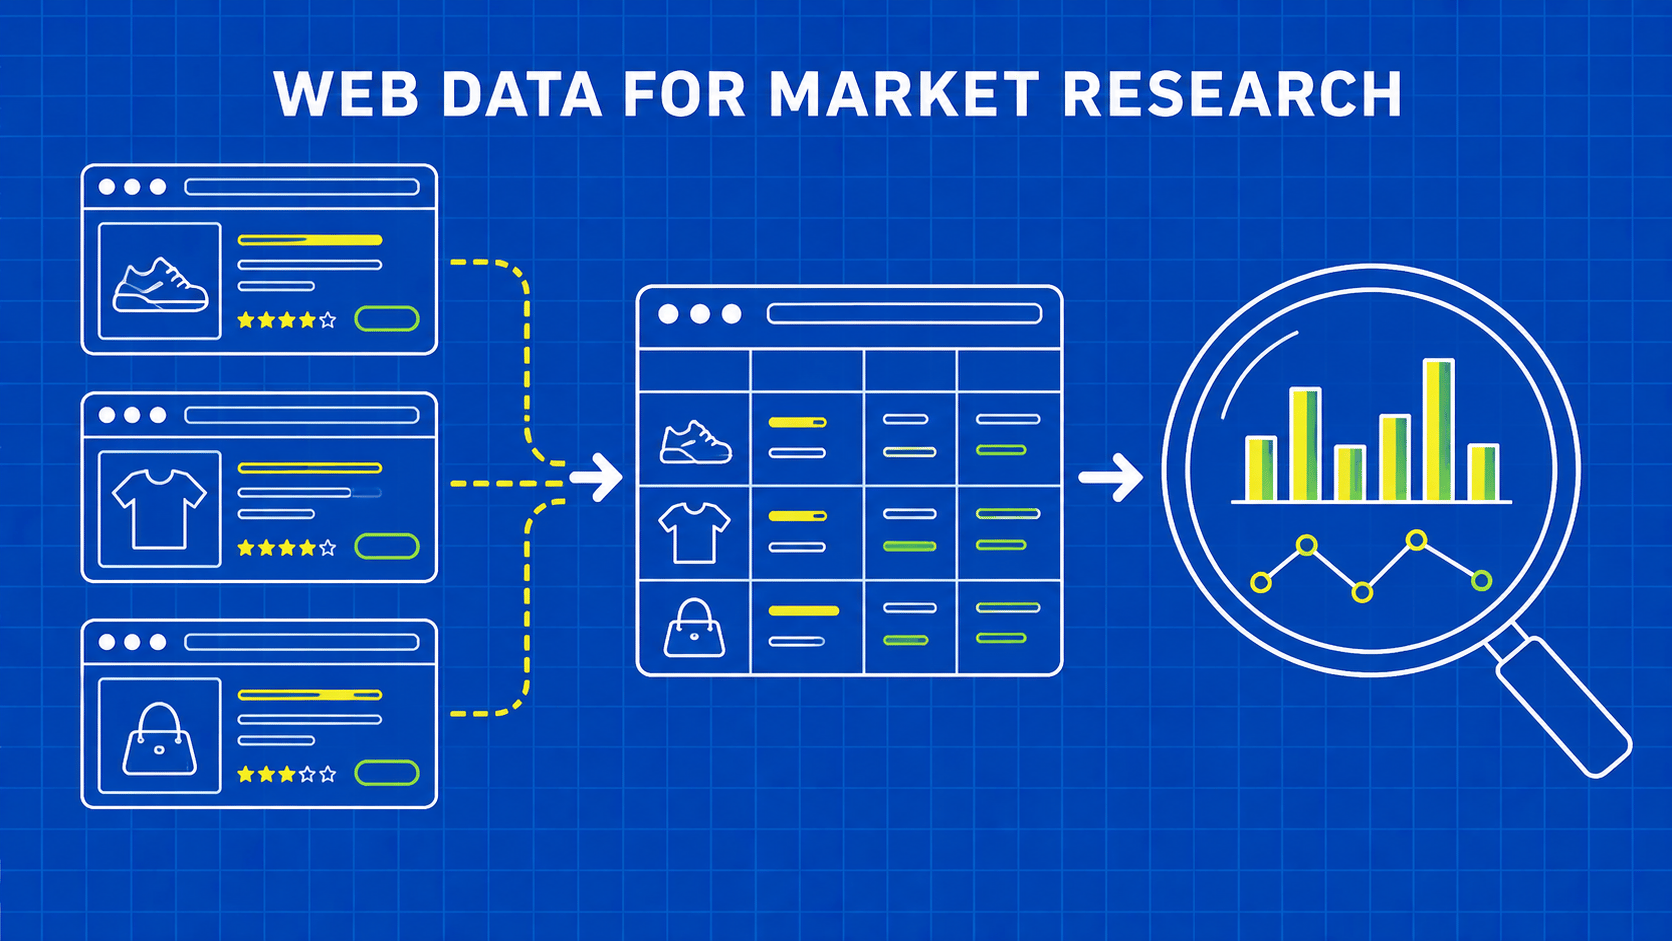
Le web scraping à des fins d’étude de marché consiste à collecter automatiquement des données sur des sites web afin de répondre à une question précise concernant un marché ou ses acteurs. Pour les développeurs, le résultat attendu est un ensemble de données comportant des observations traçables et des limites claires, et non pas simplement une vaste collection de pages.

Prenons l’exemple d’un détaillant comparant ses prix aux offres publiques de ses concurrents. Un tableau de bord peut indiquer que le prix moyen d’un autre détaillant a baissé cette semaine. Cela pourrait refléter de véritables baisses de prix, l’ajout de nouveaux produits moins chers, l’absence de produits coûteux ou encore un analyseur syntaxique qui a commencé à prendre en compte les prix en plusieurs versements. Chaque explication conduit à une décision commerciale différente.

Une recherche fiable distingue ces différentes possibilités avant de présenter une tendance. Vous devez savoir ce que couvre l’échantillon, ce que représente chaque enregistrement et quelles différences sont considérées comme comparables. Une page produit constitue la preuve d’une offre annoncée sous certaines conditions, et non la preuve d’une transaction conclue.

Ce guide se concentre sur l’étude des produits et des prix des concurrents, car cela met clairement en évidence les problèmes de mesure. Vous définirez la question de recherche, concevrez un schéma d’observation, normaliserez les prix sans perdre le contexte et validerez la collecte avant de présenter les résultats. La même rigueur s’applique aux annuaires de services, aux offres d’emploi et à d’autres signaux du marché public.

Commencez le web scraping pour l’étude de marché par une question à laquelle il est possible de répondre

« Surveiller les concurrents » est une formulation trop vague pour être transformée en spécification d’extraction. Remplacez-la par une question telle que : « Comment se comparent les prix livrés annoncés pour des produits correspondants chez ces détaillants pour cette destination ? » Cette phrase identifie les entités, l’indicateur et les conditions importantes avant que vous ne choisissiez une bibliothèque de scraping.

Distinguez les observations des interprétations dans le cahier des charges. Vous pouvez observer un prix affiché, un produit répertorié ou un message de disponibilité. Vous pouvez utiliser ces observations pour analyser un changement concurrentiel, mais des affirmations plus fermes nécessitent des preuves supplémentaires. Le fait qu’un produit disparaisse d’une page ne suffit pas pour conclure qu’il est en rupture de stock ou qu’il a été retiré de la vente.

Question de recherche

Champs observés utiles

Ce que ces champs ne permettent pas d’établir

En quoi les offres comparables diffèrent-elles ?

Identité du produit, prix, devise, conditions de livraison

Prix de transaction réel pour chaque client

Quelles catégories sont répertoriées ?

Références des produits, catégories, vendeur, date d’observation

Volume des ventes ou part de marché

Comment la disponibilité évolue-t-elle ?

Texte relatif à la disponibilité et statut « observation réussie »

Nombre d'unités vendues ou stock en entrepôt

Comment les promotions évoluent-elles ?

Texte de la promotion publique, conditions d’éligibilité, dates de validité

Efficacité de la promotion ou adhésion des clients

Comment l'assortiment évolue-t-il ?

Première et dernière dates d'observation, caractéristiques du produit

Dates définitives de lancement ou d’arrêt

Il ne s’agit pas simplement d’une formulation prudente. L’Office national des statistiques du Royaume-Uni a mis en évidence une limitation majeure de l’étude des prix issue du scraping : les prix affichés ne fournissent pas les quantités achetées nécessaires à la pondération des dépenses. Son étude de 2017 sur les données de prix issues du scraping sur le Web constitue un cadre méthodologique, et non un état des lieux du marché de détail actuel.

Notez la décision visée à côté de la question. Une équipe de merchandising qui compare des assortiments a besoin d’un ensemble de données différent de celui d’un analyste qui mesure les variations de prix comparables. Évitez de collecter des champs supplémentaires sous prétexte qu’ils sont faciles à extraire si personne ne peut expliquer en quoi ils contribuent à la prise de décision.

Concevez un échantillon qui met en évidence ses angles morts

Votre liste de sources définit le marché que vous pouvez réellement observer. Un balayage complet de trois sites web reste un échantillon du marché global. Il exclut d’autres détaillants, les transactions hors ligne et les offres masquées par des conditions ne relevant pas de votre champ de collecte. Le fait de collecter davantage de pages provenant des mêmes sources ne permet pas de pallier ces omissions.

Créez un registre des sources avant la collecte. Notez les détaillants ou plateformes choisis, la zone géographique, les catégories, la méthode d’accès, le responsable de la vérification et les raisons de l’inclusion. Distinguez les sources délibérément exclues de celles qui ont échoué pour des raisons techniques. Sinon, une interruption du pipeline peut modifier silencieusement le marché apparent étudié.

Distinguez la couverture de la réussite de l’extraction

Mesurez la couverture par rapport à un cadre explicite lorsque cela est possible : la liste des détaillants approuvés, les URL de catégories connues ou un panel de produits de référence. Un taux de réponse positif mesure la récupération, et non la couverture. Le robot d’indexation pourrait récupérer toutes les URL demandées tout en ne parvenant pas à découvrir une catégorie entière parce qu’un lien de navigation a changé.

Suivez séparément les produits découverts, les pages demandées, les observations réussies et les enregistrements valides. Conservez la raison de chaque perte. Un produit indisponible, un prix manquant, une requête ayant échoué et un identifiant non correspondant ne doivent pas tous être regroupés dans une ligne vide. Ces distinctions sont essentielles pour expliquer les variations dans l’échantillon final.

Si vous ne pouvez pas estimer la couverture totale, indiquez ce que vous savez. « Offres observées à partir de pages de catégories publiques sélectionnées » est une description défendable. « L’ensemble du marché » ne l’est pas. Documentez les règles de découverte afin qu’un autre développeur puisse reproduire les limites de l’ensemble de données.

Utilisez un panel stable et un flux de découverte

Une conception pratique consiste à conserver un panel de produits fixe à des fins de comparaison tout en exécutant des tâches de découverte distinctes pour les nouvelles annonces. Le panel permet de comparer des articles similaires au fil du temps ; la découverte met en évidence les changements d’assortiment que le panel ne pourrait autrement pas détecter. Publiez leurs chiffres séparément, car ils répondent à des questions différentes.

Réévaluez périodiquement l’échantillon plutôt que de remplacer discrètement les produits manquants. Le renouvellement des produits peut modifier une série de prix même lorsque les prix individuels sont correctement collectés. L’ONS a exploré cette question dans le cadre d’une étude sur les données relatives aux vêtements extraites du Web. Sur le plan technique, cela implique de conserver les décisions d’entrée, de sortie et de mise en correspondance parallèlement aux observations.

Enregistrez les offres sous forme d’observations horodatées

Utilisez des concepts distincts pour un produit, une offre et une observation. Le produit est l’article vendu. L’offre ajoute le vendeur et les conditions commerciales. L’observation enregistre ce que votre collecteur a détecté à un moment donné et dans un contexte spécifique.

Schema.org Product et Schema.org Offer fournissent un vocabulaire utile pour cette distinction, notamment des identifiants de produit et des propriétés d’offre telles que le prix, la devise et la disponibilité. Les données structurées des sites web peuvent constituer une source d’extraction pratique, mais ne partez pas du principe qu’elles correspondent au contenu visible ou qu’elles identifient correctement la variante sélectionnée. Vérifiez des pages représentatives avant de vous y fier.

Groupe de champs

Champs suggérés

Pourquoi est-ce important ?

Provenance

URL source, heure d’observation, ID d’exécution, version du parseur

Reproduire et auditer une observation

Identité du produit

ID du produit source, GTIN le cas échéant, marque, modèle, variante

Comparer ce qui est comparable

Contexte de l'offre

Vendeur, région, devise, état, éligibilité

Éviter de comparer des offres incompatibles

Base de prix

Montant annoncé, frais de port ou statut, base d'imposition

Préciser ce que le prix comprend

Résultat de la collecte

Statut de récupération, statut d'extraction, raisons des champs manquants

Distinguer les valeurs inconnues des modifications réelles

Conservez le texte d’origine du champ parallèlement aux valeurs normalisées lorsque votre politique de conservation approuvée le permet. « À partir de 19,99 », « 19,99 par mois » et « 19,99 » peuvent être normalisés en un même chiffre tout en décrivant des offres différentes. Conserver la preuve d’origine permet d’enquêter sur cette erreur sans partir du principe que la page aura toujours le même aspect par la suite.

Utilisez des horodatages d’observation tenant compte du fuseau horaire et définissez comment une journée de reporting est attribuée. Un prix collecté juste avant minuit dans une région et après minuit dans une autre peut figurer dans des récapitulatifs quotidiens différents. Conservez l’instant réel de la collecte même si le tableau de bord affiche les dates locales.

Traitez les corrections comme des modifications traçables. Si un analyseur syntaxique a attribué les frais de livraison au champ « prix », un ensemble de données corrigé doit enregistrer les exécutions concernées et la version de la transformation. Le fait de remplacer discrètement des observations historiques rend difficile l’explication des modifications apportées au graphique publié la semaine dernière.

Faites correspondre les produits avant de comparer leurs prix

Une correspondance de titre séduisante ne suffit pas à établir l’équivalence des produits. Comparez le modèle, la variante, la quantité par emballage, l’état et le contexte du vendeur avant de considérer deux offres comme des alternatives. Un produit reconditionné, un produit neuf et un lot peuvent partager la plupart de leurs mots visibles tout en représentant des achats différents.

Utilisez des identifiants fiables lorsqu’ils sont disponibles. GS1 décrit les GTIN comme des clés d’identité de produit dans son explication des GTIN et des codes-barres. Conservez les identifiants sous forme de chaînes de caractères, y compris les zéros non significatifs, et vérifiez que le site web associe l’identifiant à la variante pertinente. La présence d’un identifiant ne dispense pas de valider l’association extraite.

En l’absence d’identifiants, utilisez un processus de mise en correspondance par étapes. Normalisez les différences de formatage évidentes, restreignez les candidats par marque et par catégorie, puis comparez les attributs du modèle et de la variante. Enregistrez un statut de correspondance tel que « confirmé », « provisoire » ou « rejeté ». Transmettez les correspondances incertaines pour révision plutôt que de transformer discrètement un score de similarité flou en une équivalence factuelle.

Normaliser les unités et les conditions commerciales

Le prix unitaire permet de comparer les tailles d’emballage, mais uniquement après avoir établi que l’unité a bien la même signification. La comparaison du prix au kilogramme peut s’avérer utile pour des produits emballés équivalents. Elle ne rend toutefois pas les produits identiques lorsque la concentration, la qualité ou les accessoires inclus diffèrent. Conservez les informations d’origine relatives à l’emballage afin que les analystes puissent choisir la comparaison appropriée.

Ne regroupez pas les devises dans une seule colonne numérique pour en calculer une moyenne. Conservez les devises d’origine et, si une conversion est nécessaire, consignez la source du taux de change, l’horodatage et la politique de conversion. Le montant converti est une mesure dérivée et non l’observation d’origine.

Les frais de livraison, les taxes, les conditions d’adhésion et les montants minimaux de panier doivent faire l’objet d’un traitement tout aussi explicite. Des frais de livraison inconnus ne signifient pas que la livraison est gratuite. Un prix réservé aux membres n’est pas un prix public accessible à tous les clients. Comparez soit un scénario éligible commun, soit séparez les cohortes afin que le tableau de bord ne classe pas des offres différentes comme des substituts directs.

Validez la comparabilité des totaux à l’aide d’une petite fonction Python

Effectuez les contrôles de comparabilité avant l'agrégation. L'exemple suivant, issu de la bibliothèque standard, accepte des champs déjà extraits et calcule un total final uniquement lorsque les deux offres portent sur le même produit et reposent sur les mêmes conditions commerciales. Il rejette délibérément les frais de livraison inconnus au lieu de les considérer comme nuls.

Il s’agit d’une étape de validation illustrative, et non d’un outil universel de mise en correspondance de produits ni d’un scraper en temps réel. Ses données d’entrée supposent que vous ayez déjà résolu l’identité, sélectionné l’offre pertinente et normalisé le texte numérique. Utilisez vos règles spécifiques à la source pour la validation de la devise, le traitement fiscal et l’éligibilité.

from decimal import Decimal, InvalidOperation

def amount(value):
    if not isinstance(value, str):
        raise ValueError("Amounts must be normalized decimal strings")
    try:
        parsed = Decimal(value)
    except InvalidOperation as exc:
        raise ValueError("Invalid amount") from exc
    if not parsed.is_finite() or parsed < 0:
        raise ValueError("Amount must be finite and nonnegative")
    return parsed

def delivered_total(offer, expected_basis):
    for field, expected in expected_basis.items():
        if offer.get(field) != expected:
            raise ValueError(f"Incomparable field: {field}")
    if offer.get("shipping_status") != "known":
        raise ValueError("Shipping is unknown")
    return amount(offer.get("price")) + amount(offer.get("shipping"))

basis = {
    "matched_product_id": "widget-blue-small-single",
    "currency": "EUR",
    "condition": "new",
    "tax_basis": "included",
    "destination": "DE",
    "eligibility": "public",
}
offer = {
    **basis,
    "price": "24.90",
    "shipping": "3.50",
    "shipping_status": "known",
}
print(delivered_total(offer, basis))  # 28.40

La documentation de Python sur les nombres décimaux explique l’arithmétique décimale et pourquoi la construction de nombres décimaux à partir de chaînes de caractères diffère de celle à partir de valeurs binaires à virgule flottante. Ici, l’entrée sous forme de chaîne de caractères est intentionnelle. La fonction rejette également les valeurs non finies, car une valeur telle que NaN ne doit pas figurer dans un rapport de tarification.

Étendez les cas de test avant de relier cette étape aux données de production. Incluez les frais de livraison inconnus, les devises non correspondantes, les montants négatifs, les offres indisponibles et les observations en double. Conservez les enregistrements rejetés avec leur motif dans un flux de révision. Les supprimer sans avertissement améliorerait l’apparente propreté de l’ensemble de données tout en masquant la perte de couverture.

Pour la couche de collecte qui fournit ces champs, commencez par la méthode de récupération la plus simple qui expose le contenu requis. Le guide des clients HTTP Python traite de ce choix ; le tutoriel sur les données de prix eBay fournit un exemple spécifique à la plateforme à adapter après avoir examiné vos exigences sources.

Collectez des instantanés reproductibles et détectez les changements dans le pipeline

Choisissez une fréquence adaptée à la question de recherche et à la politique de requêtes autorisée. Les observations fréquentes ne sont utiles que si les détails supplémentaires modifient l’analyse. Un rapport quotidien sur l’assortiment ne nécessite pas automatiquement une récupération minute par minute, en particulier lorsque cela augmente les coûts et complique les contrôles de qualité.

Enregistrez systématiquement le contexte de collecte : région, langue, destination, variante sélectionnée et toutes les conditions pertinentes de l’offre publique. Si ce contexte change, signalez la rupture dans la série. Sinon, un changement de lieu peut être interprété à tort comme une variation des prix de la concurrence.

Constituez un petit ensemble de tests vérifiés couvrant les pages courantes et les cas problématiques. Testez les analyseurs syntaxiques par rapport à ces tests lorsque les sélecteurs ou les dépendances changent. Des vérifications en temps réel confirment ensuite que la structure de la page et les valeurs affichées correspondent toujours à vos hypothèses. Une réponse HTTP réussie ne doit jamais être la seule condition d’acceptation.

Surveillez les taux de champs manquants, les variations inattendues du nombre d’enregistrements, les identifiants en double et les fluctuations de prix anormalement importantes. Ces vérifications doivent déclencher une enquête, et non la suppression automatique des valeurs surprenantes. Les véritables promotions et les bogues d’extraction peuvent se présenter de manière similaire dans un graphique. Comparez les données conservées, les modifications récentes apportées aux analyseurs syntaxiques et les observations voisines avant de déterminer quelle explication est la plus plausible.

Conservez les résultats des nouvelles tentatives séparément des tentatives initiales, et utilisez des clés d’observation stables afin qu’une nouvelle tentative de livraison ne crée pas une deuxième observation de produit. Pour une discussion plus approfondie sur la mise en œuvre, le guide de collecte Scrapy fournit un contexte sur l’exploration.

Vérifiez les autorisations d’accès, les conditions d’utilisation du site et la portée de la collecte avant d’exécuter la tâche. Veillez à ce que l’ensemble de données reste centré sur la question métier et réduisez au minimum les données personnelles non nécessaires. Respectez une politique de requêtes limitées et signalez les conditions d’accès incertaines pour qu’elles soient examinées. Un service de récupération hébergé modifie l’identité de l’opérateur de la couche réseau, mais pas ce que votre projet de recherche est autorisé à collecter.

Rapportez les variations de prix sans inventer de parts de marché

Un rapport utile intègre ses règles de mesure dans le résultat final. Indiquez le panel source, la fenêtre d’observation, le nombre d’enregistrements valides, les produits non appariés et les sources manquantes à côté du graphique principal. Les analystes ne devraient pas avoir à examiner le journal du pipeline pour découvrir qu’un détaillant a disparu de l’échantillon.

Pour les comparaisons de prix, identifiez la cohorte appariée et les conditions dans lesquelles les totaux sont comparables. Si vous présentez une variation en pourcentage, précisez si elle compare les mêmes produits au cours des deux périodes ou des assortiments hebdomadaires différents. Ces mesures répondent à des questions différentes, même lorsque leurs graphiques semblent identiques.

Distinguez les résumés descriptifs d’un indice des prix formel. Une médiane des prix observés ou une variation des produits appariés peut être utile pour la recherche interne, mais elle ne répond pas automatiquement aux exigences méthodologiques d’une mesure de l’inflation. Évitez de qualifier une moyenne simple d’« inflation du marché » ou de la présenter comme représentative des dépenses de consommation.

De même, le nombre d’annonces répertoriées est une mesure de l’assortiment observé, et non de la part de marché. Un détaillant disposant d’un plus grand nombre de pages indexées peut avoir une pagination différente, proposer davantage de variantes ou présenter des offres en double sur la place de marché. La part de chiffre d’affaires nécessite des données probantes appropriées sur les ventes et la taille du marché, au-delà de cet ensemble de données. Veillez à ce que la formulation du rapport reste fidèle à ce que l’étude établit réellement.

Terminez chaque rapport par les questions soulevées par les données plutôt que par des explications non étayées. Une part croissante d’annonces promotionnelles peut justifier l’examen d’une campagne. Cela ne prouve pas pour autant qu’un concurrent subit des pressions financières. Un bon web scraping destiné à l’étude de marché rend ces décisions de suivi plus précises tout en préservant la distinction entre les preuves et l’interprétation.

Si vos résultats doivent devenir du contenu publié, notre guide sur le web scraping pour le marketing de contenu explique comment transformer des observations en recherche originale sans exagérer ce qu'elles démontrent.

Points clés à retenir

  • Définissez une question de recherche à laquelle des observations publiques peuvent répondre, puis documentez les éléments de preuve manquants.
  • Conservez l’identité des produits, les conditions des offres, le contexte de collecte et les horodatages avant d’effectuer des comparaisons.
  • Suivez la couverture de l’échantillon séparément des requêtes abouties et des enregistrements extraits valides.
  • Vérifiez la correspondance, la devise, les unités, les taxes et les frais de livraison avant de classer les prix.
  • Étiquetez avec précision les assortiments et les mesures de prix ; les annonces collectées ne permettent pas d’établir les ventes ni les parts de marché.

FAQ

Les avis clients peuvent-ils être ajoutés à l'ensemble de données de recherche ?

Oui, mais considérez-les comme une source de données distincte, avec ses propres limites d’échantillonnage. Les auteurs d’avis ne sont pas nécessairement représentatifs de l’ensemble des acheteurs, et le texte peut contenir des informations personnelles. Définissez le périmètre de collecte autorisé, réduisez au minimum les identifiants superflus et précisez la plateforme et la période d’observation. Les classifications de sentiment sont des évaluations dérivées ; veillez donc à indiquer la méthode utilisée et le degré d’incertitude plutôt que de les présenter comme des faits directs provenant des clients.

Comment partager les résultats de la recherche avec une autre équipe ?

Fournissez un dictionnaire de données, le périmètre des sources, les horodatages et les limites connues avec les enregistrements. Incluez les règles relatives aux valeurs manquantes, à la mise en correspondance des produits et à tout champ dérivé afin qu’un autre analyste puisse reproduire le résultat. Une exportation versionnée est plus facile à auditer qu’une feuille de calcul dont les valeurs changent sans préavis. Indiquez clairement qui est le responsable en cas de questions concernant l’interprétation ou les corrections.

L’IA peut-elle classer les produits en catégories d’étude ?

Oui, mais évaluez ses étiquettes par rapport à un échantillon validé avant de les utiliser dans des agrégats. Conservez la définition de la catégorie, la version du modèle ou de la règle, ainsi que les affectations incertaines, à disposition pour inspection. Un changement de classification peut déplacer des produits d’un groupe à l’autre et modifier les tendances rapportées, même lorsque les données sources restent inchangées. Utilisez un processus de validation distinct pour les catégories nouvelles ou ambiguës.

Conclusion

Le web scraping pour les études de marché fonctionne mieux lorsque vous concevez la mesure avant de mettre en place le collecteur de données. Définissez la question, choisissez un panel de sources défendable et préservez la distinction entre les produits, les offres et les observations. Validez la comparabilité avant de calculer une différence de prix, et mettez en évidence les lacunes de couverture au lieu de les dissimuler dans un graphique attrayant.

Commencez par une seule catégorie et un petit panel validé. Vérifiez que les enregistrements permettent de répondre à la question posée, effectuez la collecte sur plusieurs observations successives et analysez les échecs avant d’élargir la liste des sources. Développer un schéma ambigu ne fait que produire un ensemble de données ambigu plus volumineux.

Si la récupération des pages détourne votre attention de ce travail d’analyse, envisagez d’utiliser l’API Scraper de WebScrapingAPI comme composant de récupération, tout en veillant à ce que vos définitions de recherche et vos règles de validation restent explicites. La valeur d’un pipeline finalisé ne réside pas dans la quantité de données qu’il collecte. Elle réside dans la capacité d’un autre développeur ou analyste à examiner un résultat, à en comprendre les limites et à prendre une décision éclairée à partir des éléments disponibles.

À propos de l'auteur

Sergiu Inizian, Rédacteur de contenu technique @ WebScrapingAPI

Sergiu Inizian

Rédacteur de contenu technique

Sergiu Inizian est rédacteur technique chez WebScrapingAPI ; il rédige des contenus clairs et pratiques qui aident les développeurs à comprendre le produit et à l'utiliser efficacement.

Alternative Data Scraping for Finance : Comment les données Web donnent un avantage aux investisseurs
Cas d'utilisation

Alternative Data Scraping for Finance : Comment les données Web donnent un avantage aux investisseurs

TL;DR: Le scraping de données alternatives utilise des techniques de collecte sur le web pour rassembler des ensembles de données non traditionnelles (prix des produits, sentiments, offres d'emploi, dépôts réglementaires) qui révèlent les signaux du marché avant qu'ils n'apparaissent dans les rapports sur les bénéfices. Ce guide vous présente les sources de données les plus précieuses, la manière de construire des pipelines de qualité financière, la validation de la qualité des données et les garde-fous de la conformité dont vous avez besoin pour rester du bon côté de la loi.

Mihnea-Octavian Manolache20 min read
Lire l'article
Qu'est-ce que les données financières ? Types, méthodes de collecte et outils d'analyse
Cas d'utilisation

Qu'est-ce que les données financières ? Types, méthodes de collecte et outils d'analyse

TL;DR: Les données financières sont la collection d'enregistrements quantitatifs (revenus, dépenses, actifs, passifs, flux de trésorerie) que les organisations et les individus utilisent pour prendre des décisions économiques éclairées. Ce guide présente les quatre principaux états financiers, compare les sources de données traditionnelles et alternatives, présente les méthodes de collecte modernes et couvre les outils utilisés par les professionnels pour l'analyse.

Suciu Dan16 min read
Lire l'article
Sélecteurs XPath et CSS : Choisir le bon
Cas d'utilisation

Sélecteurs XPath et CSS : Choisir le bon

TL;DR: XPath et les sélecteurs CSS localisent tous deux des éléments du DOM, mais ils résolvent des problèmes différents. Les sélecteurs CSS sont plus rapides et plus lisibles pour les sélections simples. XPath l'emporte lorsque vous devez parcourir le DOM dans n'importe quelle direction, faire correspondre du contenu textuel ou gérer une logique conditionnelle complexe. La plupart des projets de production bénéficient de l'utilisation des deux stratégies.

Mihai Maxim16 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.