
Aller au contenu
Retour au blog

Screen scraping de sites web avec Playwright

Raluca PenciucDernière mise à jour le 14 min read
Screen scraping de sites web avec Playwright
En bref : le « screen scraping » consiste à extraire des informations de la couche de présentation d’un site web. Pour les pages web classiques, lisez d’abord le DOM rendu avant d’envisager le recours à des captures d’écran et à la reconnaissance optique de caractères (OCR) ; validez ensuite les enregistrements et vérifiez que la collecte a atteint un point d’arrêt défini.

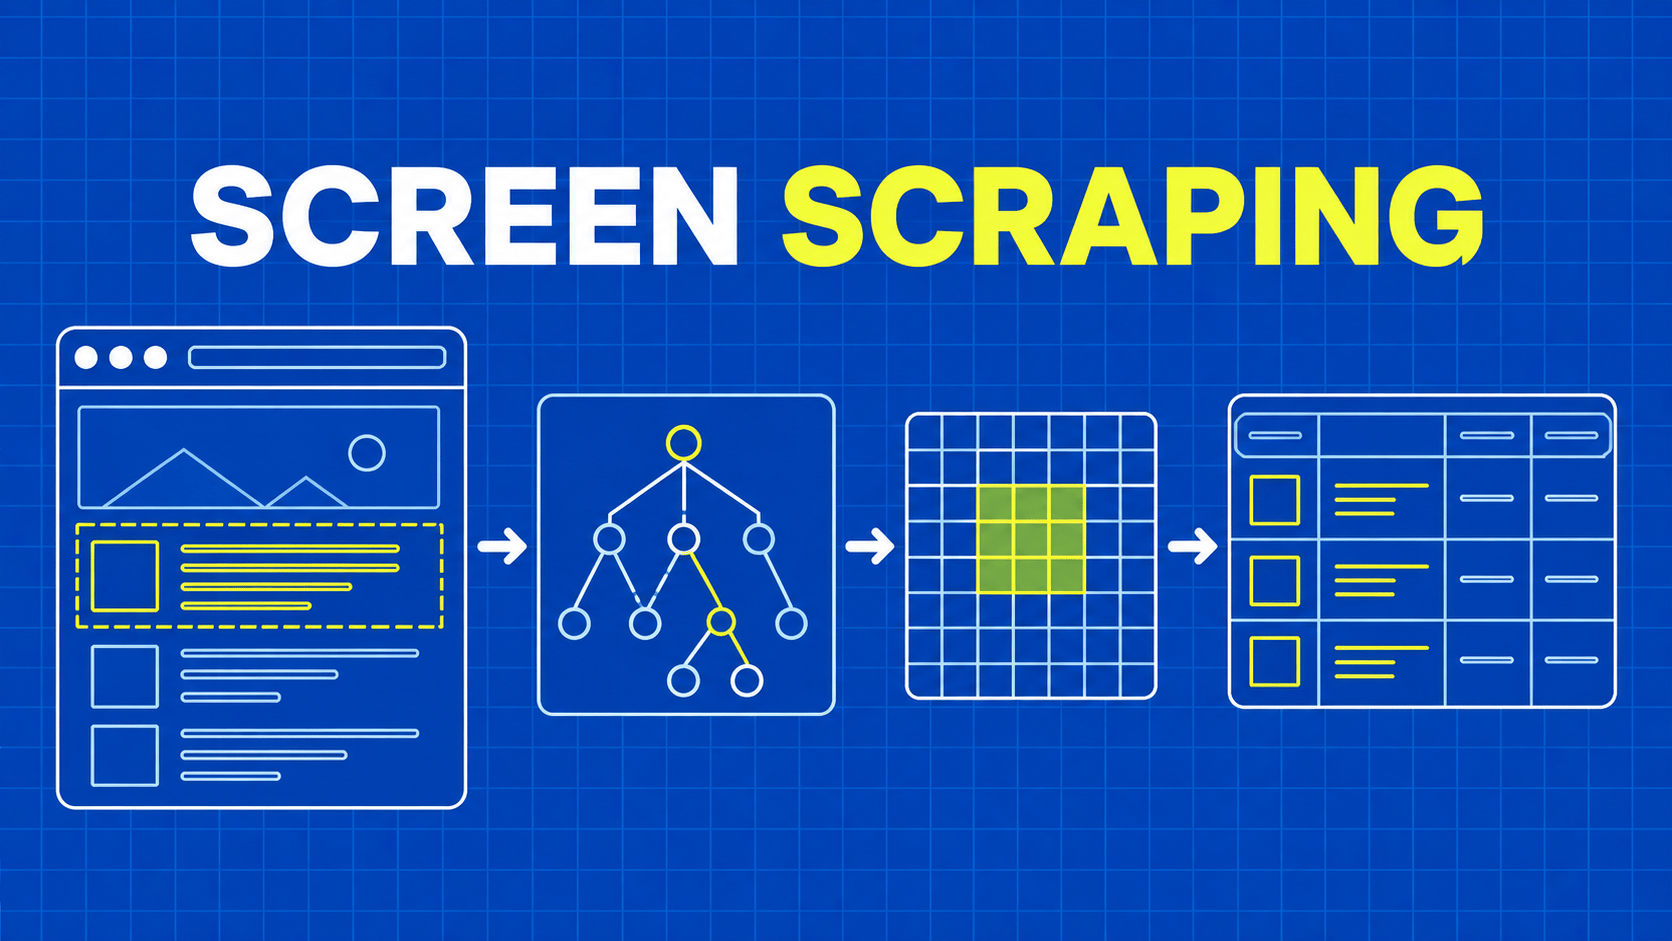
Une fiche produit affiche un nom et un prix, mais le code HTML téléchargé par votre script ne contient qu’un conteneur vide. Le « screen scraping » comble cette lacune en collectant les données de la page une fois que le navigateur a effectué le travail nécessaire à son affichage. Le défi pratique consiste à déterminer quelle représentation contient les informations dont vous avez besoin et à quel moment cette représentation est prête.

Cette expression peut également désigner la lecture de pixels à partir de captures d’écran. Il s’agit là de problèmes techniques différents. Un navigateur peut exposer des éléments structurés, des attributs et du texte sans reconnaître aucune image. L’OCR part des pixels et estime quels caractères ils contiennent, perdant ainsi bon nombre des relations déjà fournies par le HTML.

Ce guide propose un petit exercice d’extraction contrôlée à partir d’un navigateur, puis étend ce raisonnement à de véritables missions de collecte de données. Vous définirez un enregistrement, choisirez des repères, attendrez qu’un état significatif soit atteint, identifierez les résultats incomplets et conserverez les preuves en cas d’échec de l’extraction. L’exemple utilise une page créée au sein même du navigateur ; il ne dépend donc pas d’un site web tiers et ne génère pas de trafic vers celui-ci. N’appliquez ce même processus qu’aux pages et aux données que vous êtes autorisé à collecter.
Choisissez la bonne couche pour le scraping d’écrans de sites web

Commencez par un seul champ obligatoire, tel que le prix affiché actuel. Vérifiez où il se trouve avant de choisir un outil. Il peut être présent dans le code HTML initial, inséré dans le DOM après l’exécution de JavaScript, affiché sur un canevas ou inclus dans une exportation autorisée. Chaque possibilité modifie la méthode de collecte la plus simple et la plus fiable.

Représentation disponible

Approche utile

Principale contrainte à vérifier

API documentée ou exportation

Utilisez l’interface structurée prise en charge

Couverture, périmètre d’accès et fréquence d’actualisation

HTML de la réponse initiale

Analyser le document téléchargé

Les données peuvent n'apparaître qu'après le rendu

DOM rendu

Utiliser un navigateur et des localisateurs de portée

État de préparation et modification de la structure de présentation

Texte sur un canevas ou une image

Utiliser des techniques approuvées d’extraction d’images et de reconnaissance optique de caractères (OCR)

Erreurs de reconnaissance et relations perdues

Le « screen scraping » de sites web ne nécessite pas de capture d’écran. Si un prix est un nœud de texte à l’intérieur d’une fiche produit, l’extraction de ce nœud préserve sa relation avec la fiche. Découper ce même prix dans une image entraîne un surcroît de travail : choisir un cadrage, reconnaître les caractères, associer le résultat au bon produit et détecter les résultats incertains.

Un analyseur HTTP reste un bon point de départ lorsque le document initial contient les champs requis. Notre guide sur les clients HTTP Python explique la couche de requête qui précède l’analyse. Un navigateur s’avère utile lorsque la tâche de collecte dépend de l’exécution de la page ou d’interactions autorisées, telles que la sélection d’un onglet.

Considérez ce choix comme une expérience. Récupérez un exemple autorisé à l’aide de la méthode la plus simple, comparez ses champs avec la page visible et consignez la différence. N’optez pas pour l’automatisation via un navigateur simplement parce qu’un site utilise du JavaScript à un endroit ou à un autre. À l’inverse, une réponse HTTP réussie ne prouve pas que celle-ci inclut les données souhaitées.

Conservez la représentation source dans les métadonnées de sortie. Un enregistrement obtenu à partir de texte affiché et un enregistrement déduit d’une image peuvent avoir des exigences de vérification différentes, même lorsque leurs valeurs finales semblent identiques.

Définissez les enregistrements avant d’écrire les actions du navigateur

Précisez ce que signifie chaque ligne. Pour une observation de catalogue, un enregistrement utile peut contenir l’identifiant source du produit, le nom affiché, le texte brut du prix, la devise, l’URL de la page, l’heure de l’observation et la version d’extraction. Déterminez quels champs sont obligatoires et lesquels peuvent légitimement manquer avant de lancer le navigateur.

Le scraping de sites web devient fragile lorsque les sélecteurs déterminent le schéma de manière silencieuse. Un nœud de prix manquant ne doit pas automatiquement prendre la valeur zéro. Un prix portant la mention « à partir de » ne doit pas devenir un prix exact sans conserver ce qualificatif. Une fiche produit apparaissant deux fois dans des carrousels distincts ne doit pas automatiquement créer deux produits différents.

Conservez le texte brut parallèlement aux valeurs normalisées lorsque cette distinction est importante. Par exemple, stockez « 1 249,00 € » comme texte observé et ne déduisez le montant numérique qu’à l’aide d’une règle de localisation connue. Deviner les conventions de ponctuation peut transformer un prix valide en une valeur erronée de plusieurs ordres de grandeur. L’observation brute vous permet de corriger la transformation sans avoir à revisiter la page.

Choisissez une identité d’enregistrement indépendamment de l’ordre visuel. Un identifiant source est préférable lorsque la page en fournit un dans une représentation autorisée. Une URL canonique de produit peut convenir lorsque ses règles d’identité sont bien comprises. La troisième fiche sur la page ne constitue pas une identité stable, car le tri, les recommandations et les changements d’inventaire peuvent tous la déplacer.

Définissez également le contexte de capture. La fenêtre d’affichage, la langue, le compte et les filtres sélectionnés peuvent affecter le résultat affiché. Lorsqu’un compte autorisé est impliqué, gérez explicitement les cookies HTTP et la propriété de la session. Ne partagez pas une session entre des tâches client sans rapport simplement parce que cela fonctionne déjà.

Une règle d’acceptation utile se présente comme un test : chaque fiche acceptée possède un identifiant et un nom non vides, le texte du prix est conservé mot pour mot, les identifiants en double sont classés, et l’exécution enregistre si elle s’est terminée. Cela fournit aux sites web utilisant le screen scraping une condition de réussite observable allant au-delà de « le script s’est terminé sans générer d’exception ».

Extraire un élément rendu avec Playwright

Cet exercice crée deux produits fictifs après un court délai asynchrone, marque le catalogue comme prêt et extrait des enregistrements structurés. Installez Playwright dans un projet Node.js jetable, installez son navigateur Chromium, puis enregistrez le code JavaScript sous forme de module ES, par exemple collect.mjs. L’exemple ne contient aucune requête API, aucun identifiant ni aucune cible externe.

import assert from 'node:assert/strict';
import { chromium } from 'playwright';

const browser = await chromium.launch();
try {
  const page = await browser.newPage();
  await page.setContent(`
    <main id="catalog" data-ready="false"></main>
    <script>
      setTimeout(() => {
        document.querySelector('#catalog').innerHTML =
          '<article data-id="p1"><h2>Desk lamp</h2>' +
          '<span class="price">EUR 24.00</span></article>' +
          '<article data-id="p2"><h2>Notebook</h2>' +
          '<span class="price">EUR 6.50</span></article>';
        document.querySelector('#catalog').dataset.ready = 'true';
      }, 30);
    </script>
  `);
  await page.locator('#catalog[data-ready="true"]').waitFor();
  const records = await page.locator('#catalog article').evaluateAll(
    cards => cards.map(card => ({
      id: card.getAttribute('data-id'),
      name: card.querySelector('h2')?.textContent?.trim() ?? '',
      priceText: card.querySelector('.price')?.textContent?.trim() ?? ''
    }))
  );
  assert.deepEqual(records, [
    { id: 'p1', name: 'Desk lamp', priceText: 'EUR 24.00' },
    { id: 'p2', name: 'Notebook', priceText: 'EUR 6.50' }
  ]);
  console.log(JSON.stringify(records, null, 2));
} finally {
  await browser.close();
}

L’élément important est le contrat de disponibilité, et non le délai utilisé pour simuler le travail. Le collecteur attend un attribut indiquant que le fixture a fini d’insérer ses enregistrements. Il ne part jamais du principe que trente millisecondes suffiront également sur un site web réel. L’assertion vérifie l’ensemble du résultat, y compris le nombre d’enregistrements et leurs associations.

L’API « page » de Playwright documente la configuration du contenu d’une page, tandis que son API « locator » documente l’évaluation des éléments correspondants. Le callback s’exécute dans le contexte de la page et renvoie des données brutes. Les objets DOM du navigateur ne deviennent pas en eux-mêmes des enregistrements durables de l’application.

Pour le scraping de sites web en pratique, remplacez le fixture par une navigation vers une page approuvée et remplacez son indicateur de disponibilité par des preuves spécifiques à cette page. Conservez l’étape de validation. Un premier test négatif utile consiste à supprimer un élément de prix et à vérifier que votre validateur de production rejette ou met en quarantaine la ligne incomplète plutôt que de la publier comme un résultat normal.

Le fixture est volontairement suffisamment simple pour être compris. Il n’inclut pas de planification, de stockage persistant ni de robot d’indexation généraliste. Notre guide plus complet sur le scraping avec Playwright fournit des informations supplémentaires sur le flux de travail du navigateur lorsque vous êtes prêt à aller au-delà d’une simple extraction.

Rendez explicites l’état de préparation et les sélecteurs

Une page peut avoir fini de charger son document avant que ses données utiles n’arrivent. Elle peut également maintenir des connexions réseau ouvertes alors que les données requises sont déjà disponibles. Le scraping de sites web nécessite une condition liée à la tâche de collecte, telle qu’un en-tête de résultats associé à un indicateur de chargement terminé, plutôt qu’une pause arbitraire.

Pour une action interactive, localisez le contrôle à l’aide d’une propriété stable et limitez la portée à la zone concernée. Une page peut contenir plusieurs boutons « Suivant » dans les galeries de produits, les résultats de recherche et le contenu associé. Cliquer sur le premier texte correspondant ne suffit pas à prouver que le collecteur a fait avancer la liste souhaitée. Playwright recommande d’utiliser des attributs visibles par l’utilisateur et des contrats explicites dans ses recommandations relatives à la localisation.

Distinguez l’état de préparation à l’action de l’exhaustivité de l’ensemble de données. Le fait qu’un bouton soit visible et cliquable ne signifie pas que toutes les lignes de résultats sont présentes. Après le clic, vérifiez que le marqueur de page ou l’ensemble d’enregistrements résultant a changé et que la condition d’achèvement spécifique à la page est remplie. Si vous gérez l’application source, l’ajout d’un attribut de préparation stable rend ce contrat vérifiable.

Choisissez délibérément l’extraction de texte. MDN décrit `innerText` comme tenant compte de l’apparence rendue, tandis que `textContent` lit le texte du nœud sans tenir compte de ce rendu. Aucun des deux ne constitue une définition automatique du champ métier. Extrayez à partir d’un élément de prix spécifique plutôt que de lire une carte entière en espérant séparer les libellés ultérieurement.

Par exemple, une fiche peut contenir le prix actuel, un prix barré, un texte de livraison et une étiquette d’accessibilité masquée. Une extraction de texte trop large peut regrouper ces quatre éléments. Déterminez si l’enregistrement a besoin du prix actuel affiché, du prix d’origine ou des deux, puis utilisez des champs nommés et des localisateurs distincts.

Lorsqu’un sélecteur échoue, signalez clairement l’échec. Évitez une chaîne de repli qui s’élargit progressivement jusqu’à trouver du texte sans rapport. Lors du scraping de sites web, une erreur claire de champ manquant est plus facile à corriger qu’une exécution réussie remplie de valeurs plausibles mais incorrectes.

Vérifiez que la pagination et le défilement sont complets

Dix fiches correctes provenant de la première page constituent toujours un ensemble de données incomplet lorsque la tâche requiert l’intégralité de la catégorie. Définissez une condition d’arrêt avant d’introduire une boucle. Pour les pages paginées, il peut s’agir d’un indicateur de dernière page documenté ou d’un bouton « Suivant » désactivé. Pour une interface « Charger plus » validée, il peut s’agir d’un marqueur de fin explicite.

Le scraping de sites web à défilement infini nécessite une attention particulière, car certaines listes virtualisent leur contenu. Elles réutilisent un petit groupe de nœuds DOM à mesure que le lecteur parcourt une collection plus vaste. Compter les éléments actuellement présents dans le document peut donc sous-estimer le nombre d’enregistrements apparus, et prendre un dernier instantané du DOM peut faire passer à côté d’enregistrements antérieurs.

Collectez chaque lot une fois que sa condition de disponibilité est remplie, en utilisant l’identité de la source pour dédupliquer les observations. Suivez les identifiants déjà acceptés, le dernier marqueur de navigation et le nombre de tentatives consécutives n’ayant pas généré de nouveaux identifiants. Considérez une limite d’absence de progression comme un arrêt de sécurité avec un statut « incomplet », à moins que la source ne fournisse également une condition de fin fiable.

Recourez à un travail délimité même lorsque l’interface semble infinie. Définissez un nombre maximal de pages, un temps écoulé et un nombre d’enregistrements adaptés à la tâche. Enregistrez quelle limite a mis fin à l’exécution. « Arrêté après le budget de pages configuré » et « a atteint la dernière page de la source » ont des significations différentes pour les utilisateurs en aval.

Enregistrez des points de contrôle une fois que les données acceptées ont été stockées de manière durable. Si un processus plante entre la collecte et la persistance, la reprise à partir d’un curseur enregistré trop tôt peut entraîner le saut de certains enregistrements. La relecture d’une page est plus sûre lorsque votre récepteur effectue la déduplication selon une identité stable et une politique d’observation.

Pour un catalogue évolutif, l’exhaustivité est également temporelle. Les éléments peuvent se déplacer d’une page à l’autre pendant que l’exécution est active. Enregistrez la fenêtre de collecte et évitez de qualifier la sortie d’« instantané exact », à moins que la source ne fournisse cette garantie. Une tâche d’observation quotidienne peut être utile sans prétendre décrire un état instantané.

Ces limites transforment le « screen scraping » de sites web, qui n’est plus une simple macro de navigateur, en un processus de collecte dont les limites peuvent être expliquées et testées.

N’utilisez les captures d’écran et l’OCR que lorsque les pixels ont de l’importance

Une capture d’écran constitue une preuve utile lorsque la présentation visuelle fait elle-même partie de la question. Elle peut montrer un prix manquant, une boîte de dialogue inattendue ou une mise en page qui ne correspond plus au contrat d’extraction. Playwright prend en charge les captures de pages et d’éléments via son interface de capture d’écran.

L’OCR est une transformation distincte appliquée à cette image. Envisagez-le lorsque des informations autorisées ne sont réellement disponibles que sous forme de pixels, comme du texte dessiné sur un canevas, et qu’il n’existe aucune représentation structurée adaptée. Ne l’utilisez pas pour résoudre des problèmes d’accès ou contourner un refus d’accès d’un site. Arrêtez-vous et résolvez les problèmes d’autorisation ou d’accès auprès du propriétaire.

L’extraction de données à partir de sites web via l’OCR nécessite une politique de tolérance à l’incertitude. Des caractères similaires, la ponctuation décimale, le texte tronqué et un faible contraste peuvent altérer le résultat. Une chaîne de caractères validée par un analyseur numérique de base peut tout de même représenter un prix erroné. Conservez ensemble la zone d’image concernée, le texte reconnu, la version de la transformation et tout signal de confiance disponible.

Vérifiez les champs à fort impact par rapport à une contrainte indépendante. Un montant en devise reconnu peut nécessiter à la fois une désignation de devise connue et un format cohérent. Un identifiant de produit peut avoir une longueur fixe ou une somme de contrôle. Ces vérifications permettent de détecter certaines erreurs, mais elles ne prouvent pas qu’un résultat plausible corresponde à l’image source.

Pour les captures d’écran utilisées comme éléments de débogage, recadrez-les à la zone pertinente et limitez leur conservation. L’accès autorisé à une page ne signifie pas que chaque détail de compte visible doive figurer dans une archive diagnostique permanente. Consignez la raison pour laquelle l’image a été capturée, restreignez l’accès et supprimez-la lorsque l’enquête n’en a plus besoin.

La même prudence s’applique aux instantanés HTML : des champs masqués et du contenu spécifique au compte peuvent être présents même si la capture d’écran semble inoffensive. Ne conservez que le minimum de preuves nécessaires pour reproduire le problème d’extraction.

Points clés à retenir

  • Inspectez la représentation source avant de choisir un outil. Le code HTML initial, le DOM rendu et les pixels d’image nécessitent des stratégies d’extraction et de validation différentes.
  • Assurez-vous que la préparation corresponde aux données dont vous avez besoin, et validez l’enregistrement extrait dans son intégralité plutôt que de vous contenter de vérifier que l’action du navigateur a abouti.
  • Définissez l’identité, la fin de la pagination, le moment des points de contrôle et les statuts d’exécution incomplète avant d’étendre un collecteur au-delà d’une page.
  • Conservez les observations brutes lorsque la normalisation peut en modifier le sens. Utilisez les captures d’écran de manière sélective et appliquez des règles de révision explicites aux résultats de l’OCR.

FAQ

Les extensions de navigateur peuvent-elles constituer un outil de prototypage utile ?

Oui. Une extension peut vous aider à inspecter une page ou à tester une idée d’extraction à petite échelle avant de créer un collecteur planifié. Évaluez son accès aux données et son comportement d’exportation avant de l’installer dans un navigateur authentifié. Même un prototype manuel réussi nécessite des entrées reproductibles, une validation et une prise en charge opérationnelle avant de devenir une tâche de production fiable.

Le texte extrait doit-il être traduit lors de la collecte ?

Conservez généralement la langue d’origine dans l’enregistrement brut et effectuez la traduction lors d’une étape distincte. La traduction modifie l’observation et peut compliquer les comparaisons entre les exécutions. Stockez séparément la langue source, le résultat traduit et la version de la transformation afin qu’une correction de la traduction ne nécessite pas de nouvelle consultation de la page source.

Comment une équipe doit-elle transférer un collecteur existant ?

Fournissez le contrat d’extraction, un petit test approuvé, le résultat attendu et des exemples d’échecs classés. Précisez qui détient l’accès à la source et quelles tâches en aval exploitent le résultat. Le prochain responsable de la maintenance doit être capable de reproduire une extraction réussie et de reconnaître une exécution incomplète sans avoir à se fier à l’historique de navigation de l’auteur d’origine.

Construisez un collecteur produisant un résultat explicable

La première étape utile dans le scraping de sites web consiste à obtenir un enregistrement validé dont la provenance est connue. Commencez par là, puis ajoutez la navigation, la persistance et la planification uniquement lorsque leurs conditions de réussite sont tout aussi claires. Vous devriez être capable d’expliquer d’où provient chaque champ, pourquoi la page était prête et ce qui a provoqué l’arrêt de l’exécution.

Avant un déploiement à plus grande échelle, testez un champ manquant, une page répétée et un changement de source ne produisant aucun nouvel enregistrement. Vérifiez que ces scénarios conduisent à des classifications explicites plutôt qu’à des rapports de réussite vides. Ce petit ensemble d’échecs révèle souvent si votre workflow repose sur un véritable contrat de données ou simplement sur une séquence d’actions du navigateur.

Si l’exploitation de l’infrastructure de navigateur devient le facteur limitant de votre workflow de collecte autorisé, évaluez l’API de navigateur de WebScrapingAPI pour le contrôle des navigateurs hébergés. Maintenez votre schéma d’enregistrement, vos règles de disponibilité et votre validation indépendamment du choix de l’infrastructure afin qu’ils restent vérifiables à mesure que le système se développe.

À propos de l'auteur

Raluca Penciuc, Développeur full-stack @ WebScrapingAPI

Raluca Penciuc

Développeur full-stack

Raluca Penciuc est développeuse Full Stack chez WebScrapingAPI ; elle conçoit des robots de collecte de données, améliore les techniques de contournement et recherche des moyens fiables de réduire le risque de détection sur les sites cibles.

Web scraping avec AWS Lambda : guide pour Python et Java 2026
Guides

Web scraping avec AWS Lambda : guide pour Python et Java 2026

TL;DR: En bref : le web scraping avec AWS Lambda fonctionne mieux lorsque chaque invocation est courte, bien délimitée et peut faire l'objet d'une nouvelle tentative de manière indépendante. Commencez par utiliser les requêtes HTTP directes, AWS SAM et S3, puis ajoutez SQS, des conteneurs, le rendu dans un navigateur, des proxys ou une couche de récupération gérée uniquement lorsque la charge de travail démontre qu'elle en a besoin.

Suciu Dan33 min read
Lire l'article
Comment utiliser GoSpider : exploration, nettoyage des URL et extraction de données
Guides

Comment utiliser GoSpider : exploration, nettoyage des URL et extraction de données

TL;DR: En bref : GoSpider est un robot d'exploration en ligne de commande destiné à découvrir des URL, et non un outil complet de collecte de données structurées. Ce guide d'utilisation de GoSpider présente comment effectuer une exploration limitée, gérer correctement les résultats, transférer les données de Colly vers un fichier CSV, ainsi qu'une procédure de diagnostic pour les réponses 403 ou les pages nécessitant un rendu JavaScript.

Suciu Dan24 min read
Lire l'article
Comment récupérer les données de Redfin : Guide Python des données immobilières
Guides

Comment récupérer les données de Redfin : Guide Python des données immobilières

TL;DR: Redfin expose des points d'extrémité d'API cachés qui renvoient du JSON structuré pour les listes de propriétés, ce qui permet d'ignorer complètement l'analyse HTML fragile. Ce guide vous accompagne dans la construction d'un scraper Python qui extrait les données de location et de vente, effectue des recherches par emplacement, surveille les nouvelles inscriptions via des sitemaps XML et exporte des résultats propres au format CSV ou JSON.

Suciu Dan15 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.