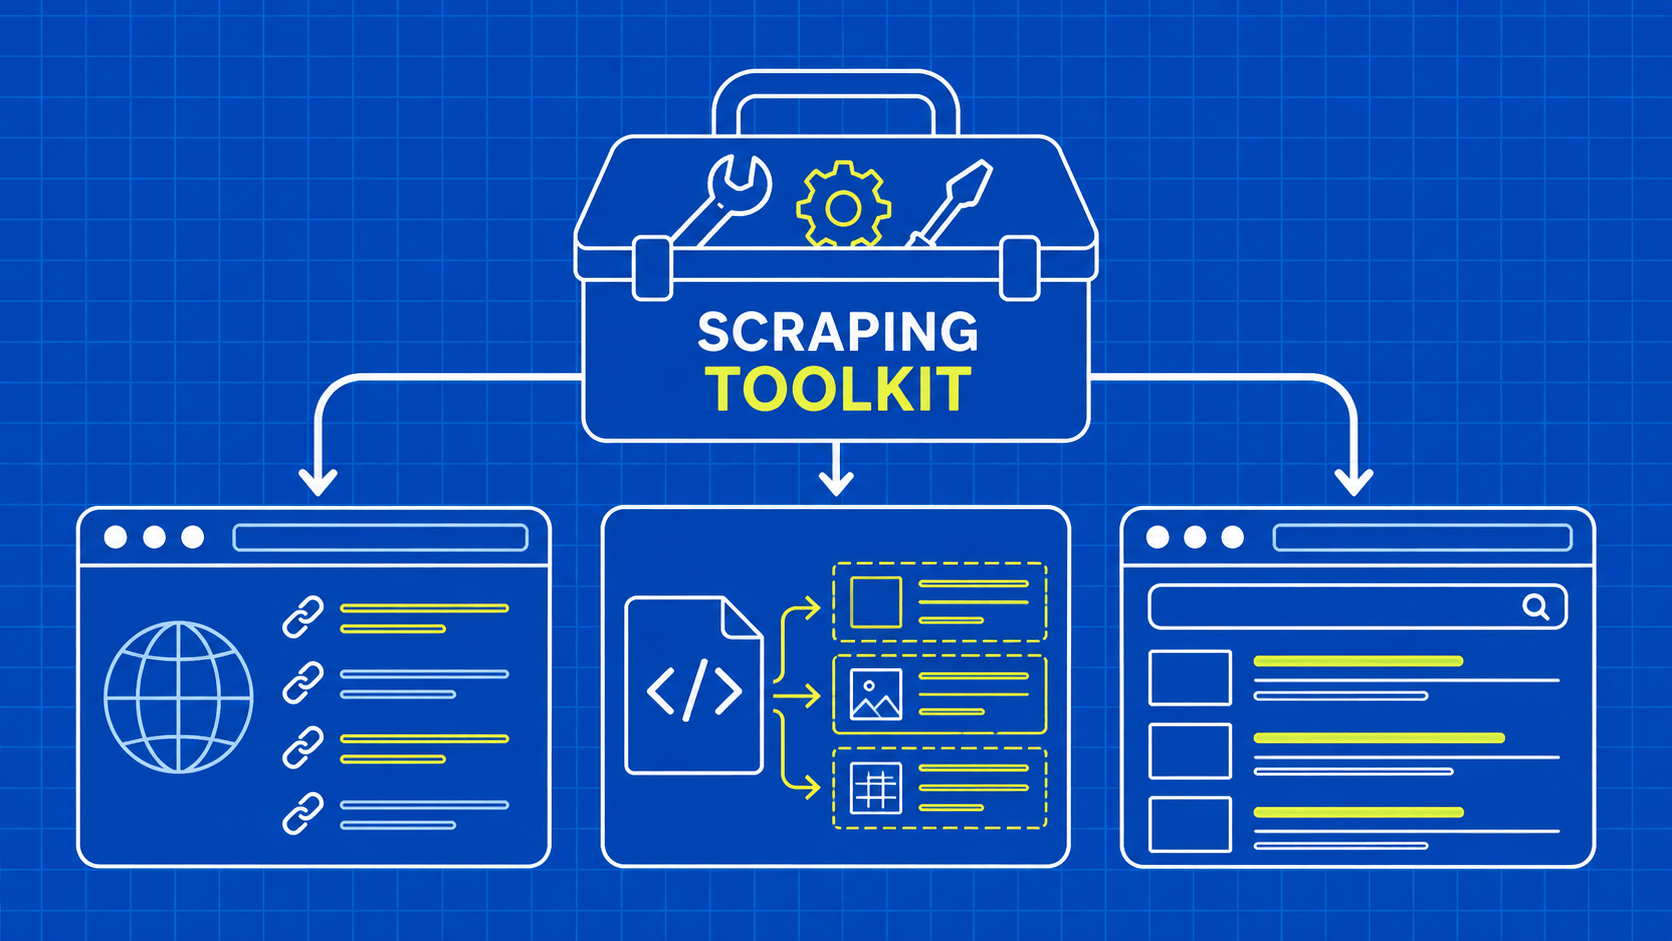
En bref : optez pour Screaming Frog pour l’extraction lors d’un audit de site, Scrapy pour un robot d’indexation personnalisé et récurrent, Playwright pour les interactions avec le navigateur, Web Scraper pour l’extraction visuelle et OpenRefine pour le nettoyage des données collectées. Ces outils remplacent différentes étapes d’un flux de travail ; évaluez les résultats dont vous avez besoin plutôt que d’attendre d’une seule application qu’elle offre toutes les fonctionnalités.
Une alternative à Scrapebox vient se substituer à la tâche spécifique de crawl, d’extraction, d’audit ou de traitement de listes que vous effectuez actuellement. La question pertinente est de savoir quelle fonctionnalité doit être remplacée et qui sera chargé de l’utiliser une fois le changement effectué.
Imaginez que votre flux de travail existant commence par une liste d’URL, extraie les titres de page et les attributs des produits, supprime les entrées en double et exporte un rapport. Le collecteur, les règles de nettoyage et le rapport relèvent de responsabilités distinctes, même si une seule application de bureau les gère actuellement. Déplacer ces trois éléments en même temps peut rendre un simple changement d’outil étonnamment difficile.
Ce guide compare cinq options documentées pour la collecte et l’analyse légitimes de données. Il ne les classe pas en fonction d’une rapidité non mesurée et ne désigne pas de solution universelle. Un audit technique de référencement et un flux de travail produit piloté par un navigateur ont des exigences différentes ; leurs meilleurs points de départ peuvent donc varier.
Vous allez cartographier la tâche actuelle, présélectionner un remplacement approprié et valider les enregistrements obtenus avant de mettre fin à l’ancien processus. L’accent est mis sur des données utiles dont le traitement est reproductible, et non sur l’augmentation du volume de collecte pour elle-même.