Aller au contenu
Retour au blog

Contraintes architecturales des API REST : guide de conception

Sorin-Gabriel MaricaDernière mise à jour le 16 min read
Contraintes architecturales des API REST : guide de conception
En bref : REST est un style architectural défini par des contraintes régissant les interactions entre les composants. Utilisez ses six contraintes pour évaluer l’indépendance vis-à-vis du client, le contexte de la requête, la mise en cache, l’uniformité des interfaces, les couches et le code téléchargeable en option ; une réponse JSON à elle seule ne prouve aucune d’entre elles.

Un point de terminaison qui renvoie une commande au format JSON peut tout de même contraindre chaque client à comprendre le workflow interne du serveur. Les contraintes architecturales d’une API REST sont les règles qui déterminent si ces interactions respectent le principe du « Representational State Transfer » (REST), plutôt que de se contenter d’utiliser le protocole HTTP. Elles portent sur ce que les participants doivent savoir les uns des autres, la manière dont ils échangent des représentations et leur degré d’autonomie en matière de modification.

Prenons l’exemple d’un collecteur consultant un catalogue de produits. Il doit récupérer des enregistrements, découvrir une autre page, reconnaître un résultat inchangé et reprendre le traitement après l’échec d’un worker. Ces exigences mettent immédiatement en évidence les choix architecturaux. La requête suivante contient-elle son propre contexte ? Le serveur peut-il annoncer la page suivante ? Une réponse enregistrée est-elle réutilisable ? Le worker de remplacement doit-il récupérer une conversation invisible avant de continuer ?

Ce guide utilise ces questions comme base d’une revue de conception. Les exemples décrivent un service de catalogue hypothétique, et non l’API exécutable d’un fournisseur. Ils montrent comment analyser le comportement sans réduire REST à une liste de noms de points de terminaison ou de verbes HTTP. Vous pouvez appliquer cette même analyse à une API que vous publiez, à une intégration que vous gérez ou à un pipeline de collecte de données qui utilise le service d’un tiers.

Lire « Les contraintes architecturales des API REST comme tests de conception »

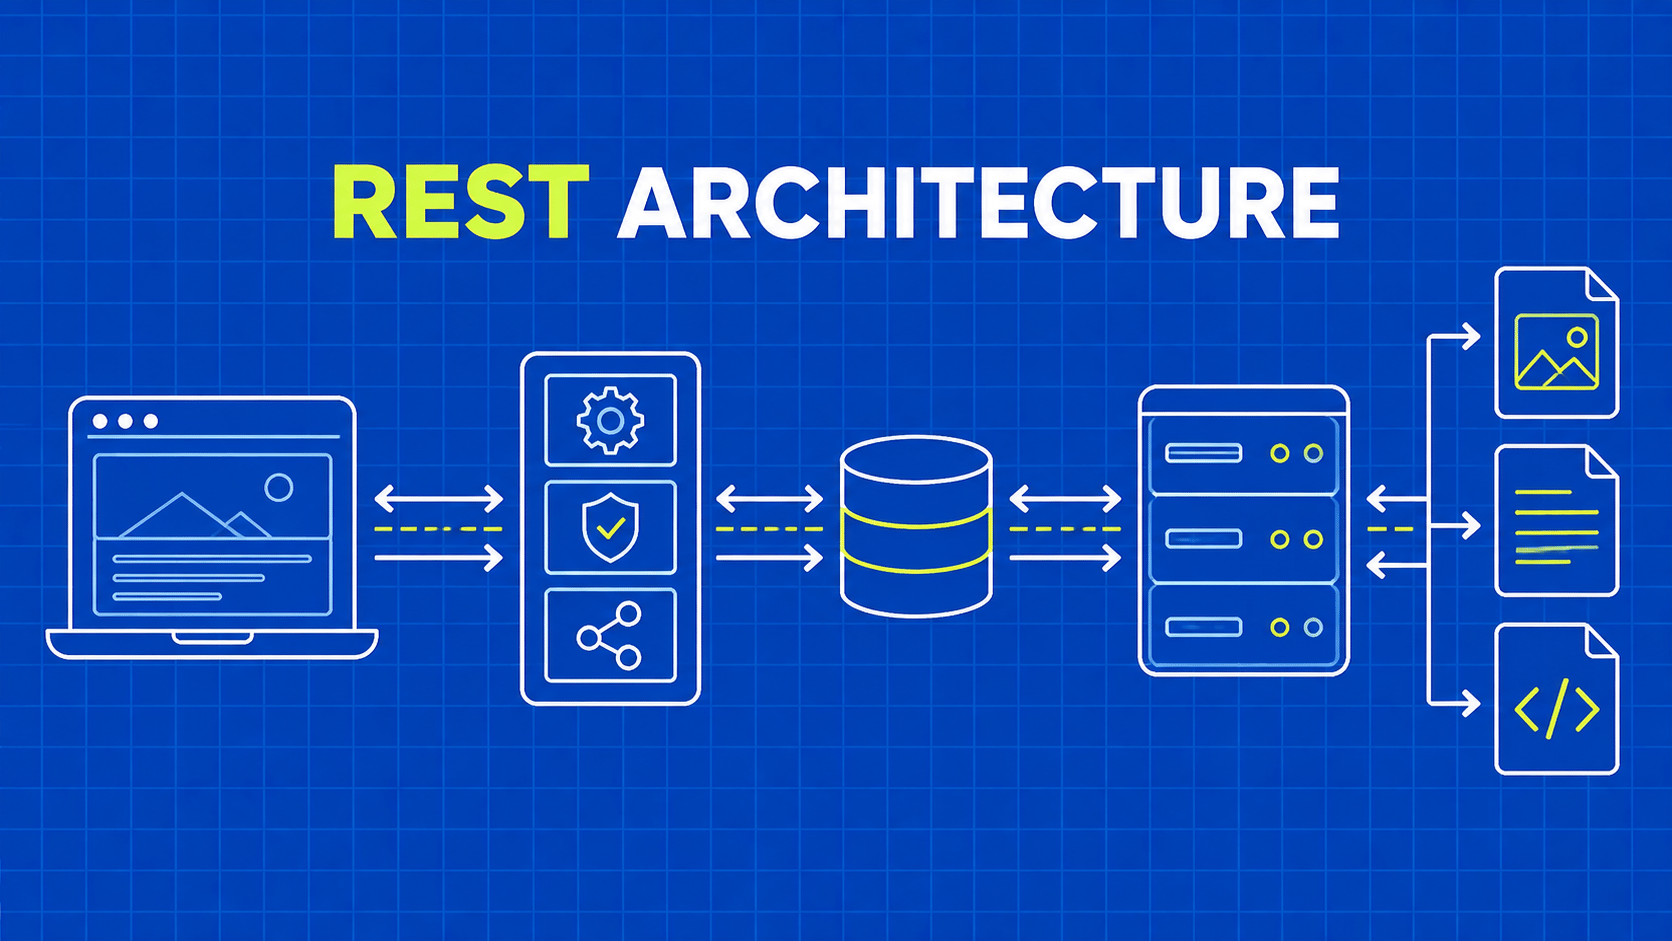
Les six contraintes sont la séparation client-serveur, les interactions sans état, la mise en cache, une interface uniforme, un système en couches et le code à la demande facultatif. Les cinq premières définissent des caractéristiques obligatoires ; le comportement exécutable téléchargé est facultatif. Roy Fielding développe cet ensemble au chapitre 5 de sa thèse.

Utilisez ce tableau pour transformer ces noms en éléments de preuve que vous pouvez demander lors d’une revue. Les exemples sont des questions de conception, et non une suite de tests de conformité ni la promesse qu’un seul en-tête suffise à rendre tout un système RESTful.

Contrainte

Éléments à vérifier

Question hypothétique du catalogue

Client-serveur

Une frontière entre les responsabilités de présentation et de service

Un collecteur en ligne de commande peut-il utiliser le catalogue sans l'interface utilisateur du site web ?

Sans état

Contexte complet pour chaque interaction

Un autre processus peut-il émettre la requête suivante de manière indépendante ?

Mémorisable en cache

Conditions définies pour la réutilisation des réponses

Une réponse de produit enregistrée est-elle toujours utilisable pour cette requête ?

Interface uniforme

Identification des ressources, représentations, sémantique des messages et hypermédia

La réponse explique-t-elle ses données et les transitions disponibles ?

Système en couches

Une interface fonctionnant par le biais d’intermédiaires

L'ajout d'une passerelle oblige-t-il les clients à connaître la topologie interne ?

Code à la demande, facultatif

Exécution des fichiers téléchargés explicitement prise en charge

L'exécution d'un script fourni est-elle réellement nécessaire ?

Les contraintes de l’architecture API REST décrivent un système d’interactions. Une capture d’écran d’une seule réponse ne suffit pas à les établir toutes. Recueillez une brève trace contenant une lecture, une transition, une erreur et une requête répétée, puis examinez les hypothèses reliant ces événements.

Séparez également l’architecture du choix technologique. HTTP est un environnement naturel pour les interfaces orientées ressources, mais un style architectural n’est pas une spécification de format de transmission. Si votre équipe compare encore différentes familles de conception, le guide « API REST vs API SOAP » explique pourquoi un style architectural et un protocole de messagerie nécessitent des critères d’évaluation différents.

Séparez les responsabilités du client du contexte de la requête

Imaginez qu’un service de catalogue publie des descriptions de produits et la disponibilité des stocks. Un navigateur choisit la mise en page visuelle, tandis qu’un collecteur choisit un format de stockage. Aucun de ces consommateurs n’a besoin de savoir si le service interroge une seule base de données ou combine plusieurs systèmes. Cette séparation constitue un point de départ utile pour la conception client-serveur.

Ne l’interprétez pas comme une obligation de créer un nouveau microservice pour chaque ressource. Une seule application peut exposer une frontière claire. À l’inverse, de nombreux microservices peuvent exposer une interface étroitement couplée si les appelants doivent comprendre les noms internes des bases de données, l’ordre de déploiement ou les étapes non documentées d’un workflow.

L’examen suivant porte sur l’état de la conversation. Supposons qu’un service exige qu’un client sélectionne d’abord un entrepôt, puis lise une requête de produit non qualifiée en fonction de cette sélection mémorisée. Un remplaçant ne peut pas comprendre la requête en la consultant simplement. Dans une architecture sans état, la requête identifie l’entrepôt concerné ou contient suffisamment d’informations pour interpréter l’opération demandée.

Cela ne signifie pas que le service oublie les produits, les commandes ou les autorisations après chaque réponse. Les données métier persistantes constituent l’état de la ressource. Le problème réside dans le contexte caché de la conversation avec le client, nécessaire pour comprendre une requête ultérieure. Les contraintes de l’architecture API REST deviennent plus faciles à appliquer lorsque vous nommez explicitement ces deux types d’état dans le document de conception.

L’authentification nécessite la même attention. Un jeton « bearer » ne prouve pas que chaque interaction est sans état, et une consultation de la base de données lors de l’autorisation ne prouve pas automatiquement le contraire. Vérifiez si la requête peut être comprise sans reconstituer les interactions antérieures du client. Examinez ensuite l’autorisation séparément : le service doit décider si cet appelant est autorisé à accéder à cet entrepôt et à ce produit en particulier.

Pour les collecteurs, documentez quelles données d’entrée de la requête appartiennent à un compte, à un emplacement ou à une exécution de collecte. Conservez ces données d’entrée associées aux éléments de travail lorsque vous les transférez d’un travailleur à un autre. Si l’intégration s’appuie également sur des sessions de navigateur, comprenez comment les cookies HTTP préservent le contexte de session avant de supposer que la copie d’une URL reproduit la réponse.

Faites du comportement du cache un contrat de données explicite

Supposons que la description du produit change rarement, tandis que la disponibilité varie tout au long de la journée. Attribuer aux deux réponses la même longue fenêtre de réutilisation est pratique pour l’infrastructure, mais potentiellement erroné pour l’utilisateur. La conception du cache commence par la durée de validité acceptable de l’information, et non par la volonté de réduire le volume de requêtes.

Pour les API HTTP, la RFC 9111 définit la réutilisation du cache et les directives associées. Une réponse peut interdire le stockage, exiger une validation avant réutilisation ou autoriser la réutilisation sous certaines conditions. no-cache ne signifie pas la même chose que no-store: la première autorise le stockage mais exige une validation réussie avant la réutilisation ; la seconde ordonne aux caches de ne pas stocker la réponse.

Une balise d’entité fournit à un consommateur un validateur pour une représentation sélectionnée. Le collecteur peut ensuite envoyer If-None-Match; lorsque les conditions applicables sont remplies pour une requête GET, une 304 Not Modified réponse lui permet de réutiliser la représentation enregistrée. Cette réponse ne comporte pas de nouveau corps de représentation à analyser. La traiter comme un catalogue vide compromettrait un cycle de collecte par ailleurs fonctionnel.

Les contraintes de l’architecture des API REST exigent un comportement de réutilisation défini, et non une mise en cache universelle. Un rapport spécifique à un compte peut nécessiter une gestion restrictive, tandis qu’une description de catégorie publique peut tolérer une période de validité plus longue. Une revue de conception doit identifier ces deux cas plutôt que d’exiger un accès en cache pour chaque point de terminaison.

Distinguez clairement les variantes. Si la langue, les identifiants, la localisation ou toute autre donnée d’entrée influence la réponse, déterminez comment cette donnée intervient dans la sélection du cache et la politique de mise en cache. Ne partez pas du principe qu’une clé de cache basée uniquement sur l’URL est suffisante pour les données personnalisées. Les caches partagés sont également soumis à des restrictions spécifiques concernant les requêtes authentifiées ; vérifiez donc le comportement déployé au lieu de vous fier à la présence d’une seule directive.

Dans votre stockage de collection, conservez l’heure de récupération séparément de l’heure de modification fournie par la source. Elles répondent à des questions différentes : quand vous avez observé la représentation, et quand l’éditeur indique qu’elle a changé. Il s’agit d’une recommandation d’implémentation pour l’auditabilité, et non d’une septième contrainte REST.

Passez en revue les quatre composantes de l’interface uniforme

L’interface uniforme est la partie des contraintes architecturales des API REST la plus facile à négliger. Elle comprend quatre exigences : identifier les ressources, les manipuler via des représentations, rendre les messages auto-descriptifs et utiliser l’hypermédia pour piloter l’état de l’application. Évaluez chacune d’entre elles au lieu de considérer que « l’utilisation des méthodes GET et POST » constitue l’intégralité de l’examen.

Identifier les ressources et échanger des représentations

Un identifiant de produit fait référence à la ressource conceptuelle « produit » ; son document JSON est une représentation de cette ressource à un moment donné. Une page affichée, une image ou un document XML peuvent également constituer une représentation. Concevoir en tenant compte de cette distinction vous aide à éviter d’exposer la structure d’une ligne de base de données comme s’il s’agissait d’un contrat public permanent.

Pour le catalogue hypothétique, précisez quel identifiant reste stable lorsque le nom d’un produit change. Déterminez si les variantes possèdent des identités distinctes et si les produits discontinués restent accessibles. Il s’agit là de choix propres au domaine. Le test pratique consiste à vérifier si les clients peuvent faire référence à l’élément visé sans avoir à deviner comment le serveur le stocke.

La manipulation par le biais de représentations signifie que le client passe par l’interface publiée plutôt que de modifier directement les structures privées du serveur. Une représentation soumise doit tout de même être validée par le serveur. Un prix, un identifiant de propriétaire ou un champ d’autorisation fourni par le client ne devient pas pour autant faisant autorité simplement parce que la requête utilise un type de média approprié.

Veillez à ce que les messages expliquent comment les interpréter

L’autodescription exige plus que des noms de champs lisibles. La sémantique des méthodes, le statut de la réponse, le type de média et les métadonnées pertinentes indiquent aux destinataires comment traiter le message. Un même texte JSON peut avoir des significations différentes selon qu’il est renvoyé en tant que représentation réussie ou inclus dans une réponse d’erreur.

Lorsque vous utilisez HTTP, appliquez la sémantique réelle de ses méthodes. GET est une méthode de récupération sûre ; PUT et DELETE sont idempotentes au regard de l’effet prévu défini. L’idempotence n’implique pas que chaque répétition renvoie un statut identique ni n’interdit la journalisation. Ces distinctions proviennent de la sémantique HTTP (RFC 9110) et sont importantes lorsqu’une intégration envisage de réessayer une opération interrompue.

Un collecteur doit vérifier le statut et le type de média avant d’analyser les enregistrements attendus. Une connexion réseau réussie suivie d’une erreur de passerelle HTML ne constitue pas un catalogue JSON valide. De même, un objet JSON syntaxiquement valide mais présentant un schéma d’erreur ne correspond pas à une page ne contenant aucun produit.

Laisser les représentations exposer les transitions disponibles

L’hypermédia en tant que moteur de l’état de l’application, souvent abrégé en HATEOAS, signifie que les clients sélectionnent les transitions disponibles à partir des contrôles fournis par l’interaction. Une représentation de catalogue peut exposer un lien vers la page suivante dont la relation a une signification définie. Le collecteur suit ce contrôle plutôt que de calculer chaque URL future à partir d’une hypothèse privée concernant les décalages.

La clarification apportée par Fielding sur les API pilotées par l’hypertexte en fait une exigence fondamentale, et non une option facultative. Les clients doivent toujours comprendre le type de média et la sémantique des relations. L’hypermédia ne rend pas compréhensible tout flux de travail métier inconnu en l’absence de contrat.

À titre d’exemple pratique, remplacez l’URL hypothétique de la page suivante, qui repose sur un décalage, par un curseur opaque. Un client qui suit le contrôle fourni ne subit aucun changement. Un client qui l’ignore et incrémente un nombre est lié à une règle de construction. La RFC 8288 définit les liens Web et les types de relations, fournissant un vocabulaire pour les liens dont la signification est plus précise qu’un champ d’URL arbitraire.

Les contraintes de l’architecture des API REST posent donc une question plus profonde que celle de l’existence même des liens : les transitions prises en charge guident-elles réellement le client ? L’ajout d’un self lien à une procédure autrement codée en dur ne suffit pas à démontrer l’uniformité complète de l’interface.

Préserver la sémantique à travers les couches et le code téléchargé

Un collecteur peut atteindre une passerelle qui achemine vers un cache, puis vers une application. Il doit utiliser l’interface publiée sans dépendre de l’instance d’application qui reçoit la requête. En interne, l’opérateur peut modifier le routage ou remplacer un service tout en préservant cette frontière.

Les couches sont également des points de défaillance des hypothèses. Un proxy peut supprimer un en-tête, une passerelle peut substituer une page d’erreur, ou un cache peut fusionner des réponses qui devraient rester distinctes. Examinez le comportement de bout en bout ainsi que la configuration de chaque composant. Les contraintes de l’architecture des API REST ne garantissent pas qu’un intermédiaire soit correctement configuré.

Utilisez une petite matrice de traçage pour le catalogue hypothétique : réponse directe de l’application, réponse de la passerelle, revalidation du cache et délai d’attente en amont. Comparez l’état observable, les métadonnées de représentation et le contrat d’erreur. Conservez un identifiant de corrélation qui aide les opérateurs à tracer les défaillances, mais évitez d’exiger des clients qu’ils comprennent les noms d’hôtes internes ou la topologie de déploiement.

Le « code à la demande » aborde un autre problème : un serveur peut étendre le comportement d’un client en lui fournissant du code exécutable. Le chargement d’un script par un navigateur illustre ce mécanisme. Son statut facultatif est important, car de nombreux consommateurs d’API n’acceptent intentionnellement que des données. Un serveur n’a pas besoin d’envoyer du JavaScript à un collecteur sans interface graphique pour satisfaire aux contraintes obligatoires.

Pour les opérations de collecte, rendez la limite d’exécution explicite. Si une page nécessite une exécution dans le navigateur pour révéler des données, il s’agit d’une exigence opérationnelle de la cible. Cela ne prouve pas que chaque client REST doive exécuter des réponses arbitraires. De même, la réception de code HTML n’établit pas que le « code-on-demand » est utilisé ; le contenu HTML et le comportement exécutable relèvent de préoccupations distinctes.

Considérez l’exécution téléchargée comme une capacité distincte, dotée de ses propres contrôles. Conservez les identifiants d’accès à l’API en dehors des contextes d’exécution de pages non liés, et déterminez quels hôtes et quelles destinations de navigation un collecteur basé sur un navigateur est autorisé à atteindre. Il s’agit là de précautions pratiques de mise en œuvre liées à l’exemple, et non d’ajouts à la définition architecturale.

Transformez ces contraintes en un audit d’intégration

Commencez par un parcours utilisateur réel plutôt que par l’inventaire des points de terminaison. Pour l’exemple du catalogue, récupérez une catégorie, suivez une transition de page, revisitez un produit inchangé, rencontrez une ressource indisponible, puis reprenez l’exécution après le redémarrage d’un worker. Capturez les requêtes et réponses nettoyées à chaque étape.

Pour chaque observation, distinguez une propriété démontrée d’une hypothèse. Un redémarrage réussi du worker suggère la portabilité du contexte, mais ne prouve pas l’absence de dépendance de session cachée ailleurs. Un contrôle de page suivante démontre une transition annoncée, mais n’établit pas que l’application tout entière est pilotée par l’hypermédia.

Les contraintes de l’architecture API REST fonctionnent mieux en tant que vocabulaire d’évaluation. Notez « nécessite une sélection préalable non documentée de l’entrepôt » plutôt que « mauvaise architecture REST ». Notez « le client construit des URL de pagination malgré une relation fournie » plutôt que « pas moderne ». Des constatations concrètes indiquent des changements qu’un développeur peut mettre en œuvre et qu’un réviseur peut vérifier.

Hiérarchisez ensuite les défaillances en fonction de leurs conséquences. Une autorisation incorrecte ou une mise en cache inter-comptes doit être traitée en priorité par rapport à une préférence de nommage. Une nouvelle tentative qui duplique le travail mérite une stratégie de récupération documentée. L’absence d’une fonctionnalité optionnelle de « code à la demande » ne nécessite aucune correction simplement pour obtenir le label REST.

Pour un service externe, vous n’avez peut-être pas la possibilité de modifier l’interface. Adaptez le collecteur au contrat documenté, préservez le contexte nécessaire et décrivez honnêtement la limitation. L’utilisation d’une API HTTP utile qui ne répond pas aux critères REST stricts peut tout de même constituer un choix technique judicieux. L’erreur consiste à supposer des propriétés que l’interface n’a jamais promises.

Points clés à retenir

  • Évaluez les contraintes architecturales de l’API REST en fonction des traces de requêtes et des dépendances des clients, et non en fonction de la présence de JSON ou de noms de points de terminaison attrayants.
  • Séparez les données de ressources persistantes de l’état caché de la conversation, et vérifiez si le travail peut passer d’un consommateur à l’autre sans avoir à reconstituer les interactions précédentes.
  • Considérez l’actualité, la validation, les variantes de représentation et la gestion des erreurs comme faisant partie intégrante du contrat de données avant d’activer une mise en cache intensive ou des tentatives de reconnexion.
  • Vérifiez les quatre exigences d’une interface uniforme, y compris les transitions significatives ; une liste de méthodes HTTP ne couvre qu’une partie de la conception.
  • Consignez les limitations concrètes de l’intégration et leurs conséquences afin que les corrections portent sur la fiabilité et l’indépendance plutôt que sur la terminologie seule.

FAQ

Le modèle REST impose-t-il l’indication d’un numéro de version de l’API dans l’URL ?

Non. Les contraintes ne prescrivent pas d’emplacement universel pour le numéro de version. Une politique de gestion des versions relève d’une décision contractuelle qui doit expliquer comment les clients détectent les changements et comment la compatibilité est maintenue. Avant d’adopter une convention de nommage, identifiez les changements qui pourraient réellement perturber les utilisateurs existants et la manière dont vous les communiquerez ou les mettrez en œuvre progressivement.

Une transaction de base de données est-elle incompatible avec REST ?

Non. Un service peut utiliser des transactions de base de données en interne tout en exposant une interface conforme à REST. Le client doit se fier au comportement publié plutôt qu’à l’implémentation de la base de données. Déterminez le niveau de cohérence garanti par l’opération, ce que signifie une réponse aboutie, et comment un appelant peut analyser un résultat incertain après un échec de connexion.

Les contraintes de l’architecture des API REST spécifient-elles des limites de débit ?

Non. Elles ne fixent pas de quotas de requêtes, de limites de concurrence ni d’intervalle d’attente universel. Ces éléments relèvent du contrat opérationnel du service. Les consommateurs doivent prendre connaissance des limites documentées par le fournisseur, limiter la concurrence et conserver suffisamment d’informations de diagnostic pour distinguer la limitation de débit des erreurs de validation ou d’une infrastructure indisponible.

Examinez le comportement avant de choisir l’étiquette

L’analyse REST la plus productive aboutit à des conclusions observables. Vous devez savoir quel contexte porte une requête, quand une réponse peut être réutilisée, comment le client l’interprète et d’où provient l’action suivante prise en charge. Vous devez également savoir quelles hypothèses restent non vérifiées derrière les passerelles ou après une interaction ayant échoué.

Utilisez ces conclusions pour améliorer la prochaine intégration. Intégrez une entrée manquante dans le contrat explicite, corrigez une limite de cache ou apprenez au client à suivre une transition fournie. Maintenez une distinction claire entre les exigences architecturales et les recommandations opérationnelles afin que l’équipe puisse faire des compromis réfléchis.

Si votre pipeline de données a également besoin d’informations disponibles uniquement via des pages web, évaluez l’API Scraper de WebScrapingAPI comme source de collecte distincte. Appliquez la même rigueur à cette limite : validez la réponse, préservez le contexte de collecte et documentez ce que les consommateurs en aval peuvent supposer au sujet des données renvoyées.

À propos de l'auteur

Sorin-Gabriel Marica, Développeur full-stack @ WebScrapingAPI

Sorin-Gabriel Marica

Développeur full-stack

Sorin Marica est ingénieur Full Stack et DevOps chez WebScrapingAPI ; il développe des fonctionnalités pour les produits et assure la maintenance de l'infrastructure qui garantit le bon fonctionnement de la plateforme.

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.