
Aller au contenu
Retour au blog

La meilleure API de scraping pour Amazon : 5 options et comment faire son choix

Robert SfichiDernière mise à jour le 17 min read
La meilleure API de scraping pour Amazon : 5 options et comment faire son choix
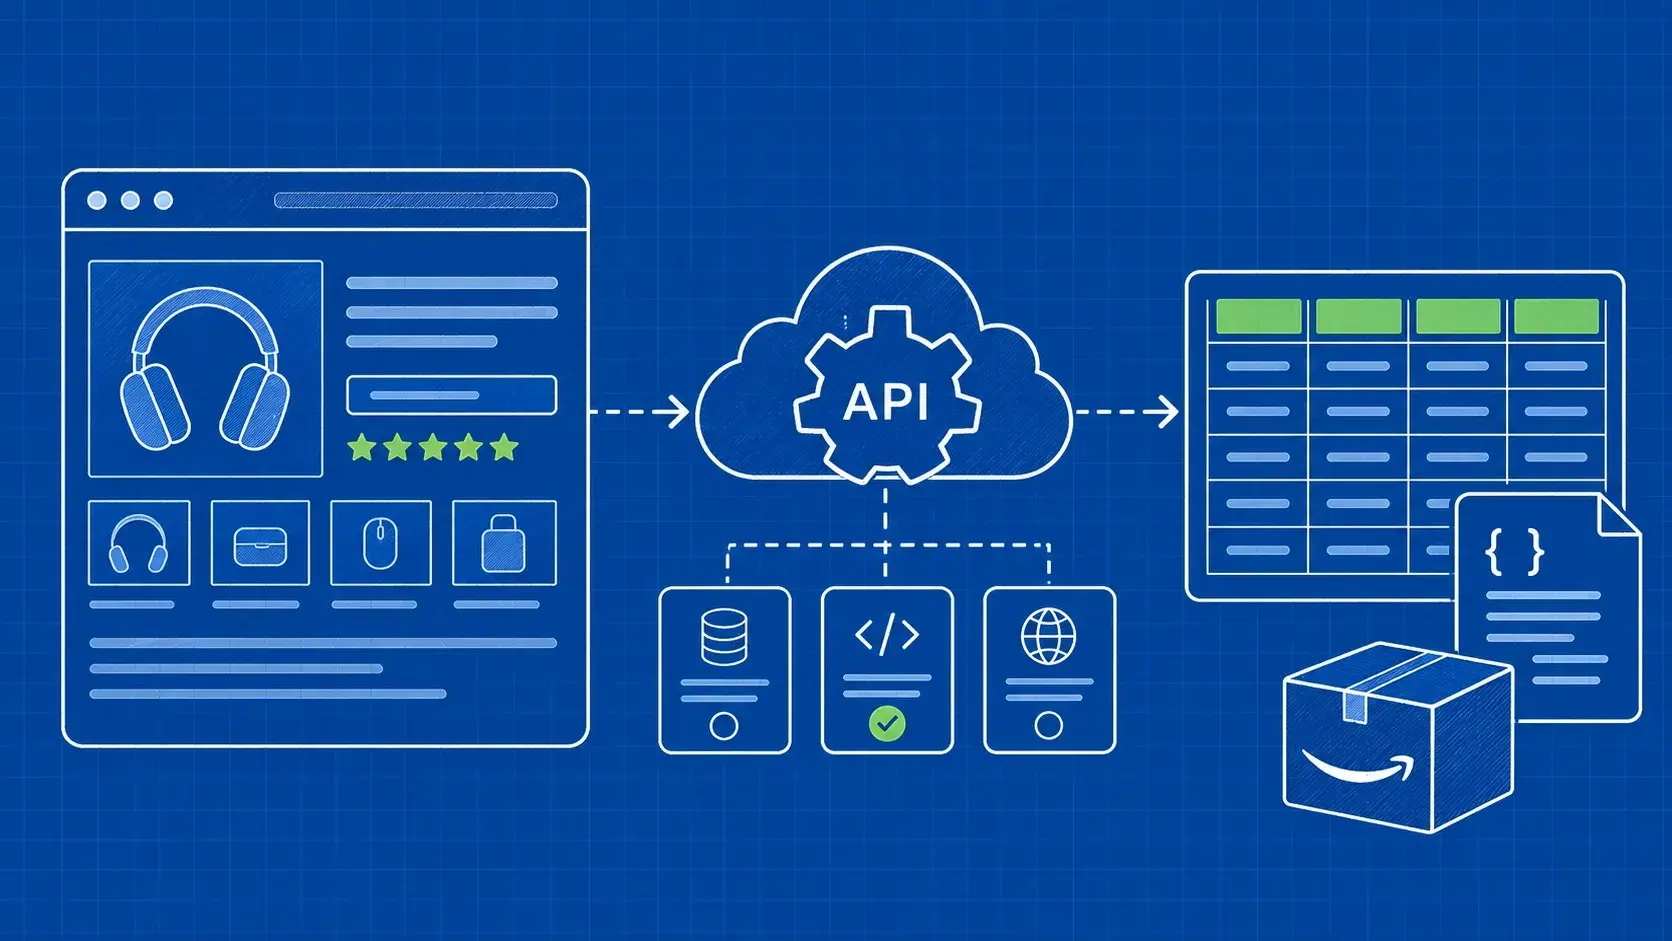
En bref : le choix de la meilleure API de scraping Amazon dépend du type de données dont vous avez besoin. Choisissez un point de terminaison Amazon dédié pour les champs prédéfinis relatifs aux produits, à la recherche ou aux offres ; envisagez la récupération de pages générales si vous disposez déjà d’un analyseur syntaxique. Comparez les solutions en utilisant les mêmes produits, les mêmes lieux, les mêmes champs obligatoires et le même coût par enregistrement accepté. La liste ci-dessous est basée sur la documentation actuelle et propose un plan d’essai pratique pour vérifier l’adéquation de chaque solution.

Imaginez deux services renvoyant le même produit. L’un fournit une page que votre équipe doit analyser. L’autre renvoie du JSON, mais son prix correspond à une variante ou à un lieu de livraison différent. Les deux requêtes peuvent sembler aboutir, alors qu’une seule, voire aucune, ne répond à vos exigences.

Le choix de la meilleure API de scraping Amazon commence par la définition des données que vous souhaitez collecter. Un outil de suivi des prix a besoin d’un contexte cohérent concernant les produits et les offres. Un outil de découverte a besoin de résultats de recherche et d’une couverture complète des pages. Un projet de recherche planifié a besoin de lots complets arrivant dans la fenêtre de collecte prévue.

Ce guide compare cinq options en fonction de leurs capacités documentées et explique comment les évaluer sans considérer le nombre de requêtes annoncé comme un ensemble de données finalisé. Il n’est pas nécessaire d’être développeur pour suivre ce processus de sélection : commencez par un échantillon de produits, notez les champs dont vous avez besoin, puis examinez ce que chaque service renvoie.

Les descriptions des fournisseurs s’appuient sur la documentation vérifiée en septembre 2026. Nous n’avons pas réalisé de test comparatif des services payants ; cet article ne désigne donc pas de fournisseur le plus rapide ou le plus fiable. Il vous propose en revanche une liste restreinte, un calcul des coûts et une liste de contrôle de conformité que vous pouvez appliquer à votre propre charge de travail.

Meilleure API de scraping Amazon : commencez par le résultat

Supposons que vous souhaitiez obtenir quotidiennement une feuille de calcul répertoriant les prix des produits. Une page Amazon téléchargée vous oblige encore à effectuer un travail d’extraction. Une réponse analysée peut vous fournir des champs nommés, mais vous devez vérifier ce que chaque prix représente et si le produit correspond à votre requête.

Il existe trois points de départ utiles :

Approche

Ce que vous recevez

Ce dont dispose votre équipe

API générale de récupération de pages

Contenu de la page correspondant à l'URL fournie

Analyse, définitions des champs, validation, stockage

Point de terminaison Amazon dédié

Un schéma documenté pour les produits, les recherches ou les offres

Mappage de ce schéma à votre application et vérification des enregistrements

Workflow de collecte géré

Tâches, plannings et livraison liés à l’extraction

Définition de la charge de travail et acceptation du jeu de données livré

Ces catégories peuvent se recouper au sein d’un même fournisseur. Sélectionnez le point de terminaison et le workflow, et pas seulement le nom de l’entreprise. Un service prenant en charge le rendu dans le navigateur peut également disposer d’un analyseur syntaxique Amazon, mais ces fonctionnalités ne sont pas interchangeables.

Pour un premier projet de surveillance des prix, commencez par un point de terminaison dédié à un produit si ses champs répondent à vos besoins. Pour un analyseur existant qui gère plusieurs détaillants, la récupération gérée de pages peut être plus adaptée. Pour les collectes nocturnes, examinez le suivi des tâches et la livraison des résultats avant d’optimiser le temps de réponse.

La meilleure API de scraping Amazon est donc celle qui produit les résultats dont vous avez besoin avec un travail d’intégration gérable. Notre comparatif des API d’accès Web explique ces responsabilités opérationnelles plus en détail.

Cinq options d’API à évaluer

Cette sélection repose sur la documentation publique des produits consultée en septembre 2026. Il s’agit d’une comparaison des fonctionnalités documentées, et non d’un classement basé sur des tests pratiques de vitesse ou de taux de réussite. Les recommandations d’adéquation ci-dessous sont des avis rédactionnels ; vérifiez-les à l’aide de votre propre charge de travail test.

WebScrapingAPI : récupération gérée pour votre propre analyseur

L’API de scraping accepte une URL cible et gère la récupération de la page, y compris le routage via proxy et le rendu JavaScript (en option). Elle constitue une solution envisageable si vous extrayez déjà vous-même les données produit d’Amazon ou si vous souhaitez disposer d’une interface de récupération unique pour plusieurs sites web.

Considérez la réponse comme une entrée de votre pipeline d’extraction. Ne partez pas du principe que le point de terminaison de récupération général renvoie une fiche produit Amazon standardisée. Votre application doit encore identifier le produit, interpréter les prix et valider les champs manquants.

Le principal critère de sélection est la maîtrise : souhaitez-vous conserver le contrôle des règles d’analyse tout en externalisant les opérations d’accès ? Si oui, testez des URL Amazon représentatives avec votre analyseur existant et mesurez la proportion de données qui se transforment en fiches exploitables. Si vous souhaitez disposer immédiatement de champs Amazon prédéfinis, incluez un point de terminaison dédié, comme notre API Amazon Data, dans le même test.

ScrapingBee : points de terminaison « produit », « recherche » et « prix »

La documentation actuelle de l’API Amazon répertorie des points de terminaison distincts pour les produits, la recherche et les prix. La recherche de produit utilise un ASIN, tandis que les paramètres de localisation et de marketplace vous permettent de préciser le contexte de la requête. La documentation distingue également les requêtes « légères » des requêtes qui forcent le rendu JavaScript.

C’est une solution idéale pour une application qui souhaite analyser les réponses d’Amazon sans passer par des sélecteurs HTML. Lors de l’évaluation, vérifiez les champs exacts renvoyés par chaque point de terminaison plutôt que de supposer qu’une recherche de produit inclut toutes les offres ou tous les détails de recherche.

Prêtez attention au mode de requête. Une requête plus coûteuse peut s’avérer utile lorsqu’elle fournit le contenu requis, mais le rendu doit avoir un objectif mesurable. Testez la configuration appropriée la moins coûteuse par rapport à vos règles d’acceptation avant de l’optimiser.

Scrape.do : collecte distincte des produits et des offres des vendeurs

La documentation du plugin Amazon décrit des routes dédiées aux détails du produit, à la liste des offres et à la recherche, ainsi qu’une route HTML brute. Cette séparation est utile lorsque vous devez distinguer les informations produit affichées des offres des vendeurs qui y sont associées.

Envisagez cette option lorsque votre charge de travail inclut la comparaison des offres ainsi que le suivi des produits. La documentation « Toutes les offres » fournit le contrat de réponse pertinent ; vérifiez les champs relatifs au vendeur, à l’expédition et à la disponibilité par rapport à l’utilisation que vous comptez en faire.

Un point de terminaison nommé ne dispense pas de vérifier la couverture. Incluez dans votre test des produits présentant différents modèles d’offres et vérifiez comment s’affichent les résultats vides ou indisponibles. Vérifiez également les paramètres de lieu de livraison pris en charge pour chaque marketplace dont vous avez réellement besoin.

Scrapingdog : workflows de produits et de recherche

La documentation actuelle sur les produits décrit les requêtes basées sur l’ASIN avec des paramètres de place de marché et de localisation. Sa documentation sur la recherche couvre un point de terminaison de recherche distinct. Les exemples de réponses de produits incluent du texte de prix formaté et un symbole de prix, ce qui rappelle utilement que le résultat analysé peut encore nécessiter une normalisation.

Cette solution est à envisager lorsque votre premier workflow consiste en une recherche de produit ou une découverte basée sur des mots-clés et que vous souhaitez évaluer directement une réponse Amazon documentée. Vérifiez les noms actuels des paramètres ; les exemples plus anciens peuvent renvoyer à des chemins de documentation différents.

Profitez de votre période d’essai pour examiner les identifiants de variantes, les prix manquants et la localisation demandée. Un schéma comportant de nombreux champs n’est utile que si les champs dont votre application a besoin sont présents et correctement interprétés. Notez ces exigences avant de comparer la taille des réponses.

ScraperAPI : tâches asynchrones sur les produits structurés

La documentation relative aux produits asynchrones décrit la soumission d’un ou de plusieurs ASIN, la réception des informations sur la tâche et la récupération du résultat une fois celle-ci terminée. Elle documente également les rappels via webhooks, qui permettent d’informer votre application d’une tâche plutôt que de maintenir une requête ouverte pendant toute la durée de la collecte.

Envisagez cette option lorsque votre flux de travail s’exécute naturellement par lots. Évaluez à la fois les données et le cycle de vie de la tâche : soumission, achèvement, échec, récupération des résultats et gestion des livraisons en double.

Une tâche acceptée ne correspond pas à un ensemble de données finalisé. Votre application doit conserver l’identifiant de la tâche et vérifier si la réponse finale respecte ses règles d’enregistrement. Pour un rafraîchissement planifié du catalogue, comparez la durée totale d’exécution et le nombre d’enregistrements acceptés, et non pas uniquement la rapidité de réponse du point de terminaison de soumission.

Vérifiez la place de marché, les offres et la signification des champs

Une observation utile des prix nécessite un contexte. Enregistrez la place de marché Amazon, le lieu de livraison demandé, l’identité du produit et l’heure de collecte en plus de la valeur extraite. Sinon, une modification des paramètres de la requête peut être interprétée comme un changement de prix.

La localisation de la livraison mérite une vérification distincte de la géolocalisation du proxy. Un paramètre « pays » peut sélectionner le lieu d’origine d’une requête ; un paramètre « code postal » peut contrôler le contexte de livraison affiché par la page. Consultez la documentation du point de terminaison pour savoir quel comportement chaque paramètre contrôle. Ne partez pas du principe que deux fournisseurs utilisent des noms de paramètres ou des significations identiques.

Définissez votre enregistrement avant de choisir la meilleure API de scraping Amazon. Pour une tâche de surveillance simple, voici un exemple de format interne, et non une réponse réelle provenant d’un fournisseur :

{
  "marketplace": "amazon.com",
  "requested_asin": "EXAMPL1234",
  "resolved_asin": "EXAMPL1234",
  "delivery_postcode": "10001",
  "observed_at": "2026-09-10T10:00:00Z",
  "price_text": "$24.99",
  "currency": "USD",
  "availability": "in_stock",
  "seller_id": null
}

L’ASIN et les valeurs ci-dessus sont fictifs et servent uniquement à illustrer la structure. Conservez l’identifiant demandé séparément de l’identifiant résolu afin qu’une variante redirigée ou sélectionnée ne devienne pas, sans que vous vous en rendiez compte, le même enregistrement. Conservez le prix affiché d’origine lors de la conversion en montant numérique.

Pour les comparaisons d’offres, ajoutez l’identité du vendeur, les frais de livraison, l’état de l’article et le contexte de l’offre dont vous avez besoin. Pour les résultats de recherche Amazon, conservez le contexte de la requête, de la page et de la position. Une réponse détaillée sur un produit et une ligne de résultats de recherche décrivent des observations différentes.

Déterminez ce que signifie une valeur manquante. Un prix nul peut représenter des données indisponibles ; il ne doit pas devenir une offre à zéro dollar. De même, le nombre d’évaluations n’est pas le même champ que le nombre d’avis écrits renvoyés.

Ces définitions facilitent l’évaluation de la meilleure API de scraping Amazon, car chaque candidate doit respecter le même contrat de données.

Comparez le coût par enregistrement exploitable

Le quota de crédits indiqué dans un forfait ne correspond pas au nombre d’enregistrements de produits finis. Le choix du point de terminaison, les paramètres de rendu, les demandes d’offres supplémentaires et vos propres résultats rejetés peuvent modifier la quantité utile que vous obtenez.

Par exemple, la requête de produit allégée documentée dans la liste restreinte coûte cinq crédits, tandis que le rendu complet en coûte quinze. Il s’agit là d’une différence de configuration au sein d’un même service. Les crédits de différents fournisseurs ne sont pas des unités de valeur interchangeables.

Utilisez deux calculs pour votre comparaison :

API cost per accepted record = API spend / accepted records
Effective cost per accepted record =
  (API spend + storage + allocated operating work) / accepted records

Voici un exemple hypothétique, qui ne correspond pas aux tarifs d’un fournisseur. L’option A coûte 30 $ pour un essai produisant 8 000 enregistrements acceptés. Son coût API est de 3,75 $ pour 1 000 enregistrements acceptés. L’option B coûte 40 $ et génère 12 000 enregistrements acceptés, soit environ 3,33 $ pour 1 000. Dans cet exemple, la facture la plus élevée correspond à un coût unitaire inférieur.

Veillez à ce que le dénominateur reste cohérent. Comparer les pages de produits d’un fournisseur avec chaque ligne de résultats de recherche d’un autre donne un chiffre trompeur. Déterminez si vous achetez une observation de produit, une offre ou un résultat de recherche, et ne comptez que les enregistrements qui respectent les mêmes règles.

Avant de vous engager, examinez les modalités de facturation des points de terminaison, le traitement des requêtes échouées, la concurrence, les crédits inutilisés et les conditions relatives au dépassement de quota. Renseignez-vous sur la manière dont est facturée une page récupérée avec succès mais incomplète. Vérifiez les détails du forfait actuel plutôt que de réutiliser les prix d’un ancien récapitulatif.

La meilleure API de scraping Amazon adaptée à votre budget minimise le coût des données exploitables tout en garantissant la fraîcheur dont vous avez besoin. Elle n’est pas nécessairement celle qui propose l’abonnement mensuel le moins cher ni celle qui annonce le quota le plus élevé.

Effectuez un petit test avant de faire votre choix

Soumettez chaque candidat à la même charge de travail. Un test axé sur un seul produit populaire ne vous permettra pas de déterminer si un service prend en charge vos catégories, vos places de marché et vos cas limites.

Créez un échantillon représentatif du projet : des produits courants, des produits avec des variantes, des articles indisponibles, ainsi que les pages de recherche ou d’offres dont vous avez besoin. Incluez chaque marketplace requise et chaque contexte de livraison. Choisissez une taille d’échantillon gérable pour l’inspection manuelle et votre quota d’essai disponible ; il n’existe pas de chiffre universel garantissant la fiabilité.

Utilisez cette fiche d’évaluation pour sélectionner la meilleure API de scraping Amazon :

Vérifier

Accepter lorsque

À examiner lorsque

Identité

Les produits demandés et renvoyés correspondent à votre règle

Une variante ou une redirection modifie l'article

Emplacement

Le marché et le contexte de livraison correspondent

Le résultat reflète un emplacement par défaut

Champs obligatoires

Les valeurs sont présentes et pertinentes

Un prix est manquant ou une offre manque de contexte

Actualité

L'observation correspond à la période de collecte requise

Les résultats mis en cache ou différés ne sont pas adaptés

Achèvement

Les tâches attendues atteignent un état final enregistré

Les soumissions ou les lots partiels restent en suspens

Coût

La facturation peut être liée aux observations acceptées

Le nombre de requêtes masque les données rejetées

Effectuez la même validation sur chaque réponse. Distinguez les échecs de transport, le contenu de page inattendu, les échecs d’analyse syntaxique et les échecs liés aux règles métier. Une réponse qui arrive correctement mais contient un produit erroné doit échouer au contrôle d’identité, même s’il s’agit d’un JSON valide.

Inspectez un sous-ensemble par rapport à la page affichée en utilisant des paramètres de localisation équivalents et une heure de collecte proche. Enregistrez suffisamment de contexte pour expliquer les différences ultérieurement. Pour les valeurs évoluant rapidement, une page consultée bien plus tard ne constitue qu’une preuve faible que l’enregistrement antérieur était erroné.

Mesurez le temps d’achèvement depuis le début de la collecte jusqu’à ce que des enregistrements exploitables soient disponibles. Pour les systèmes asynchrones, incluez la mise en file d’attente et la récupération des résultats. Si vous signalez une latence, incluez la charge de travail, la fenêtre d’observation et le comportement de « slow-tail » plutôt que de vous limiter à une moyenne.

Répétez l’échantillonnage à un autre moment pertinent avant de considérer le résultat comme stable. Considérez les résultats des essais comme des observations concernant cette charge de travail, et non comme des garanties pour toutes les pages Amazon. C’est la méthode pratique pour identifier la meilleure API de scraping Amazon pour un projet spécifique sans se fier aux classements généraux avancés par les fournisseurs.

Planifier le workflow de collecte

Une fois que l’essai produit des enregistrements fiables, définissez le mode de fonctionnement de la tâche récurrente. Séparez la découverte de l’actualisation : trouver de nouvelles URL de produits ou de nouveaux ASIN est une tâche différente de la révision d’une liste connue.

Pour la surveillance des prix, attribuez un intervalle de rafraîchissement qui corresponde à la décision étayée par les données. Regroupez les tâches par place de marché et par contexte de requête afin que la configuration reste explicite. Évitez d’augmenter la fréquence simplement parce que des capacités de traitement simultané supplémentaires sont disponibles.

Conservez une trace de chaque observation planifiée et de son résultat final. Une nouvelle tentative doit mettre à jour l’état de la tâche sans créer en silence des observations métier en double. Limitez les nouvelles tentatives, conservez le contexte utile des erreurs et rendez les tâches épuisées visibles pour la personne chargée de la collecte.

Si un fournisseur transmet ses résultats via des callbacks, prévoyez des notifications répétées et un achèvement différé. Stockez l’identifiant de tâche du fournisseur à côté de votre identifiant de tâche interne. Ce lien aide les équipes d’assistance à analyser un lot ayant échoué sans avoir à deviner quelle requête en est à l’origine.

Gérez les versions de vos règles de normalisation. Une modification du mappage des champs doit pouvoir être distinguée d’une modification des données source. Conservez le contexte nécessaire au débogage tout en définissant une politique de conservation réfléchie pour les réponses stockées.

Enfin, attribuez la responsabilité des modifications apportées au parseur, de la vérification de la facturation et des tâches incomplètes. La meilleure API de scraping Amazon réduit le travail nécessaire à l’obtention des données, mais quelqu’un doit tout de même décider si les observations obtenues sont adaptées à l’application. Intégrez cette décision au flux de travail avant de faire évoluer la collecte.

Points clés à retenir

  • Choisissez d’abord le contrat de sortie. Le contenu des pages, les champs de produit analysés, les offres des vendeurs et les tâches de collecte terminées répondent à différentes parties de la tâche. Comparez les points de terminaison qui répondent à la même exigence.
  • Conservez le contexte du produit et de la localisation pour chaque observation. Un enregistrement de prix exploitable nécessite plus qu’une simple valeur ; l’article demandé, la variante sélectionnée, la place de marché et l’heure de collecte permettent de l’interpréter.
  • Calculez le coût à partir des enregistrements acceptés. Intégrez les modifications de configuration et les résultats rejetés dans l’évaluation, puis tenez compte du travail que votre équipe devra encore effectuer.
  • Considérez un test comme une preuve relative à une charge de travail définie. Utilisez les mêmes données d’entrée et les mêmes vérifications pour chaque candidat, examinez les échecs et répétez l’échantillon avant de vous fier aux résultats.

FAQ

Puis-je récupérer l’historique des prix à l’aide d’un nouveau scraping ?

Une nouvelle observation ne permet pas de déterminer ce qu’affichait une page le mois dernier. Si vous avez besoin d’une série historique, collectez et horodatez les observations au fil du temps ou évaluez un ensemble de données historiques distinct dont la couverture est documentée. Faites la distinction entre le moment où un fournisseur a collecté une valeur et celui où vous l’avez téléchargée. Ne comblez pas les dates manquantes en présentant le prix d’aujourd’hui comme une observation antérieure.

Comment dois-je protéger mes identifiants d’API ?

Conservez vos identifiants dans un magasin de secrets côté serveur ou dans la configuration de l’environnement. Évitez de les intégrer dans le code du navigateur, des feuilles de calcul partagées, des captures d’écran ou des référentiels publics. Masquez les identifiants dans les journaux de requêtes, en particulier lorsqu’une API utilise une authentification par chaîne de requête. Limitez l’accès aux personnes et aux services chargés de la collecte, et remplacez une clé si elle a été exposée.

Les nombres de notes collectées peuvent-ils m’indiquer les ventes exactes ?

Non. Les nombres de notes et les totaux de ventes sont des mesures différentes. La relation que vous établissez entre eux constitue un modèle d’estimation, et non un enregistrement de ventes extrait. Si vous utilisez un tel modèle, indiquez clairement que le résultat est une estimation et expliquez ses hypothèses. Séparez les champs source observés des métriques calculées afin que les lecteurs puissent distinguer les valeurs provenant directement de la collecte.

Comment faciliter le changement de fournisseur ?

Conservez les paramètres de requête et les mappages de réponse spécifiques à chaque fournisseur au sein d’une petite frontière d’intégration. Stockez un format d’enregistrement interne stable et testez chaque mappage par rapport à des réponses enregistrées représentatives. Lors du remplacement d’un fournisseur, comparez la signification des champs ainsi que leurs noms. Documentez explicitement les différences au lieu de forcer une nouvelle réponse à s’insérer dans un ancien champ dont la signification a changé.

Conclusion

La meilleure API de scraping Amazon est celle qui fournit les données dont votre projet a besoin, avec un coût et un modèle d’exploitation que vous pouvez maintenir. Commencez par le résultat attendu : une fiche produit, une offre de vendeur, un résultat de recherche ou le contenu d’une page pour un analyseur syntaxique existant. Précisez ensuite clairement le contexte de la requête et les règles d’acceptation.

Utilisez la liste restreinte pour sélectionner un petit nombre de candidats répondant à ces exigences. Testez le même échantillon avec chacun d’entre eux, examinez les fiches renvoyées et calculez le coût des résultats acceptés. Distinguez clairement les capacités documentées de ce que démontre la version d’essai. Cette distinction vous aidera à faire un choix justifiable à mesure que votre charge de travail augmentera.

Si la récupération de pages gérée correspond à votre architecture, évaluez l’API Scraper de WebScrapingAPI à l’aide d’URL Amazon représentatives et de vos propres règles d’extraction. Utilisez la même liste de contrôle d’acceptation que celle que vous appliquez aux points de terminaison Amazon dédiés afin que la décision reflète le travail dont votre application a réellement besoin.

Avant d’étendre la tâche, enregistrez l’échantillon, ses paramètres et les règles de validation. Ces éléments deviendront votre référence lorsqu’un point de terminaison changera, qu’un champ disparaîtra ou qu’un futur fournisseur viendra s’ajouter à la comparaison.

À propos de l'auteur

Robert Sfichi, Développeur full-stack @ WebScrapingAPI

Robert Sfichi

Développeur full-stack

Robert Sfichi fait partie de l'équipe de WebScrapingAPI ; il contribue au développement du produit et aide à mettre en place des solutions fiables au service de la plateforme et de ses utilisateurs.

Alternative Data Scraping for Finance : Comment les données Web donnent un avantage aux investisseurs
Cas d'utilisation

Alternative Data Scraping for Finance : Comment les données Web donnent un avantage aux investisseurs

TL;DR: Le scraping de données alternatives utilise des techniques de collecte sur le web pour rassembler des ensembles de données non traditionnelles (prix des produits, sentiments, offres d'emploi, dépôts réglementaires) qui révèlent les signaux du marché avant qu'ils n'apparaissent dans les rapports sur les bénéfices. Ce guide vous présente les sources de données les plus précieuses, la manière de construire des pipelines de qualité financière, la validation de la qualité des données et les garde-fous de la conformité dont vous avez besoin pour rester du bon côté de la loi.

Mihnea-Octavian Manolache20 min read
Lire l'article
Qu'est-ce que les données financières ? Types, méthodes de collecte et outils d'analyse
Cas d'utilisation

Qu'est-ce que les données financières ? Types, méthodes de collecte et outils d'analyse

TL;DR: Les données financières sont la collection d'enregistrements quantitatifs (revenus, dépenses, actifs, passifs, flux de trésorerie) que les organisations et les individus utilisent pour prendre des décisions économiques éclairées. Ce guide présente les quatre principaux états financiers, compare les sources de données traditionnelles et alternatives, présente les méthodes de collecte modernes et couvre les outils utilisés par les professionnels pour l'analyse.

Suciu Dan16 min read
Lire l'article
Sélecteurs XPath et CSS : Choisir le bon
Cas d'utilisation

Sélecteurs XPath et CSS : Choisir le bon

TL;DR: XPath et les sélecteurs CSS localisent tous deux des éléments du DOM, mais ils résolvent des problèmes différents. Les sélecteurs CSS sont plus rapides et plus lisibles pour les sélections simples. XPath l'emporte lorsque vous devez parcourir le DOM dans n'importe quelle direction, faire correspondre du contenu textuel ou gérer une logique conditionnelle complexe. La plupart des projets de production bénéficient de l'utilisation des deux stratégies.

Mihai Maxim16 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.