Aller au contenu

Blog

Perspectives et ingénierie

Une analyse approfondie de l'infrastructure des données Web, des techniques d'extraction et de l'avenir des données structurées à grande échelle.

Derniers articles

156 articles

Les meilleurs cours de web scraping pour développeurs
Les techniques de web scraping

Les meilleurs cours de web scraping pour développeurs

TL;DR: Les meilleurs cours de web scraping dépendent de votre langue, de votre niveau et de votre cas d'utilisation. Ce guide compare cinq choix payants parmi Udemy, Coursera, DataCamp et Packt, indique les compléments gratuits comme les documents officiels, et montre comment passer de la fin d'un cours à l'exécution de scrapers de production.

Ștefan Răcilă13 min read
Lire l'article
Scraper Realtor.com : guide pratique 2026
Guides

Scraper Realtor.com : guide pratique 2026

TL;DR: Si vous cherchez à scraper proprement Realtor.com, trois choses comptent le plus : des sélecteurs stables qui survivent à leurs noms de classe hachés, une couche de requête qui survit à la protection anti-bot de Realtor, et un code qui parcourt à la fois les pages de listes et les pages de détails. Ce guide est la version complète de Python, avec des tactiques anti-blocage et des exportations prêtes pour LLM.

Raluca Penciuc15 min read
Lire l'article
Web Scraping Booking.com : Hôtels, prix et avis (Guide 2026)
Guides

Web Scraping Booking.com : Hôtels, prix et avis (Guide 2026)

TL;DR: Ce guide présente le web scraping de Booking.com de bout en bout en Python : extraction des listes de recherche, des pages d'hôtels, des prix de nuit, et des avis des clients. Vous obtiendrez deux méthodes complémentaires : un workflow Selenium Wire pour les pages rendues en JS et un chemin plus rapide qui appelle directement le point de terminaison interne /dml/graphql de Booking.com, plus un playbook anti-blocage, la gestion des devises, et une solution de contournement pour le plafond de pagination d'environ 1000 résultats.

Raluca Penciuc16 min read
Lire l'article
La décentralisation à son meilleur : le modèle DAO d'ice Network face au manque de contrôle des utilisateurs sur Pi Network
Ingénierie

La décentralisation à son meilleur : le modèle DAO d'ice Network face au manque de contrôle des utilisateurs sur Pi Network

TL;DR: Après avoir compris la différence entre deux modèles DAO distincts en matière de décentralisation, nous examinons aujourd’hui deux réseaux similaires mais totalement différents : ICE et Pi.

Anda Miuțescu11 min read
Lire l'article
Comment récupérer des données sur Idealista : Un guide pour 2026
Guides

Comment récupérer des données sur Idealista : Un guide pour 2026

TL;DR: Idealista est la plus grande place de marché immobilière d'Espagne, d'Italie et du Portugal, mais une protection anti-bot sérieuse y bloque vite les scrapers naïfs. Ce guide explique comment extraire les données d'Idealista de bout en bout en Python : cartographie du site, Selenium avec undetected-chromedriver, gestion de DataDome, rotation de proxys et exportations propres, avec le durcissement pour la production que les concurrents négligent souvent.

Raluca Penciuc17 min read
Lire l'article
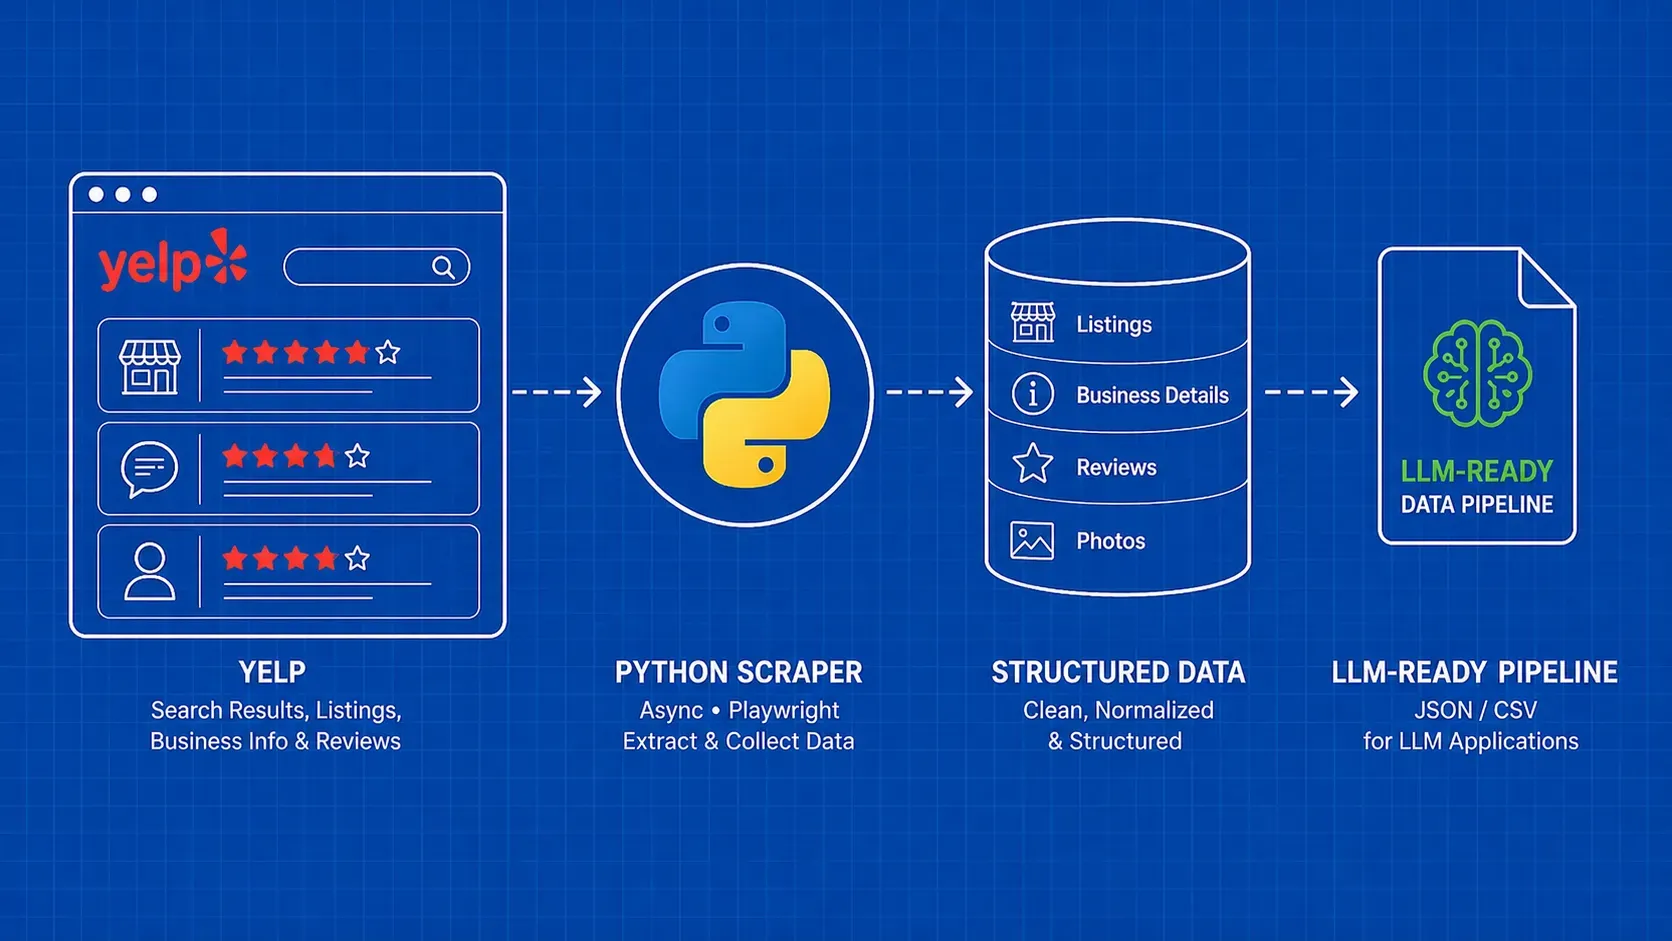
Comment gratter Yelp avec Python : Critiques, listes et pipelines de données prêts pour le LLM
Guides

Comment gratter Yelp avec Python : Critiques, listes et pipelines de données prêts pour le LLM

TL;DR: Ce guide vous accompagne dans la construction d'un scraper Yelp complet en Python, couvrant les résultats de recherche, les détails de l'entreprise et les commentaires avec un code fonctionnel. Vous apprendrez également à gérer les protections anti-bot, à exporter les données au format CSV ou JSON, et à intégrer les commentaires dans un LLM pour l'analyse des sentiments, ce qu'aucun autre tutoriel sur le scraping Yelp ne couvre.

Raluca Penciuc16 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.