
Aller au contenu

Blog

Perspectives et ingénierie

Une analyse approfondie de l'infrastructure des données Web, des techniques d'extraction et de l'avenir des données structurées à grande échelle.

Derniers articles

156 articles

Guide de l'API de scraping des SERP : Google, Bing, DuckDuckGo, Yandex
Guides

Guide de l'API de scraping des SERP : Google, Bing, DuckDuckGo, Yandex

TL;DR: Envoyez votre première requête à l'API SERP de WebScrapingAPI en indiquant la clé dans une variable d'environnement, puis localisez les résultats Google par pays, langue et appareil, lisez les données JSON de Google et Bing de manière défensive, extrayez vous-même le code HTML de DuckDuckGo et Yandex, exécutez des tâches Google asynchrones, effectuez des tentatives de réessai en fonction des codes d'erreur documentés, et choisissez une formule tarifaire en vous basant sur les tarifs de Google en vigueur en octobre 2026.

Suciu Dan25 min read
Lire l'article
Comment utiliser l'API Amazon Scraper : guide de démarrage rapide
Guides

Comment utiliser l'API Amazon Scraper : guide de démarrage rapide

TL;DR: Lancez-vous avec l'API Amazon Scraper de WebScrapingAPI : envoyez votre première requête, choisissez parmi neuf types de requêtes (produits, recherche, meilleures ventes, offres promotionnelles, avis sur les vendeurs, etc.), ciblez 20 places de marché Amazon, analysez chaque réponse JSON, gérez les erreurs et les nouvelles tentatives, puis choisissez la formule qui vous convient.

Robert Sfichi25 min read
Lire l'article
Scrapy vs Selenium : Qui gagne ?
Les techniques de web scraping

Scrapy vs Selenium : Qui gagne ?

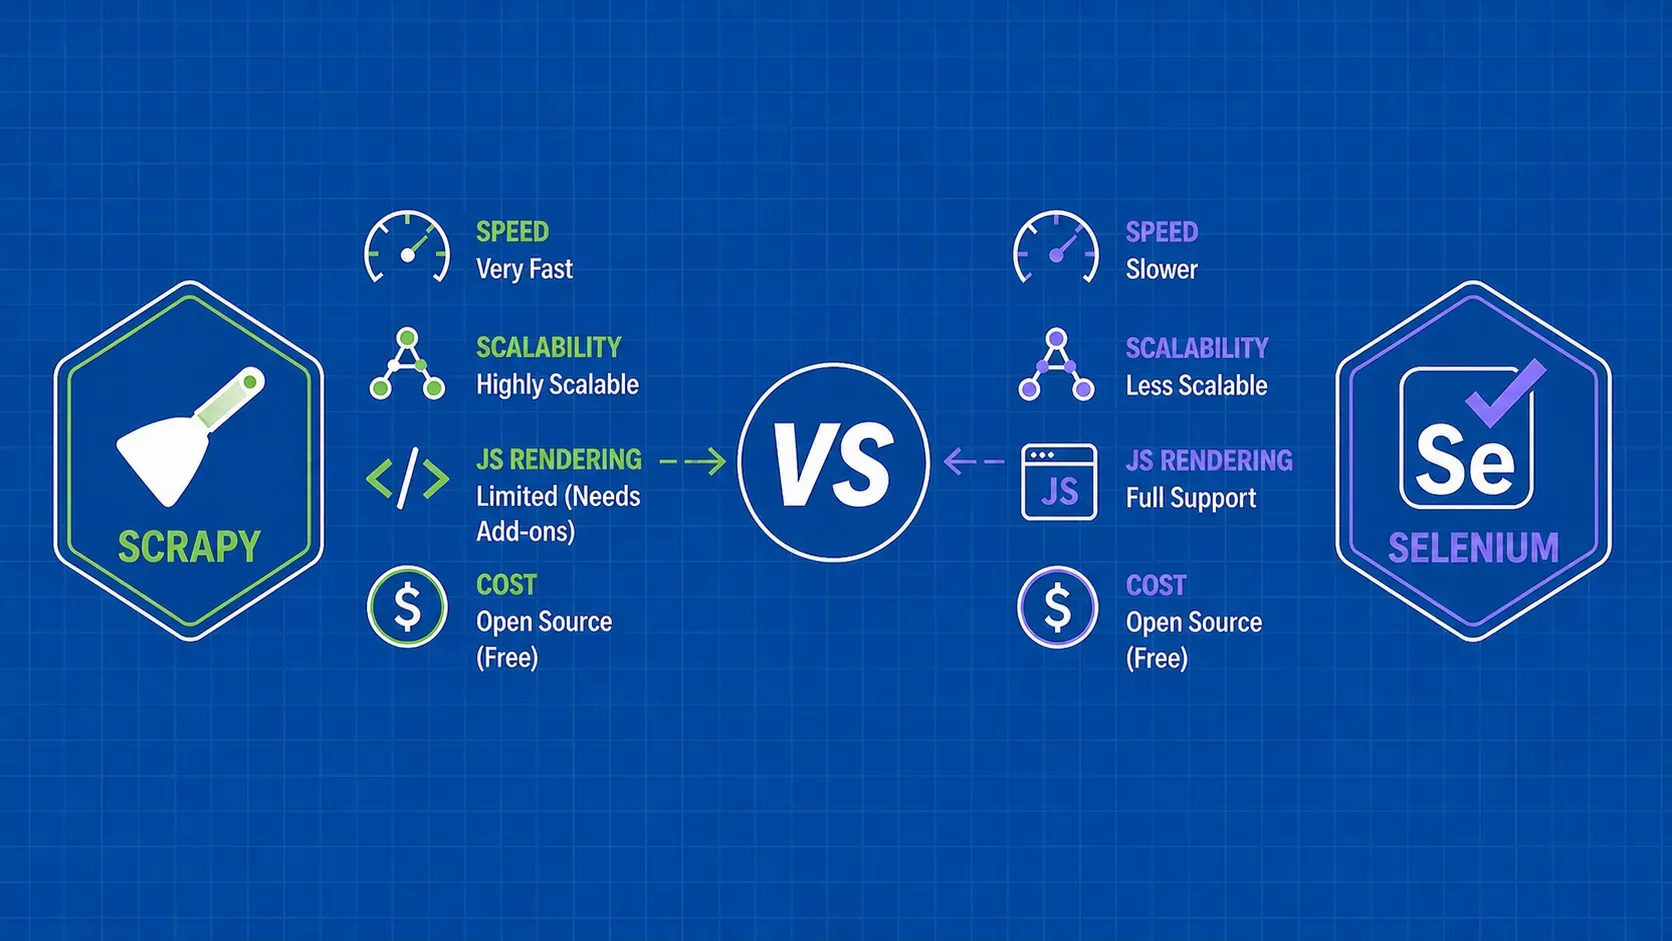
TL;DR: Scrapy est un cadre de crawling asynchrone à grande vitesse conçu pour extraire des données structurées à partir de pages statiques à grande échelle. Selenium automatise les navigateurs réels et gère les sites à forte composante JavaScript, mais à un coût en ressources beaucoup plus élevé. La plupart des projets de scraping en production gagnent à savoir quand utiliser l'un ou l'autre, ou quand les combiner.

Gabriel Cioci11 min read
Lire l'article
Scrapy vs Beautiful Soup : Quel scraper Python choisir ?
Guides

Scrapy vs Beautiful Soup : Quel scraper Python choisir ?

TL;DR: Scrapy est un framework de crawling complet qui gère les requêtes, l'analyse et l'exportation des données en un seul package. Beautiful Soup est une bibliothèque d'analyse légère que vous associez à un client HTTP comme les requêtes. Choisissez Scrapy lorsque vous avez besoin d'un crawling concurrent à grande échelle avec des pipelines intégrés. Choisissez Beautiful Soup lorsque vous souhaitez une configuration rapide et minimale pour analyser une poignée de pages.

Mihnea-Octavian Manolache13 min read
Lire l'article
Tutoriel Scrapy Splash : Rendre des pages JavaScript
Guides

Tutoriel Scrapy Splash : Rendre des pages JavaScript

TL;DR: Scrapy Splash associe le moteur d'exploration rapide de Scrapy au navigateur sans tête Splash pour rendre les pages lourdes en JavaScript. Ce tutoriel scrapy splash vous guide à travers l'installation de Docker, la configuration du projet Scrapy, les bases de SplashRequest, les scripts Lua pour le défilement et le clic, l'intégration du proxy, et la correction des erreurs les plus courantes que vous rencontrerez.

Ștefan Răcilă13 min read
Lire l'article
Récupérer les données des produits Amazon avec Python : Guide pratique
Guides

Récupérer les données des produits Amazon avec Python : Guide pratique

TL;DR: Les pages de produits Amazon regorgent de données précieuses (prix, évaluations, commentaires, ASIN), mais les extraire de manière fiable nécessite plus qu'une simple requête HTTP. Ce guide vous aide à construire un scraper Python avec Requests et BeautifulSoup, à gérer la pagination et les défenses anti-bots, à exporter au format CSV ou JSON, et à introduire les résultats dans les flux de travail LLM. Vous apprendrez également quand utiliser une API de scraping au lieu de développer votre propre solution.

Raluca Penciuc19 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.