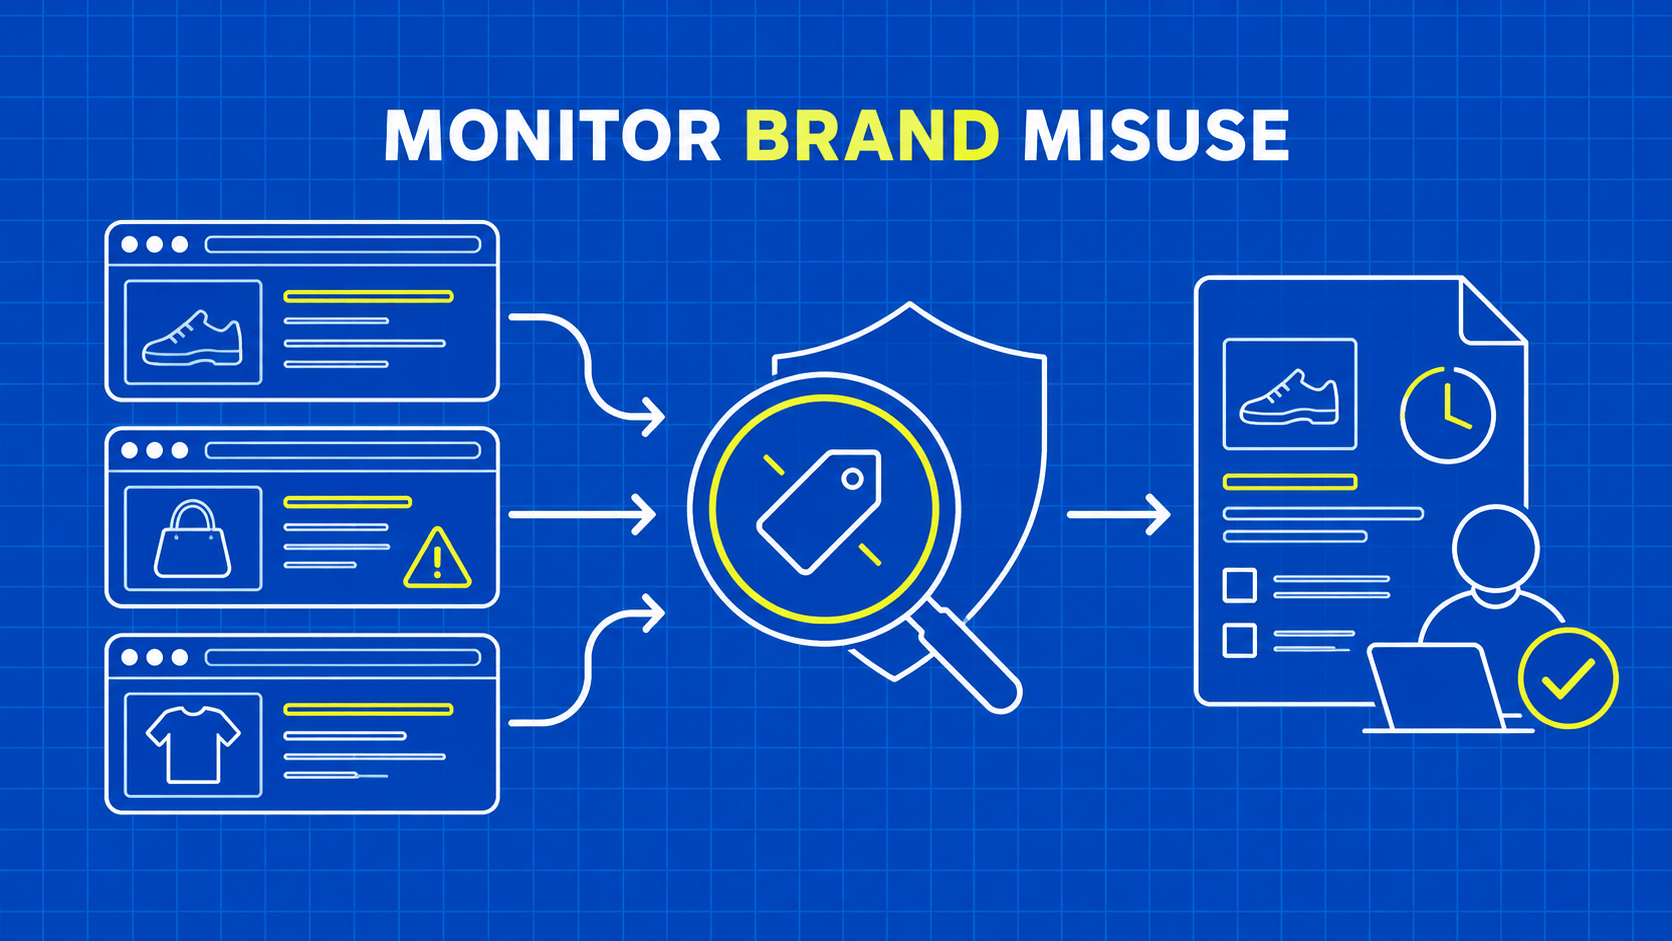
En bref : le web scraping pour la protection de marque aide les équipes à repérer et à suivre les annonces qui méritent une enquête. Comparez les observations aux référentiels de produits et de vendeurs approuvés, conservez des preuves datées et transmettez des dossiers explicables à des réviseurs humains, plutôt que de déclarer automatiquement un produit contrefait ou de déposer des plaintes.
Le web scraping pour la protection de marque consiste à collecter automatiquement des informations en ligne sur les produits, les vendeurs et l'usage d'une marque afin d'appuyer la surveillance et les enquêtes. Le résultat utile est un dossier de revue étayé par des preuves : ce qui a changé, où cela est apparu, avec quelle fiche de référence cela entre en conflit et ce qu'un réviseur doit vérifier ensuite.
Le suivi des prix, les études de marché et la génération de leads côtoient la surveillance de marque parmi les cas d'usage du web scraping en entreprise.
Imaginez une photo de produit familière qui apparaît dans une nouvelle annonce sur une marketplace. Le prix est anormalement bas et le vendeur ne figure pas dans votre base de distributeurs. Cette combinaison mérite qu'on s'y arrête, mais elle ne prouve pas que le produit est contrefait. L'article peut être d'occasion, la fiche du vendeur peut être incomplète, ou l'annonce peut décrire un autre conditionnement.
Un bon système de surveillance conserve ces nuances. Il réduit le temps nécessaire pour trouver et examiner les candidats sans transformer des observations incomplètes en accusations. Ce guide montre comment construire ce système : établir un référentiel, découvrir des candidats, créer des identités d'annonce stables, capturer des preuves, hiérarchiser la revue et assurer le suivi via les procédures de signalement officielles. La mise en œuvre porte sur la qualité des données et la traçabilité que maîtrisent les développeurs. Les jugements juridiques et les décisions de mise en application restent du ressort des personnes responsables.