Aller au contenu

Blog

Perspectives et ingénierie

Une analyse approfondie de l'infrastructure des données Web, des techniques d'extraction et de l'avenir des données structurées à grande échelle.

Derniers articles

156 articles

En-têtes HTTP Web Scraping : Ne plus être bloqué
Les techniques de web scraping

En-têtes HTTP Web Scraping : Ne plus être bloqué

TL;DR: Les en-têtes HTTP sont généralement la raison pour laquelle votre scraper obtient un 403 alors que votre navigateur charge la même URL sans problème. Ce guide montre quels en-têtes les systèmes anti-bots inspectent réellement, comment capturer le jeu d'en-têtes d'un vrai navigateur à partir de DevTools, comment les envoyer et les faire pivoter correctement en Python et Node.js, et quand le réglage manuel cesse d'être payant et qu'une API de scraping gérée est la meilleure solution.

Raluca Penciuc15 min read
Lire l'article
Analyseurs HTML et XML en Ruby : une comparaison basée sur la charge de travail
Guides

Analyseurs HTML et XML en Ruby : une comparaison basée sur la charge de travail

TL;DR: En bref : choisissez vos analyseurs HTML et XML en Ruby en fonction de la charge de travail, et non d'un classement générique. Commencez par Nokogiri pour l'analyse générale des arborescences HTML et XML, envisagez Ox ou LibXML Ruby pour les tâches spécifiques à l'XML, et n'ajoutez Selenium que lorsqu'un véritable navigateur doit afficher la page ou interagir avec celle-ci.

Raluca Penciuc15 min read
Lire l'article
Erreurs liées à l'état du proxy : diagnostic de l'étape de la requête ayant échoué
Guides

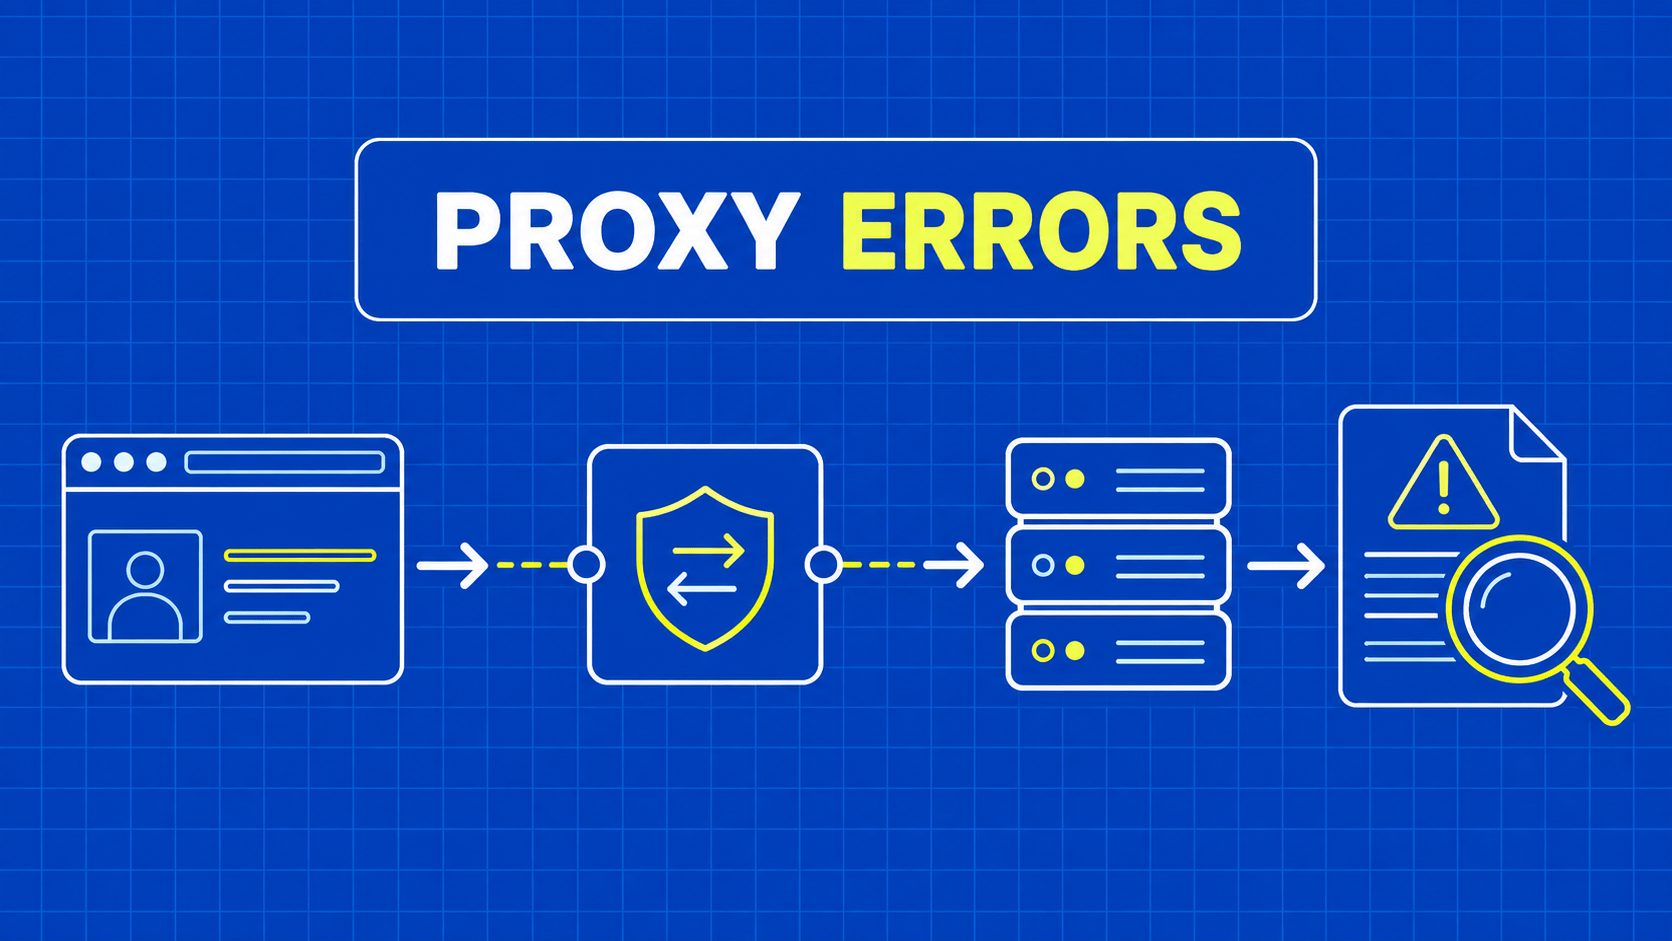
Erreurs liées à l'état du proxy : diagnostic de l'étape de la requête ayant échoué

TL;DR: Identifiez le saut qui a échoué avant de réessayer une requête proxy. Utilisez les codes d'état, les résultats de la requête CONNECT et les enregistrements de diagnostic sécurisés pour distinguer les échecs du proxy des réponses de la cible.

Mihai Maxim17 min read
Lire l'article
Comment extraire les données d'un tableau HTML en JavaScript et exporter un fichier CSV propre
Guides

Comment extraire les données d'un tableau HTML en JavaScript et exporter un fichier CSV propre

TL;DR: En bref : commencez par déterminer si les lignes du tableau figurent dans la réponse HTTP, proviennent d’une requête de données ou nécessitent un rendu par le navigateur. Utilisez ensuite le script statique Axios et Cheerio ou la méthode Puppeteer spécifique décrite ci-dessous pour extraire le contenu d’un tableau HTML en JavaScript, valider les enregistrements en fonction des en-têtes, dédupliquer les pages et générer un fichier CSV en toute sécurité. Un tableau HTML organise les informations en lignes et en colonnes, généralement à l'aide des éléments <table>, <tr>, <th> et <td>. Extraire un tableau HTML en JavaScript consiste à récupérer ou à afficher ce balisage, à convertir chaque ligne de données en un objet JavaScript, à valider le résultat et à le sérialiser dans un format tel que le CSV.

Mihai Maxim15 min read
Lire l'article
Analyse HTML en Java avec Jsoup
Guides

Analyse HTML en Java avec Jsoup

TL;DR: Jsoup est la bibliothèque par défaut pour l'analyse HTML en Java. Ce guide présente le cycle de vie complet (installation de Maven, chargement d'un document, sélecteurs CSS, traversée du DOM, extraction, modification et sérialisation), ainsi qu'un projet de scraping exécutable, la gestion des erreurs, la pagination et les limites qui vous poussent vers un navigateur sans tête ou une API de scraping.

Mihai Maxim14 min read
Lire l'article
Python Extraire du texte à partir de HTML
Guides

Python Extraire du texte à partir de HTML

TL;DR: Pour extraire du texte Python à partir de HTML, il faut analyser les balises avec un vrai analyseur (BeautifulSoup, lxml.html, ou html-text), supprimer les scripts, les styles et le chrome du site, puis normaliser les espaces blancs et l'Unicode avant de sauvegarder. Ce guide compare les principales bibliothèques, corrige les pièges de nettoyage les plus courants, et se termine par un crawler exécutable qui écrit du JSONL et des fichiers .txt par page.

Mihai Maxim27 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.