Aller au contenu

Blog

Perspectives et ingénierie

Une analyse approfondie de l'infrastructure des données Web, des techniques d'extraction et de l'avenir des données structurées à grande échelle.

Derniers articles

156 articles

Extraction de données sur le Web en C et C++ avec libcurl et lexbor
Guides

Extraction de données sur le Web en C et C++ avec libcurl et lexbor

TL;DR: Extrayez des données de sites web en C et C++ avec libcurl et lexbor : créez un robot d'indexation C++20 « poli » à l'aide de CMake et vcpkg, exportez des fichiers CSV et JSON propres, gérez les pages JavaScript de trois façons différentes et exécutez le même robot d'indexation en C pur.

Raluca Penciuc30 min read
Lire l'article
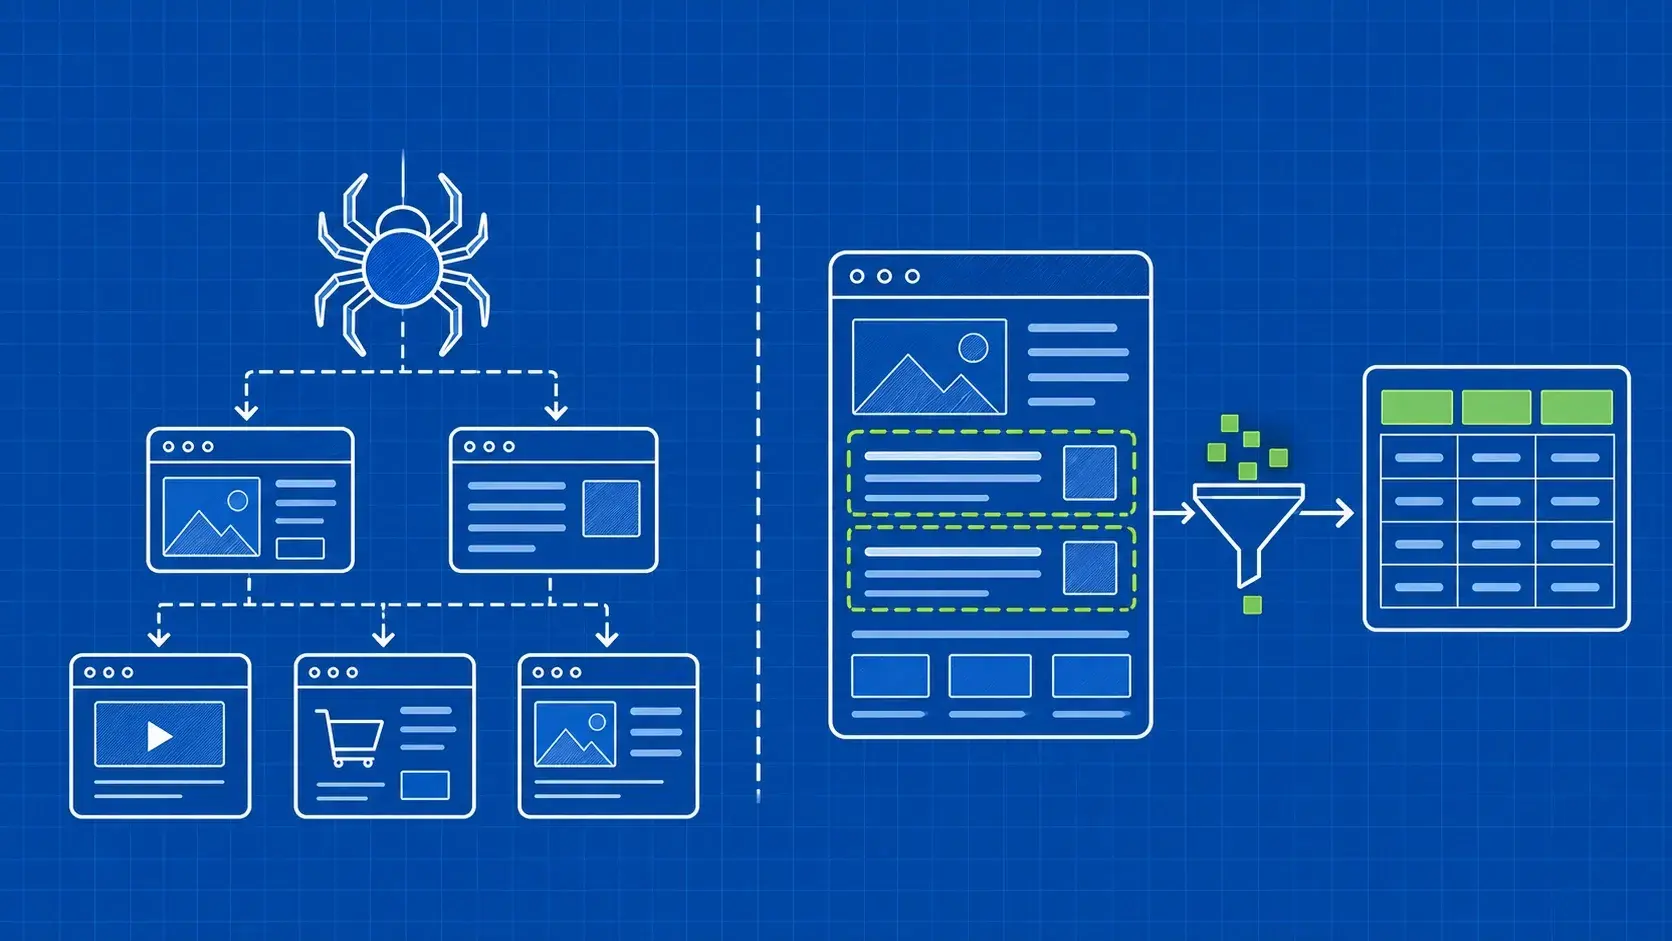
Web scraping ou web crawling : guide pour débutants
Les techniques de web scraping

Web scraping ou web crawling : guide pour débutants

TL;DR: Découvrez comment les robots d'indexation trouvent les pages et comment les outils de scraping extraient des données utiles. Prenez l'exemple d'une librairie, comparez leurs résultats et choisissez le workflow le mieux adapté à votre premier projet.

Anda Miuțescu14 min read
Lire l'article
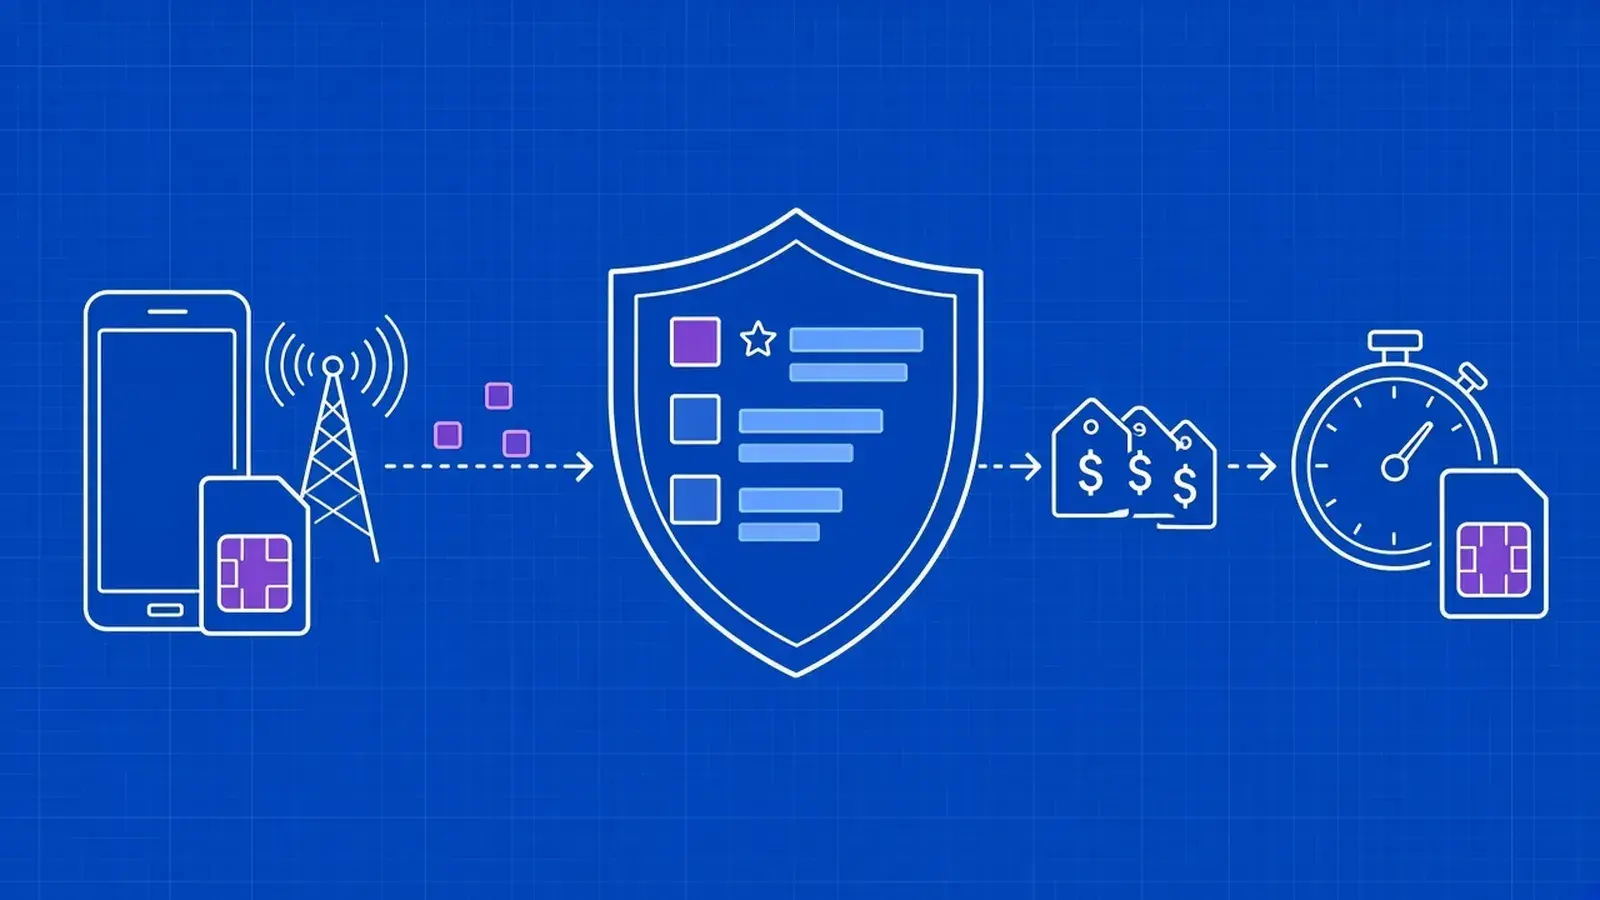
Meilleurs proxys mobiles pour le web scraping en 2026 : 9 fournisseurs classés
Les techniques de web scraping

Meilleurs proxys mobiles pour le web scraping en 2026 : 9 fournisseurs classés

TL;DR: Comparez 9 fournisseurs de proxys mobiles pour le scraping : prix au Go ou par port, ciblage opérateur et ASN, 5G, sessions persistantes et essais, en octobre 2026.

Sergiu Inizian28 min read
Lire l'article
Bonnes pratiques en matière de web scraping : un guide complet couvrant l'ensemble du cycle de vie, avec des conseils et du code fonctionnel
Les techniques de web scraping

Bonnes pratiques en matière de web scraping : un guide complet couvrant l'ensemble du cycle de vie, avec des conseils et du code fonctionnel

TL;DR: Bonnes pratiques en matière de web scraping pour chaque étape du cycle de vie d'un scraper : planifier les données, respecter le fichier robots.txt tel que défini par la norme RFC 9309, limiter la fréquence d'accès à chaque hôte et respecter l'en-tête Retry-After, effectuer un analyse défensive, valider chaque enregistrement, surveiller les exécutions, vérifier la progression et suivre le coût par enregistrement valide. Chaque étape est accompagnée d'un court extrait de code Python fonctionnel.

Anda Miuțescu36 min read
Lire l'article
Le web scraping au service du référencement naturel : réaliser un audit fondé sur des données concrètes
Cas d'utilisation

Le web scraping au service du référencement naturel : réaliser un audit fondé sur des données concrètes

TL;DR: Réalisez un audit SEO rigoureux qui distingue les données observées au niveau des pages des résultats des moteurs de recherche. Comparez le rendu, les signaux canoniques, les balises et les défauts des modèles.

Gabriel Cioci16 min read
Lire l'article
Conseils sur l'API REST pour une collecte de données fiable
Ingénierie

Conseils sur l'API REST pour une collecte de données fiable

TL;DR: Concevez des API que les collecteurs peuvent utiliser en toute fiabilité. Définissez la pagination, les tentatives de réessai, les validateurs, l'authentification, l'évolution des schémas et la récupération sous forme de contrats explicites.

Robert Sfichi18 min read
Lire l'article

Commencez à créer

Prêt à faire évoluer votre système de collecte de données ?

Rejoignez plus de 2 000 entreprises qui utilisent WebScrapingAPI pour extraire des données Web à l'échelle de l'entreprise, sans aucun coût d'infrastructure.